
第二十章 类型属性上的重载
我们知道,函数模板可以重载。类模板不可以。我们将要讨论如何实现这一类似行为
20.1 算法特化(重载)
这个部分非常直观。就是为某一个特定类型提供一个更为特化的算法实现。
template<typename T>void swap(T a, T b){ cout <<"T swap" << endl;}
template<typename T>void swap(vector<T> a, vector<T> b){ //针对vector类型提供的特化版本。 cout <<"vector T swap" << endl;}
int main(){ vector<int> a{1,2,3,4}; swap(1,2); swap(a, a); return 0;}- 但是不是所有的场合都能成功实现这一操作。
template<typename InputIter>void swap(InputIter a, InputIter b){ cout <<"InputIter swap" << endl;}template<typename RandomAccessIter>void swap(RandomAccessIter a, RandomAccessIter b){ cout <<"RandomAccessIter swap" << endl;}由于只有函数模板形参名字不同的函数模板不可以被重载,所以会有重定义问题。这时候我们可以使用标记派发。
20.2 标记派发/标记分派(tag dispatching)
可以同时参阅effective modern C++ 条款27 - 3
我们发现上一节中提到的例子,核心是只有函数模板形参名字不同的函数模板不可以被重载。那么我们可以让这个名字成为模板形参的一部分。也就是打标签。
- 下面的
tag其实就是传入一个对应特定类型的匿名对象。
//这部分迭代器分类套用标准库的一套。struct my_input_iterator_tag {};struct my_output_iterator_tag {};struct my_forward_iterator_tag : public my_input_iterator_tag {};struct my_bidirectional_iterator_tag : public my_forward_iterator_tag{};struct my_random_access_iterator_tag : public my_bidirectional_iterator_tag {};
//这部分模拟某一种迭代器。struct my_InputIter{ using IterType = my_input_iterator_tag; //迭代器里面有一个成员类型指明自己是哪一个迭代器类别。};struct my_RandomAccessIter{ using IterType = my_random_access_iterator_tag;};
//迭代器类型萃取template <typename Iter>struct IterTraits{ using IterType = typename Iter::IterType; //获取当前传入的迭代器的迭代器类别};
template<typename Iterator>void my_swapImpl(Iterator& x, Iterator& y){ //作为标签分派的转发函数。 my_swap(x, y, typename IterTraits<Iterator>::IterType()); //细节注意,使用typename指明是类型后,使用()生成对应类型的匿名对象。 //因为我们下面的标签是函数参数,需要一个对象。}
template<typename InputIter> //对应的具体swap函数。void my_swap(InputIter& a, InputIter& b, my_input_iterator_tag){ //第三个参数是tag。tag也是对象。 cout <<"InputIter swap" << endl;}
template<typename RandomAccessIter>void my_swap(RandomAccessIter& a, RandomAccessIter& b, my_random_access_iterator_tag){ cout <<"RandomAccessIter swap" << endl;}
int main(){
my_RandomAccessIter r1; my_RandomAccessIter r2; my_InputIter i1; my_InputIter i2;
my_swapImpl(r1, r2); my_swapImpl(i1, i2);
return 0;}- 标记派发非常适合用于有天然层次结构,并且拥有对应的萃取机制的情况。但是如果要依赖于专有类型属性的时候,比如某个类型是否有拷贝赋值,标记派发就不太方便了。
标签分派的实现可以有特化
struct a{};struct b{};struct c{};
template<typename T>struct Test{ static const int num = 0;};
template<>struct Test<a>{ static const int num = 1;};
template<>struct Test<b>{ static const int num = 2;};
template<>struct Test<c>{ static const int num = 3;};
int main(){ cout << Test<a>::num << endl; // 1 cout << Test<b>::num << endl; // 2 cout << Test<c>::num << endl; // 3}这种可以让你给某一个类型的标签进行特化。具体应用可以查看杂记5的让enum支持位运算。
20.3 Enable/Disable 启用或禁用函数模板
我们在第六章的时候讲了一些关于使用enable_if启用或禁用函数模板的例子。enable_if的核心其实就是在函数模板的偏序和重载机制上,再次强化选择的能力。
template<typename Iter> //变量模板。判断是否是random迭代器。这里有细节。为什么要用is_convertible而不用is_same?constexpr bool IsRandomAccessIter = is_convertible<typename IterTraits<Iter>::IterType, my_random_access_iterator_tag>::value;
template<typename Iter> //如果是randomtypename enable_if<IsRandomAccessIter<Iter>>::type process(Iter& a, Iter& b){ cout <<"IS random access iter" << endl;}template<typename Iter> //如果不是randomtypename enable_if<!IsRandomAccessIter<Iter>>::type process(Iter& a, Iter& b){ cout <<"NOT random access iter" << endl;}int main(){ cout << boolalpha; my_RandomAccessIter r1; my_RandomAccessIter r2; my_InputIter i1; my_InputIter i2; process(i1, i1); process(r1, r2); return 0;}- 细节为何要使用
is_convertible而不用is_same?- 这是关于语义的。迭代器属于拓展类语义。越子类功能越丰富。比如如果我们想要允许有ABC功能的对象使用此类,则应该也允许有ABCDE功能的对象使用此类。也就是允许当前类的子类使用。所以使用
is_convertible - 这里注意应当把子类放在第一个参数,父类放在第二个参数。因为是判断子类是否可以转为父类。(子转父。不能父转子)
- 这是关于语义的。迭代器属于拓展类语义。越子类功能越丰富。比如如果我们想要允许有ABC功能的对象使用此类,则应该也允许有ABCDE功能的对象使用此类。也就是允许当前类的子类使用。所以使用
- 第二是我们需要写两个版本。这是为了激活SFINAE特性。因为我们不仅要指明符合要求时应该使用的方法,也要指明不符合要求的时候应该使用的方法。也就是确保对任意一个需要比较的类型,都应该只有一个模板可以被激活。
20.3.1 提供多种特化版本(enable_if的坑点)
假如我们还要有一个额外的条件需要判断,比如判断是否满足A功能。则我们要添加更多的enable_if去区分每一个更细致的特化。因为需要让它们彼此互斥。
这就是enable_if的缺点。也就是随着条件增加,需要判断的条件越来越多,则需要越来越多的enable_if。
标记派发和enable_if通常适用于不同的两种情况。
- 标记派发可以基于分层的(具有天然结构性的)tags支持简单的派发(条件性选择)。
enable_if则是基于类型萃取获得的任意一组属性来支持更为复杂的派发。(之前提到的专有类型属性)
20.3.2 enable_if应该怎么用?
enable_if 通常被用于函数模板的返回类型。但是enable_if 本身不适用于:
- 构造函数模板
- 类型转换模板
因为它们都没有被指定返回类型。而且,使用 enable_if 也会使得返回类型很难被读懂。
解决办法就是把enable_if放入一个额外的模板参数中当做默认模板参数。
class Itertest{ public: Itertest() = default; template<typename Iter, typename = typename enable_if<IsRandomAccessIter<Iter>>::type> Itertest(Iter begin, Iter last){ cout <<"construct called Random" << endl; } template<typename Iter, typename = typename enable_if<!IsRandomAccessIter<Iter>>::type> //不可以。 Itertest(Iter begin, Iter last){ cout <<"construct called Otheriter" << endl; }
};- 但是这时候我们不能使用老方法重载。因为只有函数模板参数的默认值不同是无法重载的。因为默认参数不算做函数签名。
- 这个问题可以使用额外模板参数(dummy parameter)来解决。另一个方法是6.3中重定义问题中的 “让参数本身不同”。
template<typename Iter, typename = typename enable_if<!IsRandomAccessIter<Iter>>::type, typename = int> //第三个参数是dummy parameter。 Itertest(Iter begin, Iter last){ cout <<"construct called Otheriter" << endl;}20.4 类的特化
类模板的偏特化和函数模板的重载很像。
20.4.1 启用/禁用 类模板
这个就是6.6提到的enable_if嵌入到类模板形参。
template<typename T1, typename T2, typename = void>class myclass{
};
template<typename T1, typename T2>class myclass<T1, T2, enable_if<....>>{
};20.4.2 类模板的标记派发
这个明显较为复杂。注意,这不是CRTP。
我们的核心还是要在不同的模板特化中做选择。我们沿用迭代器的例子。
//-------可替换部分---------template<typename...> //1struct GetBestMatch{};
template<> //2struct GetBestMatch<>{ //3 static void match(...); //4};//----------可以把上面的两个换成下面的一个。区别下面说--------------template<typename...>struct GetBestMatch{ static void match(...);};
//----------------------------
template<typename T1, typename... Args> //5struct GetBestMatch<T1, Args...>: public GetBestMatch<Args...>{ //6 static T1 match(T1){ //7
} GetBestMatch(){ //测试函数签名用 std::puts(__PRETTY_FUNCTION__); } using GetBestMatch<Args...>::match; //8};
template<typename T1, typename... Args>struct GetBestMatchT{ using Type = decltype(GetBestMatch<Args...>::match(declval<T1>())); //9};
template<typename T1, typename... Args>using GetBestMatchValue = typename GetBestMatchT<T1, Args...>::Type; //10
template<typename Iter, typename tag = GetBestMatchValue <typename IterTraits<Iter>::IterType, my_bidirectional_iterator_tag, my_forward_iterator_tag, my_input_iterator_tag, my_output_iterator_tag, my_random_access_iterator_tag>> //11class myoperation{};
template<typename Iter>class myoperation<Iter, my_input_iterator_tag>{ public: void func(Iter& iter){ cout << "input iter" << endl; }};
template<typename Iter>class myoperation<Iter, my_random_access_iterator_tag>{ public: void func(Iter& iter){ cout <<"random iter" << endl; }};int main(){
my_RandomAccessIter r1; my_RandomAccessIter r2; my_InputIter i1; my_InputIter i2; myoperation<my_InputIter> obj; obj.func(i1); myoperation<my_RandomAccessIter> obj2; obj2.func(r1); GetBestMatch<my_InputIter, my_bidirectional_iterator_tag, my_forward_iterator_tag, my_input_iterator_tag, my_output_iterator_tag, my_random_access_iterator_tag> test; return 0;}GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_random_access_iterator_tag; Args = {}]GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_output_iterator_tag; Args = {my_random_access_iterator_tag}]GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_input_iterator_tag; Args = {my_output_iterator_tag, my_random_access_iterator_tag}]GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_forward_iterator_tag; Args = {my_input_iterator_tag, my_output_iterator_tag, my_random_access_iterator_tag}]GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_bidirectional_iterator_tag; Args = {my_forward_iterator_tag, my_input_iterator_tag, my_output_iterator_tag, my_random_access_iterator_tag}]GetBestMatch<T1, Args ...>::GetBestMatch() [with T1 = my_InputIter; Args = {my_bidirectional_iterator_tag, my_forward_iterator_tag, my_input_iterator_tag, my_output_iterator_tag, my_random_access_iterator_tag}]这个还是比较复杂。一点一点看。
GetBestMatch就是我们模仿重载的类。- 1是这个类的主模板。可以匹配任意情况,但是没有实现。为什么要这么写,下面说。
- 2是针对空参数包(parameter pack)实现的全特化。
- 3是具体的零长(空)参数包语法细节(12.4.5节)。因为是全特化所以特化部分声明依旧需要
<>。 - 4是使用
...接受参数包的任意参数。
- 3是具体的零长(空)参数包语法细节(12.4.5节)。因为是全特化所以特化部分声明依旧需要
- 5是一个偏特化。类的可变参数模板的偏特化是可以从变长模板里拆分的(12.4.1节)。
- 6这个类是继承自
GetBestMarch以剩余参数为参数的类的。这就是递归的模板展开。我们一会儿看函数签名。 - 7测试函数签名
- 8是使用
using引入父类的match函数。不引入的话,父类的match函数会被隐藏。 - 9使用
declval搭配decltype来判断输入的迭代器到底和哪个匹配。
关于我们的 static T1 match(T1) 函数,目的就是找到一个匹配的版本。也就是如果我们有ABC三个tag。则根据递归模板展开,会有三个match函数:
A match (A)B match (B)C match (C)
模板展开的同时我们使用using引入了父类的match,所以三个match都会被看见。最后在重载选择的时候,如果我们的T1是A就会正确匹配到A。以此类推。
- 同时为什么返回值也要是
T1不是void,因为我们用了decltype
我们看函数签名,我们发现就是一层一层的递归。每一个参数模板依次被当做T1。然后剩余参数包内容继续递归直到参数包空了为止。
- 整体逻辑:
首先我们的myoperation类的模板形参是iter类型和一个此处调用了GetBestMatchValue的检查最佳匹配的模板。
然后,进入到GetBestMatchValue别名模板。这时候的T1是当前迭代器入参的类型。参数包是所有迭代器的类型。调用GetBestMatchT。
然后进入GetBestMatchT萃取模板。首先把T1也就是当前迭代器类型使用declval模拟一个对象,调用GetBestMatch模板类内的match函数。同时使用decltype获取返回值类型。
我们此时进入核心模拟重载类模板GetBestMatch。这时候传入的Args是五个tag。然后进入递归阶段。模板一直展开至参数包为0,则 五个tag的最后面一个依次被当做T1,剩下的当做参数。
比如my_random_access_iterator_tag是最后一个,当前的T1就是my_random_access_iterator_tag。则match函数就是my_random_access_iterator_tag match(my_random_access_iterator_tag)。此时继承的基类是针对零长参数包的特化。使用using引入继承来的match函数。那个match可以接受任意参数。
以此类推。比如my_output_iterator_tag是倒数第二个。然后就是有自己的match函数。然后引入继承来的match函数。因为此时的父类是GetBestMatch<my_random_access_iterator_tag>
然后继续。剩下的看上面的函数签名推一下就好了。
最后,我们GetBestMatchValue应该返回的是和输入的迭代器类型最匹配的那一个类型。然后实例化myoperation类的对象的时候,模板实参会被默认参数补齐。tag会被替换成正确版本。然后进行匹配至特定的偏特化版本。
- 最后关于两种替换的写法。
这两种结果都可以。但是第一种带全特化的明显更好。原因是在这种情况下,可能有一些边缘情况我们没有考虑到。所以我们不应该让主模板接受任意参数,做为默认的版本。我们不应该提供主模板的实现,只提供一个针对零长参数包的特化。这样在某些边缘情况只能匹配到主模板的时候,应该报错。因为没有考虑过边缘情况。核心就是防止误用。
20.5 实例化安全的模板
这个例子比较长。简而言之书里X3不行的原因是X3的operator<是接受两个非常量左值引用类型。而我们HasLess里面的test用了临时对象<临时对象(无论是declval还是直接U1()都不行。因为都是右值)。但是非常量左值引用不能接受右值,自然就不行。
- 额外提到了的坑是
X7。X7的boollike虽然不能隐式转为bool。但是可能发生显式的向bool类型的转换可以被隐式使用,比如控制语句的bool类型条件,内置的!,&&,||运算符和三目运算符?:。在这些情况下,该值被认为是 语境上可以转换为bool
这可能会发生问题。但是我们可以解决。虽然语句和被任意类型重载的逻辑不能出现在SFINAE上下文,但是三目运算符是表达式且不能被重载。所以可以用它来测试语境上是否可以转换为bool。
接着讨论一下HasLess的细节
template<typename T1, typename T2>class HasLess { template<typename T> struct Identity; //细节1
template<typename U1, typename U2> static std::false_type test(...);
template<typename U1, typename U2> static std::true_type test(Identity<decltype(declval<U1>() < declval<U2>())>*); //细节2
public: static constexpr bool value = decltype(test<T1, T2>(nullptr))::value;};- 我们发现他的实现有一些不同。细节1使用了一个额外的
struct,并且细节2使用了这个struct的指针,为什么?- 首先,我们的目的和之前的不同。之前可以使用一个函数形参来检测隐式转换。但是这里我们需要让整个小于表达式合法。我们可以在下面也使用之前的形式。但是这里更为方便。
- 我们如果
U1和U2拥有合法的小于比较操作,则这个decltype是bool类型。可以实例化一个Identity的指针。为什么是指针?因为Identity是不完整类型。 - 如果没有合法操作,则匹配至
...万能版本。
所以我们更改一下实现。
template<typename T1, typename T2>class AnotherHasLess { template<typename T> struct Identity{}; //细节1
template<typename U1, typename U2> static std::false_type test(...);
template<typename U1, typename U2, typename = decltype(Identity<decltype(declval<U1>() < declval<U2>())>())> //细节2 static std::true_type test(void*);
public: static constexpr bool value = decltype(test<T1, T2>(nullptr))::value;};- 由于我们此时给
Identity提供的是完整类型,所以我们在下面可以不使用指针而是使用()生成匿名对象。 - 同时我们也不一定非得放到函数参数里。我们也可以放到模板参数里。
甚至可以这样参考19.4.1和19.5来实现
template<typename T1, typename T2>class MoreHasLess { static bool try_call(bool); //细节1 template<typename U1, typename U2> static std::false_type test(...);
template<typename U1, typename U2, typename = decltype(try_call(declval<U1>() < declval<U2>()))> //细节2 static std::true_type test(void*);
public: static constexpr bool value = decltype(test<T1, T2>(nullptr))::value;};- 这里我们依旧模拟了19.4.1的形式。使用一个函数。但是这有一个小问题。问题就是我们笃定
operator<一定返回bool。但其实不一定。也不一定能隐式转换。这里其实就是看语义了。 - 细节2就是这里可以和19.5一样了。
第二十一章 模板和继承
21.2 CRTP 奇异递归模板模式
CRTP的一个最明显的特点就是把派生类作为基类的模板参数
template<typename T>class Base{
};
class Derive: public Base<Derive>{
};CRTP 的第一个概要展示了一个非依赖性基类: 子类(Derive)不是模板,因此不受依赖基类的一些名称可见性问题的影响。
在CRTP模式中,基类被声明成一个类模板,派生类继承自基类的一个特化——基于派生类自身的特化。如上面的代码所示,基类Base根据派生类Derive进行实例化,而派生类Derive则继承基类Base根据Derive实例化的那个类。
- CRTP的核心是利用子类的信息生成代码,使用静态多态而不是动态多态。
我们首先以一个例子和一个理由来阐述为什么需要CRTP。
- 我们用一个最简单的例子解释什么叫静态多态替换了动态多态
template <typename T>class Base{ public: void func(){ //注意这个不是虚函数。不是动态多态 static_cast<T*>(this)->func(); //使用static_cast转换为子类指针 }};class myclass:public Base<myclass>{ public: void func(){ cout <<"called" << endl; }};
int main(){ Base<myclass>* obj = new myclass; obj->func();}这里的核心原理是,我们在父类的func函数中使用static_cast把this指针cast为子类指针,然后调用子类对象。可以用static_cast是因为我们基本上可以从语义上保证这一操作绝对合法。
可以使用智能指针,因为允许不完整类型。
表面看上去没什么用,但是这确实是介绍CRTP的一个好方式。但是坑有很多
第一个坑 子类没有实现父类调用的函数
如果在我们上一个例子中,子类没实现func函数会有什么问题?答案是无限递归。并段错误。但是编译期并没有问题。我们调用Base::func()的时候,紧接着会调用myclass::func(),但是子类没有自己的func(),此时父类的func()会被调用,自然无限递归。
这里的问题是,没有什么规定来强制我们重写派生类中的成员函数func(),但是如果我们不重写,程序就会产生错误。问题的根源在于,我们将接口和实现混在了一起——基类中的公共成员函数声明表示所有派生类都必须有一个函数void func()作为其公共接口的一部分,而派生类则应该对此函数提供不同版本的实现。针对此问题,一种临时的解决方法是,让函数实现和函数声明具有不同的函数名,如下所示。
template <typename T>class Base{ public: void func(){ static_cast<T*>(this)->func_impl(); } //void func_impl(){}//默认实现,如果想要的话。};class myclass:public Base<myclass>{ public: void func_impl(){ //换个名字 cout <<"called" << endl; }};此时,如果我们忘记实现myclass::func_impl(),那么程序就不会被编译通过,因为派生类myclass中不存在这样的成员函数。通过将函数声明和实现相分离的方式,我们在编译期多态中实现了纯虚函数的机制。如果我们想实现一个常规的虚函数,只需要在基类中提供一个func_impl的默认实现。
第二个坑 析构函数
CRTP模式面临的一个问题是,如何根据一个基类指针删除对应的派生类对象?在运行期多态下,这就很容易,我们直接把析构函数声明成虚函数即可。但是在编译期多态中,不依赖虚函数,该如何解决这个问题呢?一个错误的解决方法是直接对基类指针调用delete操作符。在这种情况下,只有基类的析构函数被调用了,派生类的析构函数没有被调用。因为此时基类的析构函数不是虚函数。。另一个错误的解决方法是在基类的析构函数中将基类类型转换成派生类类型,再调用派生类的析构函数。然而,在基类的析构函数中,任何对派生类的非虚成员函数的调用都可能产生未定义行为。即使没有产生未定义行为,派生类的析构函数会调用基类的析构函数,从而产生递归调用。
template <typename T>class Base{ public: void func(){ static_cast<T*>(this)->func_impl(); } int* baseval = new int(10); virtual ~Base(){ //如果不加virtual,就会泄漏 delete baseval; }};
class myclass:public Base<myclass>{ public: void func_impl(){ cout <<"called" << endl; } int* deval = new int(20); ~myclass(){ delete deval; }};这个问题的解决方案有两个。
- 一是使用一个额外的函数模板,将编译期多态性应用到删除操作上。比如
template <typename T>void destroy(Base<T>* b) { delete static_cast<T*>(b);}但是比较违背RAII特性。
- 另一个解决方案是让析构函数成为真正的虚函数,也就是直接把析构函数声明为虚的。这种方法会略微增加虚函数调用的开销。不过我们只把析构函数声明成虚函数,相比于把所有成员函数声明成虚函数要好得多。
CRTP和委托模式
这是最为常见的一种CRTP用法。
我们之前通过CRTP实现了编译期多态,可以通过基类指针或引用访问派生类对象中的方法。在这种情况下,基类会定义若干通用接口,而派生类负责提供不同的实现,这种用法也被称为静态接口。但是,如果我们直接使用派生类对象,那么情况就会变得不同——基类不再是接口,派生类也不仅仅是实现。派生类扩展了基类的接口,基类的一些行为被委托给派生类。
假设我们有一个需求:为所有的提供了operator==的类自动提供一个operator!=。我们这时候就可以使用CRTP。
template <typename T>class Base{ public: // bool operator!=(const Base& rhs){ //两种写法,这种更清晰 // if(static_cast<const T&>(*this).operator==(static_cast<const T&>(rhs)) == true){ // return false; // } // return true; // } bool operator!=(const Base& rhs){ if((static_cast<const T&>(*this) == static_cast<const T&>(rhs)) == true){ //注意cast return false; } return true; }
};
class myclass:public Base<myclass>{ public: int val = 0; myclass() = default; myclass(int x):val(x){} bool operator==(const myclass& rhs) const { //必须const return val == rhs.val; }};- 这里我们主要注意cast。我们由于入参是
base类的引用,所以要给this解引用后cast为T的引用,同时因为static_cast不能移除const,所以要cast为const引用。同时常量引用不能调用非常量成员函数,下面的operator==依旧要为const。
CRTP和enable_shared_from_this
STL里面最经典的CRTP应用便是这个了。如果我们想获取一个指向自己的智能指针,就必须继承自这个类。然后使用shared_from_this()
使用举例:
struct Good: std::enable_shared_from_this<Good> // 注意:继承,模板参数是本类类型。符合CRTP特征。{ std::shared_ptr<Good> getptr() { return shared_from_this(); }};部分源代码
template<typename _Tp> class enable_shared_from_this { protected:
enable_shared_from_this(const enable_shared_from_this&) noexcept { } ~enable_shared_from_this() { }
public: shared_ptr<_Tp> shared_from_this() { return shared_ptr<_Tp>(this->_M_weak_this); } //通过弱指针来创建shared_ptr并返回。
shared_ptr<const _Tp> shared_from_this() const { return shared_ptr<const _Tp>(this->_M_weak_this); }
private: mutable weak_ptr<_Tp> _M_weak_this; //维护的类类型的弱指针 };enable_shared_from_this的核心原理是:通过自身维护了一个std::weak_ptr让所有从该对象派生的shared_ptr都通过std::weak_ptr构造派生。关于这个弱指针在哪儿被赋值,看这里
CRTP和计数器
可以查看more effective c++ 条款26
https://www.youtube.com/watch?v=ZQ-8laAr9Dg
https://blog.csdn.net/breadheart/article/details/112451022
https://www.cnblogs.com/shuo-ouyang/p/15773193.html
21.3 mixin 混合类
这是一个非常神奇的东西。有一点依赖倒置样子。鼓励代码重用,且不会有多重继承导致的歧义(菱形问题)。
继承的问题是无法自由的组合这些具体类,但是mixin是一种灵活的组合概念。
它可以通过多继承来实现。
上面又说组合,又说可以通过继承来实现,是不是非常疑惑?看看下面的第一个例子。
我想出来了两种例子,但是我并不确定mixin是否有严格定义。
- 第一种情况。
这种情况较为常见。就是传统意义的多继承。
class printBase{ public: virtual void print_val() = 0;};class printMethod1 : public virtual printBase{ public: void my_print(){ cout <<"method1" << endl; } void print_val(){ my_print(); }};class printMethod2 : public virtual printBase{ public: void my_print(){ cout <<"method2" << endl; } void print_val(){ my_print(); }};class I_want_all:public printMethod1, printMethod2{ public: void print_val(){ printMethod1::my_print(); } void print_method1(){ print_val(); } void print_method2(){ printMethod2::my_print(); }};int main(){ I_want_all obj; obj.print_method1(); obj.print_method2();}问题在于虚继承会有损性能。如何用mixin改写?
template<typename T>class printMethod1 : public T{ public: void my_print(){ cout <<"method1" << endl; T::my_print(); }};
template<typename T>class printMethod2 : public T{ public: void my_print(){ cout <<"method2" << endl; T::my_print(); }};
class myclass{ public: void my_print(){ cout <<"my print" << endl; }};
int main(){ myclass obj; obj.my_print(); cout<<"-----------------------"<<endl; printMethod1<myclass> obj2; obj2.my_print(); cout<<"-----------------------"<<endl; printMethod2<myclass> obj3; obj3.my_print(); cout<<"-----------------------"<<endl; printMethod1<printMethod2<myclass>> obj4; obj4.my_print(); cout<<"-----------------------"<<endl; printMethod2<printMethod1<myclass>> obj5; obj5.my_print();}/*my print-----------------------method1my print-----------------------method2my print-----------------------method1method2my print-----------------------method2method1my print*/我们主要注意到了,不再有printBase基类了。也就是这里不存在严格的单继承或多继承关系。但是非常神奇的一点是在最后obj4和obj5的使用中,神奇的所有需要打印的都打印了。以obj4为例。printMethod1继承自printMethod2<myclass>。printMethod2继承自myclass。所以在printMethod1中,打印了自己的后T是printMethod2<myclass>,进入printMethod2中的打印,打印自己后T是myclass,所以最后进入myclass打印。
我们发现,这么看起来,myclass反而是基类。这就是一种依赖倒置。我们提供实现了my_print的类,而库只需要调用我们的类即可。
如果严格按照继承来进行,失去了灵活的组合能力。必须固定化某个顺序。比如我们假设想要调整打印顺序,如果是默认的单继承是不可能的。
- 第二个例子
这个例子中,非常明显的体现出了依赖倒置原则。
template<typename... Mixin>class PointMixin : public Mixin...{ public: PointMixin() = default; PointMixin(int x, int y): Mixin()..., posx(x), posy(y){} //Mixin()...是一个参数包展开。作用是调用所有继承来的类的默认构造。这里最好调用一下。养成好习惯。虽然此处不调用也没差。 int posx = 0; int posy = 0;};class color{ public: color(){ cout <<"color const called" << endl; } int colorID = 234; void colorfunc(){ cout <<"color" << endl; }};
class label{ public: label(){ cout <<"label const called" << endl; } char charId = 'a'; void labelfunc(){ cout <<"label" << endl; }};int main(){ PointMixin<color, label> obj; obj.labelfunc(); obj.colorfunc();}这个例子的依赖倒置就非常非常明显。我们提供的color和label被PointMixin继承。所以就算PointMixin可能是库提供的,但是它依旧是子类。这里利用了可变参数包展开的多继承。
我们可以发现,PointMixin成功获得了我们的color和label类的属性,也就是我们成功把可变属性添加到了不可变的类当中。这种依赖倒置还是非常常见的。
- 我们甚至还可以用容器储存:
template<typename... Mixins>class containerMixins{ public: vector<PointMixin<Mixins...>> myvec;};int main(){ PointMixin<color, label> obj; containerMixins<color, label> mycontainer; mycontainer.myvec.push_back(obj); mycontainer.myvec[0].labelfunc(); mycontainer.myvec[0].colorfunc();}- 混合类还可以和CRTP共同使用
https://fuzhe1989.github.io/2018/04/21/mixin/
https://blog.csdn.net/jiang4357291/article/details/103325488
第二十二章 桥接(此处的桥接是动词,连接的意思)静态和动态多态
22.1 函数对象,函数指针和std::function
这是老生常谈的问题了。std::function使用类型擦除可以同时接收多种可调用对象。
假设我们需要让一个函数接受多种可调用对象,可能的一种方式是使用模板:
struct myobj{ //重载了函数调用运算符的类 void operator()(int x){ cout << "called" << x << endl; }};void func(int x){ //函数指针 cout << "called" << x << endl;}
template<typename F>void test(int x, F f){ //调用 std::puts(__PRETTY_FUNCTION__); f(x);}
int main(){ auto mylambda = [](int x){cout <<"called" << x << endl;}; //lambda test(10, mylambda); test(20, func); test(30, myobj());}- 原因是:
- 重载了函数调用运算符的类不能直接转换为函数指针。它是成员函数指针,和函数签名不符合。
- lambda只有在捕获符为空的时候才能被转换为函数指针(参见lambda介绍,只有捕获符为空的时候用户定义转换函数才会被定义)
我们可以看到,三者的F类型推导结果并不一致
void test(int, F) [with F = main()::<lambda(int)>]called10void test(int, F) [with F = void (*)(int)]called20void test(int, F) [with F = myobj]called30- 所以如果不使用模板,这三者并不能被兼容。
这样做有一个问题:三种类型的实例化会导致代码膨胀,所以我们有类型擦除的典范:std::function。但是它性能很差。
剩下的是std::function的模拟实现和桥接模式
给我脸都看绿了。
https://blog.csdn.net/zdy0_2004/article/details/50652934
https://blog.csdn.net/weixin_43798887/article/details/116571325
第二十四章 类型列表
24.1~24.2 类型列表剖析和操作
- typelist简单的说就是一个类型容器,能够对类型提供一系列的操作(把类型当成数据来操作)。就象C++标准库中的list容器(能够对各种数值提供各种基本操作),但typelist是针对类型进行操作。
- 从实现上,typelist是一个类模板,中文名字叫:类型列表。该类模板用来表示一个列表,在该列表中存放着一堆类型。
注意:typelist的值不可以被修改。也就是我们下面例子中任何对typelist的操作,如增添,删除,都是通过对应操作创建的新的typelist
template<typename... Items>class typeList{}; //类型列表 主类 。你没看错,就这么简单
//-----获取第一个元素------template<typename Items> //Item代表了整个typeList。所以此处不需要变参。class FrontItem{}; //获取第一个元素的主模板。
//因为我们整个塞进去的是typeList。所以我们下面的特化是基于typeList里面的参数的。template<typename First, typename... Other>class FrontItem<typeList<First, Other...>>{ //偏特化,把元素按照第一个和其余的拆开。 public: using type = First; //只保留第一个元素};//-----移除第一个元素------template <typename Items> //此处同FrontItemclass PopFront{}; //移除第一个元素
template<typename First, typename... Other> //此处同FrontItemclass PopFront<typeList<First, Other...>>{ public: using type = typeList<Other...>; //去掉第一个元素,成为新的typelist};//-----获取typelist的大小------template<typename Items>class ListSize{}; //获取类型列表的大小。此处同FrontItem
template<typename... Items> //因为我们不再需要拆开了,所以不需要First模板形参了。class ListSize<typeList<Items...>>{ public: static inline size_t value = sizeof...(Items);};
//-----头部插入元素------template<typename Items, typename NewItem> //此处同FrontItem, Items是整个typelist, NewItem是新的元素(类型)。class PushFront{}; //头插
template<typename... Items, typename NewItem> //和pop相反class PushFront<typeList<Items...>, NewItem>{ //和pop相反 public: using type = typeList<NewItem, Items...>; //直接组合成新的typelist};
//-----尾部插入元素------template<typename Items, typename NewItem> //此处同FrontItem, Items是整个typelist, NewItem是新的类型。class PushBack{}; //尾插
template<typename... Items, typename NewItem> //和头插相同class PushBack<typeList<Items...>, NewItem>{ //和头插相同 public: using type = typeList<Items..., NewItem>; //直接组合成新的typelist,只是和头插顺序相反。};
//-----替换第一个元素------template<typename Items, typename ReplaceItem>class ReplaceFront{}; //替换第一个元素。
template<typename First, typename... Other ,typename ReplaceItem> //注意这里有三个元素。第一个,剩下的和替换的。class ReplaceFront<typeList<First, Other...>, ReplaceItem>{ public: using type = typeList<ReplaceItem, Other...>; //直接把第一个换成替换的即可。};
//-----判断是否为空------template<typename Items>class isEmpty{ //判断是否为空。 public: static inline const bool value = false;};
template<>class isEmpty<typeList<>>{ //直接全特化。如果列表为空直接匹配过来。 public: static inline const bool value = true;};
//-----真正的typelist-----using Typelist1 = typeList<int, char, string, double, float>; //类型列表using emptylist = typeList<>;//空的类型列表
int main(){ cout << boolalpha; cout << typeid(FrontItem<Typelist1>::type).name() << endl; //输出类型列表第一个元素的类型。int cout << ListSize<Typelist1>::value << endl;//输出类型列表的大小。5
cout << typeid(FrontItem<PopFront<Typelist1>::type>::type).name() << endl; //先把类型列表的第一个元素去掉,然后输出第一个元素类型。char。记住,我们针对所有原始类型列表的操作,都不是作用于原始列表。都是新建列表。 cout << ListSize<PopFront<Typelist1>::type>::value<<endl; //获取移除第一个元素后的列表大小。4
cout << typeid(FrontItem<Typelist1>::type).name() << endl; //获取原始类型列表的第一个元素,证明操作不作用于原始列表。int
using pushedback = PushBack<Typelist1, int>::type; //使用别名方便使用。这个操作是在类型列表尾部插入新的类型int cout << ListSize<pushedback>::value<<endl; //插入后,新列表大小。6(原来是5)
using pushedfront = PushFront<pushedback, double>::type; //在尾插后的类型列表头插double cout << ListSize<pushedfront>::value<<endl;//新列表大小7
using replaced_front = ReplaceFront<Typelist1, float>::type; //把类型列表首元素换位float cout << typeid(FrontItem<replaced_front>::type).name() << endl; //新列表首元素 float
cout << isEmpty<Typelist1>::value << endl; //是否为空,否 cout << isEmpty<emptylist>::value << endl; //是否为空,是 return 0;
}我们可以发现,整个过程其实就是针对typelist元素的组合。应用了偏特化和全特化的知识。
- 额外介绍一下索引
template<typename Items, unsigned int m_index> //item是个typelist,m_index是索引class find_element: public find_element<typename PopFront<Items>::type, m_index-1>{};//这里面用了递归,每次都继承自把首元素去掉的typelist。注意需要使用type因为那才是我们定义的typelist。并且加typename显式指明是类型。然后index-1
template<typename Items>//这个是针对找到了对应index的特化。因为index最终会减到0。这时候的特化版本继承自FrontItem,因为这个时候typelist的首元素就是我们想要找的那个元素。class find_element<Items, 0>: public FrontItem<Items>{};
cout << typeid(find_element<Typelist1, 3>::type).name() << endl; //输出double所以整个过程就是
find_element<typelist<int, char, string, double, float>,3>继承自find_element<typelist<char, string, double, float>,2>- 然后继承自
find_element<typelist<string, double, float>,1> - 然后当前变为
find_element<typelist<double, float>,0>,继承自特化版本,就是FrontItem<typelist<double, float>> - 因为
FrontItem定义了type。所以可以直接用了。
24.3~ 这部分比较枯燥,暂时略过
第二十五章 元组
元组就是一种可以储存不同类型的容器。通常使用模板元编程和typelist来实现。元组在语法上有一个不同的地方,也就是元组中的元素是用位置信息(下标)索引的。而不是通过名字。
25.1 基本的元组设计
元组的核心原理和上面的typelist几乎一模一样。
25.1.1 存储
我们应该记得标准库的元组的使用方式。存储通过函数模板get()进行访问。对于元组t,语法为get<I>(t)。I是元素下标。此时返回的是第I个元素的引用(和其他容器一样)
template<typename... Types>struct my_tuple{}; //主模板。和typelist一样。
template<typename First, typename... Others>struct my_tuple<First, Others...>{ First first; //头元素 my_tuple<Others...> others; //其他的元素组成的my_tuple
my_tuple(){ cout <<"const" << endl; //默认构造 }; my_tuple(const First& head, const my_tuple<Others...>& tail):first(head), others(tail){ cout <<"tuple const called" << endl; //这个构造的意义是使用一个元素和另一个tuple进行构造。 };
my_tuple(const First& head, const Others&... tail):first(head), others(tail...){ cout << first << endl; cout << "size of rest elements: "<< sizeof...(tail) << endl; std::puts(__PRETTY_FUNCTION__); cout <<"element const called" << endl; //这个构造才是我们直观的,使用一堆独立的元素构造 };
First& getHead(){ cout <<"getHead called" << endl; return first; }
const First& getHead() const{ cout <<"getHead called" << endl; return first; }
my_tuple<Others...>& getTail(){ cout <<"getTail called" << endl; return others; }
const my_tuple<Others...>& getTail() const{ cout <<"getTail called" << endl; return others; } ~my_tuple(){ cout <<"dest" << endl; }};
template<> //这个特化是针对空参数。也就是最后剩余参数为0的情况struct my_tuple<>{
};
template <unsigned int m_index>struct find_element{ template<typename First, typename... Others> static auto m_get(const my_tuple<First, Others...>& t){ cout <<"current index: " << m_index << endl; return find_element<m_index-1>::m_get(t.getTail()); //这里的类模板是get<N>的N我们要显式指定 //这里的函数模板是通过my_tuple进行推导。可变参数被拆分了。 //随后递归调用,m_index每次-1然后调用getTail,也就是去掉每一次的头部。 }};
template<> //find_element的特化。也就是此时index减到为0了。我们找到了想找的元素struct find_element<0>{ //下面是两个版本而已。 template<typename First, typename... Others> static const First& m_get(const my_tuple<First, Others...>& t){ cout <<"m_get called" << endl; return t.getHead(); //由于此时头部元素就是我们想要找的,所以直接调用getHead } template<typename First, typename... Others> static First& m_get(my_tuple<First, Others...>& t){ cout <<"m_get called" << endl; return t.getHead(); }};
//----------const和非const的get。注意get不是成员函数。标准库也是这样设计的。template<unsigned int m_index, typename... Types>auto get(const my_tuple<Types...>& t ){ return find_element<m_index>::m_get(t);}template<unsigned int m_index, typename... Types>auto get(my_tuple<Types...>& t ){ return find_element<m_index>::m_get(t);}int main(){ my_tuple<int, char, double, float> testtuple(10, 'a', 2.3, 3.4); cout<<"--------------------------------------" << endl; cout << get<2>(testtuple) << endl;}3.4size of rest elements: 0my_tuple<First, Others ...>::my_tuple(const First&, const Others& ...) [with First = float; Others = {}]element const called2.3size of rest elements: 1my_tuple<First, Others ...>::my_tuple(const First&, const Others& ...) [with First = double; Others = {float}]element const calledasize of rest elements: 2my_tuple<First, Others ...>::my_tuple(const First&, const Others& ...) [with First = char; Others = {double, float}]element const called10size of rest elements: 3my_tuple<First, Others ...>::my_tuple(const First&, const Others& ...) [with First = int; Others = {char, double, float}]element const called--------------------------------------current index: 2getTail calledcurrent index: 1getTail calledm_get calledgetHead called2.3destdestdestdest- 我们发现,构造过程中和CRTP一样,是递归调用。我们通过函数签名发现,每次在构造函数中初始化本类的
others的时候,都会进入下一层的递归。所以在最后一层Others参数包为空的时候,first就是tuple的最后一个元素。
所以第一个打印出来的是3.4 (最后一个元素)。参数包size为0。然后逐层弹出。
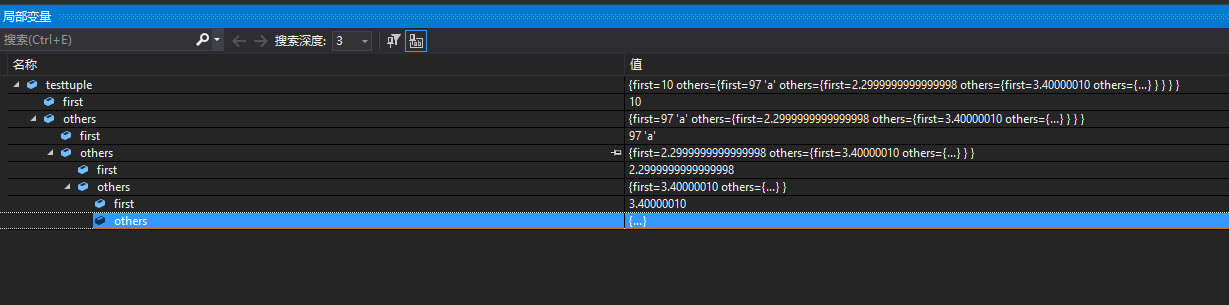
所以我们发现,一共有四个my_tuple对象被构造了。因为我们的others成员变量本身就是一个my_tuple对象。
所以 10, 'a', 2.3, 3.4 相当于
my_tuple(10, my_tuple('a', my_tuple(2.3, my_tuple(3.4, my_tuple<>))))
- 然后看一下
get。
这个get和typelist的get如出一辙。都是通过index逐次-1然后去掉头部元素(这里是通过gettail保留尾部)实现的
我们从打印中能看出来。index每次减掉1,然后getTail被调用。
当index为0的时候匹配至特化,这时候调用getHead。
剩下的还是比较多的,看书吧。
https://blog.csdn.net/baidu_41388533/article/details/109818986
std::is_same
- is_same的主要作用是判断两个类型是否相同。
template< class T, class U >struct is_same;- 如果T与U是考虑
const-volatile限定的相同类型,则is_same<T,U>::value为true,否则为false。
举例:
int main(){ cout << is_same<int, int>::value << endl; //输出1 (true) cout << is_same<int, string>::value << endl; //输出0 (false) return 0;}可能的实现
template<typename _Tp,_Tp _v>struct intergral_constant{ static constexpr _Tp value = _v; //表示值 typedef _Tp value_type; //值类型 typedef intergral_constant<_Tp,_v> type; //表示自己的类型
constexpr operator value_type () const noexcept {return value;} constexpr value_type operator()() const noexcept {return value;} //since c++14};//定义true_type 和 false_typetypedef intergral_constant<bool, true> true_type;typedef intergral_constant<bool, false> false_type;
//is_same的实现template <typename T1,typename T2>struct is_same: public false_type {};//类型相同就相当于一个模板参数template <typename _Tp>struct is_same<_Tp,_Tp>: public true_type {};- 首先定义了一个类模板
is_same,这个类模板有两个模板参数T和U。接着针对这个类模板T和U类型相同的情况进行偏特化。所以,当T和U为同一种类型时,将匹配到1,不同则匹配到0。两个版本唯一的不同是父类。 - 然后是判断两个类型,如果两个类的类型不同,那么应该是继承自
false_type,如果类型相同的话应该继承自true_type。
自己模拟一下简单实现
template<typename T1, typename T2>class MyClass { public: //主模板 如果两个类型不一则会匹配到这里 MyClass(T1 a, T2 b):val1(a), val2(b){ cout <<"diff type" << endl; } T1 val1; T2 val2;};
template<typename T>class MyClass<T,T> { public: //同一类型的偏特化模板。如果两个类型一致则会匹配到这里 MyClass(T a, T b):val1(a), val2(b){ cout << "same type" << endl; } T val1; T val2;};int main(){ MyClass<int, int> myobj1(19,22); //输出 same type MyClass<int, string> myobj2(11, "abcde"); //输出 diff type return 0;}std::is_convertible
is_convertible用于判断两个类型之间是否可以隐式转换:第一个模板参数的类型是否可以隐式转换为第二个模板参数的类型。
template< class From, class To >struct is_convertible;首先,如果满足下列条件,则 std::is_convertible<From, To>::value 为 true,否则为 false
From和To均为void类型(可含有cv限定)std::declval<From>()可隐式转换为To类型- 例子1:如果
From,to都是基本类型,那么可以隐式转换。 - 例子2:如果
From是子类,To是基类,那么From可以转换为To。 - 核心就是查看两个类之间是否有一个转换序列可以满足类型转换。
- 使用例子:
struct A { };struct B : A { };
int main() { cout << std::boolalpha; /* 输出流将bool输出true/false, 而不是1/0 */ cout << "is_convertible:" << endl; cout << "int => float: " << is_convertible<int,float>::value << endl; cout << "int = >const int: " << is_convertible<int,const int>::value << endl; cout << "A => B: " << is_convertible<A,B>::value << endl; /* A不能转换为B */ cout << "B => A: " << is_convertible<B,A>::value << endl; /* B能转换为A */ return 0;}/*is_convertible:int => float: trueint = >const int: trueA => B: falseB => A: true*/- 进阶例子:
class myobj2{ public: int val; myobj2() = default; myobj2(int a):val(a){}; //注意这里是没有explicit operator int(){ //注意这里加了用户定义转换函数 return val; }
};
int main(){ cout << "myobj2 => int: " << is_convertible<myobj2, int>::value << endl; //true myobj2可以隐式转换为int cout << "int => myobj2: " << is_convertible<int, myobj2>::value << endl; //true int可以隐式转换为myobj2。 return 0;}由于我们加了用户定义转换函数,所以可以从myobj2隐式转为int。我们也有转换构造函数,所以也可以从int隐式转换为myobj2
- 如果去掉类型转换函数:
class myobj2{ public: int val; myobj2() = default; myobj2(int a):val(a){}; //注意这里是没有explicit};
int main(){ cout << "myobj2 => int: " << is_convertible<myobj2, int>::value << endl; //false myobj2不可以隐式转换为int cout << "int => myobj2: " << is_convertible<int, myobj2>::value << endl; //true int可以隐式转换为myobj2。 return 0;}- 如果给构造函数添加explicit,禁止隐式类型转换:
class myobj2{ public: int val; myobj2() = default; explicit myobj2(int a):val(a){}; //有explicit};
int main(){ cout << "myobj2 => int: " << is_convertible<myobj2, int>::value << endl; //false myobj2不可以隐式转换为int cout << "int => myobj2: " << is_convertible<int, myobj2>::value << endl; //false int不可以隐式转换为myobj2。 return 0;}详细:https://www.cnblogs.com/fortunely/p/16216310.html
关于判断对象类型还是指针类型之间是否可以转换的坑在智能指针的MEC++28条部分
std::is_base_of
template< class Base, class Derived >struct is_base_of;若 Derived 派生自 Base 或为同一非联合类(均忽略 cv 限定),则提供等于 true 的成员常量 value 。否则 value 为 false 。
其实没啥好说的,就是看Derived是不是派生自Base。但是这个和上面的std::is_convertible有啥区别?
还是有区别的。因为std::is_convertible核心是查看能否隐式转换。当然了,在继承链条上大部分情况都可以。但是还是有例外,比如私有继承的时候就不能转。所以说std::is_base_of做的就是一件事,查看是否是派生关系。然而std::is_convertible做的事情就更多了。
std::is_constructible
template <class T, class... Args>struct is_constructible;如果通过使用 Args 中的参数类型可构造类型 T,则类型谓词的实例保持 true;否则保持 false。 如果变量定义 T t(std::declval<Args>()...); 的格式正确,则可以构造类型 T。 T 和 Args 中的所有类型都必须是完整的类型、void,或者是未知边界的数组。
-
这一大堆官方文档其实就是意思是看
Args的这些参数能不能构造T类型对象。 -
上面的
is_convertable是来判断能否隐式转换。而这里可以被用来测试是否可以显式转换。杂记1中我们提到过:显式地调用构造函数进行直接初始化实际上是显式类型转换的一种。
例子:
class myobj{ public: int val; char single; string name; myobj(){} myobj(int a):val(a){}; myobj(int a, char b, string& c): val(a), single(b), name(move(c)){};
};int main(){ cout << is_constructible<myobj, int>::value << endl; //trus cout << is_constructible<myobj, int, char, string>::value << endl; //false cout << is_constructible<myobj, int, char, string&>::value << endl; //true return 0;}为啥第二个传值是false?我们不是可以如这样:
string name = "abc";myobj a(12,'a',name);- 注意了,这里的
name虽然是值,但是由于函数签名是string&,所以name这个参数在我们传递到函数内的时候,函数内会创建一个name的引用,叫做c。 - 这里可以理解为函数签名。你想把一个函数
void function(int& x)塞进这样的函数指针void(*ptr)(int)是错的。引用和值在签名处不可混为一谈。 - 同时,针对这个构造函数,如果我们尝试这样做:
myobj(1, 'c', std::string{"lalala"});这时候就会失败。因为左值引用不能接右值。
-
所以在这里,函数的形参类型是
string还是string&有很大差别。当然了,这里如果给构造函数换成const string&就都是true了。或者是换成string值传递也都是true。因为常量左值引用可以接一切。值传递的函数塞引用也没问题。因为引用会被脱去。 -
进阶例子:
上面我们提到了,我们给转换构造函数加了explicit,所以不能隐式转换。所以is_convertible<int, myobj2>::value是false。我们可以尝试用这里的is_constructible来看是否可以显示转换。
class myobj2{ public: int val; myobj2() = default; explicit myobj2(int a):val(a){}; //依旧explicit
};int main(){ cout << "is_constructable:" << endl; cout << "int => myobj2: " << is_convertible<int, myobj2>::value << endl; cout << "is_convertible:" << std::endl; cout << "int => myobj2: " << is_constructible<myobj2,int>::value << endl; return 0;}/*is_constructable:int => myobj2: falseis_convertible:int => myobj2: true*/我们看到依旧不能隐式转换所以第一个是false。但是我们可以使用int来构造myobj2 所以第二个是true。
注意一下参数顺序。能不能转换是第一个转到第二个。能不能构造是第二个构造第一个。