
异常
C++引入异常的原因是这样做可以让我们在构造函数中抛出异常。还有比如dynamic_cast传入引用时的报错。
析构函数不禁止但是极度不推荐抛出异常。原因见杂记2和effective c++条款08。
异常是一个非常难以掌握的特性。它的缺点是会增加开销(需要额外数据结构)和增加代码量。
基本语法:
try{ // 可能抛出异常的语句}catch(exceptionType variable){ // 处理异常的语句}try和catch都是 C++ 中的关键字,后跟语句块,不能省略{ }。try 中包含可能会抛出异常的语句,一旦有异常抛出就会被后面的 catch 捕获。从 try 的意思可以看出,它只是“检测”语句块有没有异常,如果没有发生异常,它就“检测”不到。catch 是“抓住”的意思,用来捕获并处理 try 检测到的异常;如果 try 语句块没有检测到异常(没有异常抛出),那么就不会执行 catch 中的语句。
-
发生异常时必须将异常明确地抛出,try 才能检测到;如果不抛出来,即使有异常 try 也检测不到。所谓抛出异常,就是明确地告诉程序发生了什么错误。
-
异常一旦抛出,会立刻被 try 检测到,并且不会再执行异常点(异常发生位置)后面的语句。
- 检测到异常后程序的执行流会发生跳转,从异常点跳转到 catch 所在的位置,位于异常点之后的、并且在当前 try 块内的语句就都不会再执行了;即使 catch 语句成功地处理了错误,程序的执行流也不会再回退到异常点,所以这些语句永远都没有执行的机会了。
- 执行完 catch 块所包含的代码后,程序会继续执行 catch 块后面的代码,就恢复了正常的执行流。
-
throw关键字用来抛出一个异常,这个异常会被 try 检测到,进而被 catch 捕获。
throw和异常类型的介绍:
exceptionType是异常类型,它指明了当前的 catch 可以处理什么类型的异常;variable是一个变量,用来接收异常信息。当程序抛出异常时,会创建一份数据,这份数据包含了错误信息,程序员可以根据这些信息来判断到底出了什么问题,接下来怎么处理。
- 异常既然是一个对象,那么就应该有类型。C++ 规定,异常类型可以是
int、char、float、bool等基本类型,也可以是指针、数组、字符串、结构体、类等聚合类型。C++ 语言本身以及标准库中的函数抛出的异常,都是 exception 类或其子类的异常。也就是说,抛出异常时,会创建一个exception类或其子类的对象。 exceptionType variable和函数的形参非常类似,当异常发生后,会将异常数据传递给 variable 这个变量,这和函数传参的过程类似。当然,只有跟exceptionType类型匹配的异常数据才会被传递给variable,否则 catch 不会接收这份异常数据,也不会执行 catch 块中的语句。换句话说,catch 不会处理无法匹配的异常。- 我们可以将 catch 看做一个没有返回值的函数,当异常发生后 catch 会被调用,并且会接收实参(异常数据)。
- 但是 catch 和真正的函数调用又有区别:
- 真正的函数调用,形参和实参的类型必须要匹配,或者可以自动转换,否则在编译阶段就报错了。
- 而对于 catch,异常是在运行阶段产生的,它可以是任何类型,没法提前预测,所以不能在编译阶段判断类型是否正确,只能等到程序运行后,真的抛出异常了,再将异常类型和 catch 能处理的类型进行匹配,匹配成功的话就“调用”当前的 catch,否则就忽略当前的 catch。
- 调用函数时,程序的控制权最终还会返回到函数的调用处,但是当你抛出一个异常时,控制权永远不会回到抛出异常的地方。
- 异常对象其实是一个特殊对象。throw语句会依据异常抛出表达式来拷贝初始化(拷贝构造)异常对象。
- 这要求异常抛出表达式不能是一个不完全类型。并且可以进行拷贝初始化。这可能会调用右值表达式的移动构造函数。即使拷贝初始化选择了移动构造函数,从左值拷贝初始化仍必须为良式,且析构函数必须可访问
- 异常对象放在内存的特殊位置,该位置既不是栈也不是堆,在 window 上是放在线程信息块 TIB 中。或者是异常栈中。这个构造出来的新对象与本级的 try 所对应的 catch 语句进行类型匹配
- 由于异常对象在特殊位置,比如异常栈或TIB,所以保证最后销毁。
- 异常对象不同于函数的局部对象,局部对象在函数调用结束后就被自动销毁,而异常对象将驻留在所有可能被激活的 catch 语句都能访问到的内存空间中,也即上文所说的 TIB。当异常对象与 catch 语句成功匹配上后,在该 catch 语句的结束处被自动析构。
- 在函数中返回局部变量的引用或指针几乎肯定会造成错误,同样的道理,在 throw 语句中抛出局部变量的指针或引用也几乎是错误的行为。如果指针所指向的变量在执行 catch 语句时已经被销毁,对指针进行解引用将发生意想不到的后果。
- throw 出一个表达式时,该表达式的静态编译类型将决定异常对象的类型。也就是该对象的类型与throw语句中体现的静态类型相同。即只有子类对象中的父类部分会被抛出,抛出对象的类型也是父类类型(从实现上讲,是因为复制到“临时对象”的时候,使用的是throw语句中类型的(这里是父类的)复制构造函数)。
-
注意,这里分成两种情况。一种情况是throw的指针/引用是多态形式。如
Base* ptr = new Derived(); throw ptr;或Derived d; Base& ref = d; throw ref;- 假设匹配顺序正确,这时候会匹配成
Base。这就是所谓的静态类型。
- 假设匹配顺序正确,这时候会匹配成
-
但是如果你是直接
throw new Derived(),这样会正确匹配到Derived。因为这个时候并不发生多态。静态类型就是Derived -
如果值传递会发生切割。如果catch顺序不对的时候会造成提前匹配。
-
如果throw出来的是派生类引用或指针,如果catch顺序不对的时候且可以匹配至基类也会发生提前匹配。
-
虽然throw本身在匹配类型的时候会发生切割。但是throw的异常对象本身可以蕴含多态。也就是使用指针或引用可以实现多态。
-
//指针的切割class Base{ };class Derived: public Base{ };int main(){ try{ Base* ptr = new Derived(); throw ptr; cout<<"This statement will not be executed."<<endl; } catch(Derived*){ cout<<"Exception type: Derived"<<endl; } catch(Base*){ cout<<"Exception type: Base"<<endl; } return 0;}//这里抛base。因为ptr的静态类型是base
//引用的切割class Base{ };class Derived: public Base{ };int main(){ try{ Derived d; Base& b = d; throw b; cout<<"This statement will not be executed."<<endl; } catch(Derived&){ cout<<"Exception type: Derived"<<endl; } catch(Base&){ cout<<"Exception type: Base"<<endl; } return 0;}//这里还是抛base。因为引用b的静态类型也是base
//正确匹配对象class Base{ };class Derived: public Base{ };int main(){ try{ throw Derived(); cout<<"This statement will not be executed."<<endl; } catch(Derived){ cout<<"Exception type: Derived"<<endl; } catch(Base){ cout<<"Exception type: Base"<<endl; } return 0;}
//正确匹配指针class Base{ };class Derived: public Base{ };int main(){ try{ throw new Derived(); cout<<"This statement will not be executed."<<endl; } catch(Derived*){ cout<<"Exception type: Derived"<<endl; } catch(Base*){ cout<<"Exception type: Base"<<endl; } return 0;}
//正确匹配引用class Base{ };class Derived: public Base{ };int main(){ try{ throw Derived(); cout<<"This statement will not be executed."<<endl; } catch(Derived&){ cout<<"Exception type: Derived"<<endl; } catch(Base&){ cout<<"Exception type: Base"<<endl; } return 0;}多级catch
try{ //可能抛出异常的语句}catch (exception_type_1 e){ //处理异常的语句}catch (exception_type_2 e){ //处理异常的语句}//其他的catchcatch (exception_type_n e){ //处理异常的语句}-
当异常发生时,程序会按照从上到下的顺序,将异常类型和 catch 所能接收的类型逐个匹配。一旦找到类型匹配的 catch 就停止检索,并将异常交给当前的 catch 处理(其他的 catch 不会被执行)。如果这一层没有找到匹配该异常的语句,就会交给更外层的try-catch来处理。如果最终也没有找到匹配的 catch,就只能交给系统处理,终止程序的运行。
-
如果抛出的异常不能被捕获,则会调用
std::terminate -
异常处理匹配时,只可以进行有限的类型转换。
- 向上转型(子转父)
- 注意会有提前匹配和对象切割问题。
//这版本**注意会有提前匹配问题。无论传递的是子类的对象还是指针都会提前匹配或对象切割**class Base{ };class Derived: public Base{ };int main(){try{throw Derived(); //抛出自己的异常类型,实际上是创建一个Derived类型的匿名对象.cout<<"This statement will not be executed."<<endl;}catch(Base){cout<<"Exception type: Base"<<endl;}catch(Derived){cout<<"Exception type: Derived"<<endl;}return 0;}/*有的编译器会提示:exception of type ‘Derived’ will be caught by earlier handler for ‘Base’最后异常是被第一块捕获的。*///这个版本调换了顺序。无论throw的是父类/子类的对象/指针,都会被正确匹配至实际类型。class Base{ };class Derived: public Base{ };int main(){try{throw new Derived();cout<<"This statement will not be executed."<<endl;}catch(Derived*){cout<<"Exception type: Derived"<<endl;}catch(Base*){cout<<"Exception type: Base"<<endl;}return 0;}const转换- 数组或函数指针转换
- 向上转型(子转父)
-
匹配上的未必是类型完全匹配那项,而在是最靠前的第一个匹配上的 catch 语句(最先匹配原则)。所以,派生类的处理代码 catch 语句应该放在基类的处理 catch 语句之前,否则先匹配上的总是参数类型为基类的 catch 语句,而能够精确匹配的 catch 语句却不能够被匹配上。
-
可以使用
catch(...)捕获所有异常。但是必须要放在最末尾,否则所有其后的块都不会被匹配。- 注意,在使用捕获所有异常的时候,不存在是使用值传递或引用传递。因为捕获所有异常等于什么都”做不了”。参数都没有名字,你无法访问异常对象。所以根本不存在值传递。或者说,使用捕获所有异常的时候,不会有任何异常对象本身被捕获。但是代码块会被调用。
栈回退/栈展开(stack unwind)
其实栈展开已经在前面说过,就是从异常抛出点一路向外层函数寻找匹配的 catch 语句的过程,寻找结束于某个匹配的 catch 语句或标准库函数 terminate。这里重点要说的是栈展开过程中对局部变量的销毁问题。我们知道,在函数调用结束时,函数的局部变量会被系统自动销毁,类似的,throw 可能会导致调用链上的语句块提前退出,此时,语句块中的局部变量将按照构成生成顺序的逆序,依次调用析构函数进行对象的销毁。
- 栈回退表这个数据结构会帮助编译器正确释放资源。
- 退栈的时候,栈上分配的东西(局部变量)都会被正确销毁。但是涉及到在堆上分配的资源则大概率会泄露。
异常对象的传递,尽量按值抛出,按引用传递(捕获)
我们说过异常对象是一个对象。我们可以自己设计它。但是具体传递当中有很多的要点。
- 异常对象可以通过引用传递。通过引用传递不仅可以实现多态,而且可以减少拷贝。
class A{public: A() :a(0){ cout << "A默认构造函数" << endl; } A(const A& rhs){ cout << "A拷贝构造函数" << endl; } ~A(){ cout << "A析构函数" << endl; }private: int a;};int main(){ try { A a ; throw a; } catch (A a) //注意这里 { ; } return 0;}/*A默认构造函数A拷贝构造函数A析构函数A拷贝构造函数A析构函数A析构函数*/- 第一次默认构造是
A a - 第一次拷贝构造是
throw a- 我们说过throw表达式是调用拷贝构造
- 第一次析构是析构掉对象
A a - 第二次拷贝构造是拷贝到catch块内的a
如果我们换成引用传递呢?
int main(){ try { A a ; throw a; } catch (A& a) //注意这里 { ; } return 0;}/*A默认构造函数A拷贝构造函数A析构函数A析构函数*/-
第一次默认构造是对象
A a -
第一次拷贝构造是
throw a -
由于我们是引用传递,所以没有额外的拷贝构造。
-
我们提到过,throw表达式创建的对象是在TIB块内。所以可以离开作用域。
-
注意,这里我们是创建对象后拷贝使用
throw拷贝了一个对象。如果此时我们直接throw A()会直接构造因为有编译器优化。
如果 catch 子句的形参是引用类型,那么对它所做的任何更改都会反映到异常对象之中,且如果以 throw; 重抛这个异常,那么它可以被另一个处理块观测到。如果形参不是引用,那么任何对它的更改都是局域的,且它的生存期在处理块退出时结束。
- 所以尽可能使用引用传递。尤其是当重抛一个一样的异常的时候,使用值传递会导致多个副本。
try catch中的多态
虽然catch匹配本身不能发生多态,但是其对象本身可以发生多态。上一节我们提到了,使用引用可以实现多态
class Base{ public: virtual void print(){ cout <<"base" << endl; }};class Derived: public Base{ public: virtual void print(){ cout <<"derived" << endl; } };
int main(){ try{ throw Derived(); //抛出自己的异常类型,实际上是创建一个Derived类型的匿名对象 cout<<"This statement will not be executed."<<endl; } catch(Base e){ //值传递。无法多态。 e.print(); //输出 base }
return 0;}我们上面使用了值传递,则无法多态。如果使用引用或指针传递则可以多态
int main(){ try{ throw Derived(); //抛出自己的异常类型,实际上是创建一个Derived类型的匿名对象 cout<<"This statement will not be executed."<<endl; } catch(Base& e){ //引用传递 虽然匹配无法多态,但是e本身可以多态。 cout <<"catch base" << endl; e.print(); //输出derive } catch(Derived& e){ cout <<"catch derived" << endl; e.print(); }
return 0;}/*catch base //这里还是发生了提前匹配。derived //对象本身可以多态。*/如果try中进行了内存分配,一定要记得在catch中或catch后释放它
int main(){ try { A* a = new A; throw a; } catch (A* a) { delete a; //如果不delete则会内存泄漏 } //或者放在这里也可以。 return 0;}这里我们在try内分配了内存,然后throw会拷贝a这个指针(浅拷贝)。catch会接收这个指针。所以我们必须在外部正确释放。
如果是这样:
int main(){ try { A* a = new A; throw *a; //啥情况??? } catch (A a) { ; } return 0;}/*A默认构造函数A拷贝构造函数A拷贝构造函数A析构函数A析构函数*/这是非常极端的例子。
- 第一次构造是new A
- 第一次拷贝构造是 throw *a 我们拷贝了指针a指向的对象。这非常离谱。
- 这时候原始a指针指向的对象无法析构。内存泄漏
- 第二次的拷贝构造是把throw拷贝的对象拷贝出来到catch块的a中。
- 然后throw的对象和catch的对象析构。
re-throw
我们可以在catch块内再次使用空语句throw;来直接进行异常的再次抛出。
class myexcept{ public:
string msg; myexcept(){ cout <<"--const except--" << endl; } myexcept(const myexcept& obj){ cout <<"--copy const except--" << endl; } myexcept(const string& s):msg(move(s)){ cout <<"--const except--" << endl; }; void what(){ cout << msg << endl; } ~myexcept(){ cout << "--desc except--" << endl; }};
void func(){ int errs = 0; for(int i = 0; i < 10; i++){ try{ cout << "try" << endl; throw myexcept("error occured"); } catch (myexcept& e){ cout <<"re-throw" << endl; e.msg = "too many err"; throw; } }}
int main(){ try{ func(); } catch(myexcept& e){ cout << "main" << endl; e.what(); }
return 0;}/*try--const except-- 构造异常对象没有拷贝构造是因为编译器优化。re-throw 进入catch准备rethrowmain 进入maintoo many err 信息已被修改--desc except-- 异常对象销毁。*/- 我们之前提到过,使用引用传递异常对象可以进行修改。尤其是在进行re-throw的时候。
- 我们看到信息被修改了,并且没有额外拷贝开销。
re-throw可以达成一些特殊目的
- 比如这段代码的目的是,只要是偶数就抛出异常。但是异常抛出次数小于等于4次的时候可以让程序继续运行。一旦大于4次就重抛至外部,修改异常信息并停止运行。
void func(){ int errs = 0; for(int i = 0; i < 10; i++){ try{ cout <<"current is: " << i << endl; if(i%2 == 0){ errs++; throw runtime_error("error occured");//注意这里 } } catch (runtime_error& e){ //注意这里 cout <<"error: " << e.what() << endl; if(errs >= 2){ e = runtime_error("too many errors"); //注意这里发生了赋值 throw e; } } }}
int main(){ try{ func(); } catch(runtime_error& e){ //注意这里 cout << e.what() << endl; }
return 0;}注意,我们这里throw的和catch的全部都是runtime_error对象而不是exception对象。
exception是runtime_error的父类。如果我们使用exception进行接受并且使用子类对象runtime_error进行赋值的话,则会发生切割。所以这里要格外注意。
构造函数和异常
- 构造函数中可以抛出异常,但是抛出的异常会导致该类析构函数无法被调用。因为被视为对象没有成功构造。会存在内存泄漏风险。
- 注意,不调用析构函数并不代表局部对象不会析构。该类蕴含的局部对象会析构。因为需要退栈。
- 也就是一定要注意本类析构函数的动作不会执行。如果本类的析构函数本来就不执行什么,那么久不会出现问题。但是如果本类析构需要进行资源清理,则会出现问题。
- 退栈的时候,栈上分配的东西(局部变量)都会被正确销毁。但是涉及到在堆上分配的资源则大概率会泄露。
- !!!!!如果委托构造函数在非委托构造函数成功完成后以异常退出,那么就会调用此对象的析构函数。!!!!!
class A{ public: A(){ cout <<"A const" << endl; } ~A(){ cout <<"A dest" << endl; }};class B{ public: B(){ cout <<"B const" << endl; } ~B(){ cout <<"B dest" << endl; }};class myobj{ public: A a; B b; myobj(){ cout <<"myobj const" << endl; throw runtime_error("runtime error"); //构造函数中抛出异常。 } ~myobj(){ cout << "myobj dest" << endl; }};
class myobj2 { public: A a; B b; myobj2() { cout << "myobj2 const" << endl; } myobj2(int x) : myobj2() { cout << "myobj2 int const" << endl; throw runtime_error("runtime error"); // 委托构造函数中抛出异常。 } ~myobj2() { cout << "myobj2 dest" << endl; }};
int main(){ try{ myobj a; } catch(exception& e){ cout <<"error catched" << endl; } return 0;}/*A constB constmyobj constB destA desterror catched注意! 本类析构没有正确调用。*/我们发现析构函数确实没有被调用。杂记2也提到了:
构造函数中可以抛出异常,但是抛出的异常会导致析构函数无法被调用。因为被视为对象没有成功构造。会存在内存泄漏风险
但是本类蕴含的A和B对象被正确析构了。
异常和委托构造
如果委托构造函数在非委托构造函数成功完成后以异常退出,那么就会调用此对象的析构函数。
看下这个小测试
try { myobj2 b;} catch (exception& e) { cout << "myobj2 error catched" << endl;}/*A constB constmyobj2 constmyobj2 dest // 注意 myobj2的析构函数正确调用B destA dest*/还是上面的代码。如果是委托构造中抛出异常,则该类析构可以正常调用。出自标准文档的except.ctor。 我理解是因为委托构造中使用的非委托构造结束的一刻,对象就被视为构造完毕了。所以是合理的。
构造函数异常导致的内存泄漏
假设我们有如下代码:
class A{ public: A(){ cout <<"A const" << endl; } ~A(){ cout <<"A dest" << endl; }};class B{ public: B(){ cout <<"B const" << endl; } ~B(){ cout <<"B dest" << endl; }};
class myobj{ public: A* ptra; B* ptrb; myobj(){ ptra = new A(); //分配资源 ptrb = new B(); throw runtime_error("runtime error"); //抛出异常 } ~myobj(){ cout << "myobj dest" << endl; delete ptra; //释放资源 delete ptrb; }};
int main(){ try{ myobj a; } catch(exception& e){ cout <<"error catched" << endl; } return 0;}
/*输出A constB consterror catched*/我们发现内存泄露了。原因和上一节提到的一样。所以如果在析构函数中抛出异常则必须要妥善处理。
解决方案:
- 在构造函数内也使用try catch捕获所有异常并重新抛出。
class myobj{ public: A* ptra; B* ptrb; myobj(){ try{ ptra = new A(); ptrb = new B(); throw runtime_error("runtime error"); } catch(...){ //捕获所有异常 delete ptra; delete ptrb; cout << "inner catched" << endl; throw; //重抛 } } ~myobj(){ cout << "myobj dest" << endl; delete ptra; delete ptrb; }};
int main(){ try{ myobj a; } catch(exception& e){ cout <<"error catched" << endl; } return 0;}- 或使用RAII如智能指针包裹
A/B对象。此时无需在构造函数内继续使用try-catch
class myobj{ public: shared_ptr<A> ptra; shared_ptr<B> ptrb; myobj(){ ptra = make_shared<A>(); //智能指针 ptrb = make_shared<B>(); //智能指针 throw runtime_error("runtime error"); } ~myobj(){ cout << "myobj dest" << endl; }};
int main(){ try{ myobj a; } catch(exception& e){ cout <<"error catched" << endl; } return 0;}再次注意。构造函数中的内存泄漏针对的是本类的内存泄漏。也就是try中分配的内存需要catch中释放。
如果抛出异常的构造函数的类没有在try中分配什么东西,那就不会泄露。
struct ExceptionObject{ int a; ExceptionObject() { throw "an exception"; }};int main(){ ExceptionObject* ptr = nullptr; try { ptr = new ExceptionObject(); //该new在构建对象的时候发现异常,则取消构造。并且调用delete释放。 } catch(...) { //delete or not delete ptr? } return 0;}**上面的漏了吗? 没漏。**因为ExceptionObject没有手动分配内存。我们下面看到的try里面的new在构建ExceptionObject对象的时候发现异常就会把自己的new释放。编译器会帮助我们。
如果初始化因抛出异常而终止(例如来自构造函数),那么 new 表达式在已经分配了任何存储的情况下会调用适当的解分配函数
这个解分配只解分配自己。
但是下面的漏了吗?
struct ExceptionObject{ int* a; ExceptionObject(){ a = new int(10); //漏了 throw "an exception"; }};int main(){ ExceptionObject* ptr = nullptr; try{ ptr = new ExceptionObject(); } catch(...){ //delete or not delete ptr? } return 0;}漏了。因为我们ExceptionObject有手动分配内存。ExceptionObject的析构不会调用。这时候就会出现泄漏
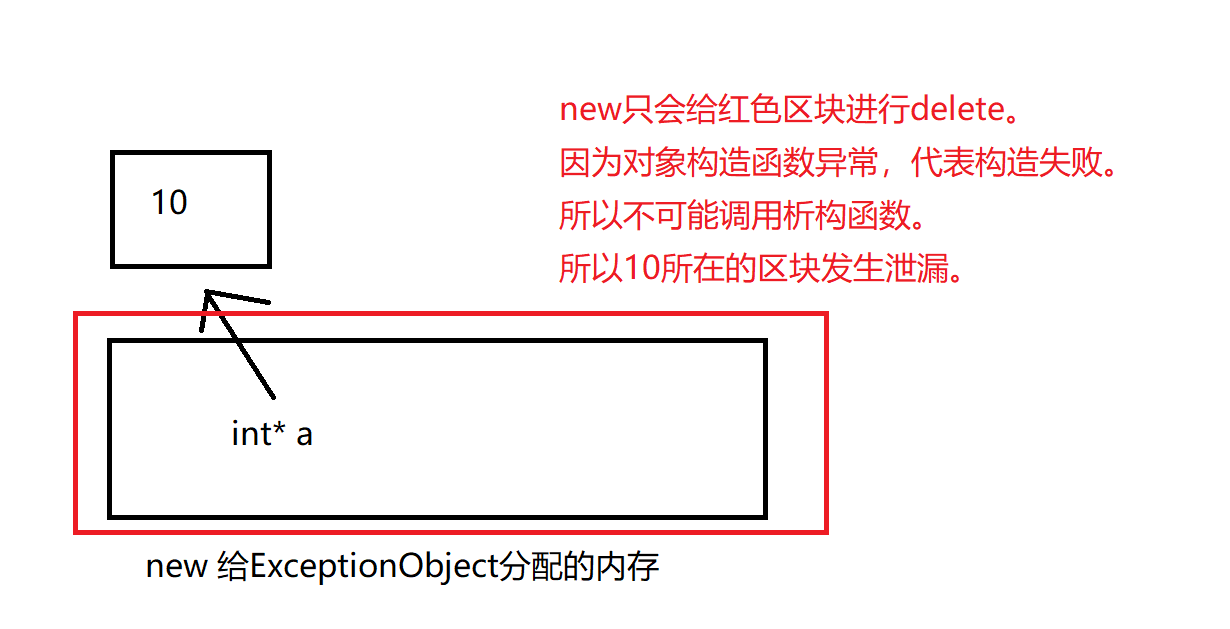
new在遇到异常的时候只会解分配自己分配的内存。ExceptionObject里面的那个指针分配的内存并不是这个new分配的。所以它不负责。
一个自定义异常对象的例子
class myExcept{ //异常对象 public: enum m_errtype{NO_ERR, LENGTH_ERR, VALID_ERR, BOTH_ERR}; //枚举类,更加美观 myExcept():m_ERRTYPE(NO_ERR){}; //默认构造函数,无异常 myExcept(int x):m_ERRTYPE(LENGTH_ERR), length(x){}; //构造函数1:目的是实现第1种异常对象的构造 myExcept(bool x):m_ERRTYPE(VALID_ERR), valid(x){}; //构造函数2:目的是实现第2种异常对象的构造 myExcept(int x,bool y):m_ERRTYPE(BOTH_ERR), length(x), valid(y){}; //构造函数3:目的是实现第3种异常对象的构造 void what() const{ //what函数模拟标准库exception类对象。这个函数会打印本类的具体错误。 if(m_ERRTYPE == LENGTH_ERR){ cout <<" EXCEPTION!! exceed length size: " << length << endl; } else if(m_ERRTYPE == VALID_ERR){ cout <<" EXCEPTION!! not valid state: " << valid << endl; } else if(m_ERRTYPE == BOTH_ERR){ cout <<" EXCEPTION!! exceed length: "<< length <<" and not valid state: " << valid << endl; } } private: m_errtype m_ERRTYPE; //错误类型 int length; // 具体资源状态。用于显示具体错误。 bool valid; // 具体资源状态。用于显示具体错误。};
class myobj{ public: int length; bool valid; myobj() = default; myobj(int x, bool y):length(x), valid(y){ cout << "myobj constructed" << endl; } void test_func(int x, bool y){ cout << "test func" << endl; if(x < 10 && y == false){ throw myExcept(x,y); } else if(y == false){ throw myExcept(y); } else if(x < 10){ throw myExcept(x); } } ~myobj(){ cout <<"myobj destructed" << endl; }};
int main(){ myobj obj(1,true); try{ obj.test_func(0, true); //调用时刻。 } catch(myExcept& e){ e.what(); } cout <<"main continued" << endl; return 0;}/*第一种 obj.test_func(0, true);myobj constructedtest func EXCEPTION!! exceed length size: 0main continuedmyobj destructed剩下的不举例了。*/函数try块 function-try-block
这个东西在构造函数使用初始化列表的情况下偶尔有用。它主要是把构造函数初始化列表中和函数体中的异常区别开来。
在进入任何构造函数上的函数 try 块的 catch 子句前,所有完整构造的成员和基类都会被销毁。
规则都一样。但是有一点不同:
- 在(构造)函数
catch块中:就算我们不显式的throw,编译器也会隐式安插throw。默认是重抛。所以在最外层依旧要再次处理这个异常。
它长这个样子:
class A{ public: int val; A(){ cout <<"A const" << endl; } A(int x):val(x){ cout <<"A const" << endl; } ~A(){ cout <<"A dest" << endl; }};class B{ public: int val; B(){ cout <<"B const" << endl; } B(int x):val(x){ cout <<"B const err" << endl; throw runtime_error("ERR"); //b的构造函数抛一个异常。 } ~B(){ cout <<"B dest" << endl; }};class myobj{ public: A a; B b; myobj(int x, int y) try: a(x), b(y){ //try在这里。在初始化列表前。 cout<<"myobj const" << endl; } catch(runtime_error& e){ //后面紧跟catch // cout << e.what() << endl; // throw; //这里就算不throw也会隐式安插throw //进入这个块之前,A会被析构。 } ~myobj(){ cout << "myobj dest" << endl; }};
int main(){ try{ myobj a(1,2); //由于myobj构造函数一定会再次重抛异常到外面。所以这里必须再次用try catch接一下。 } catch(runtime_error& e){ cout << e.what() << endl; }}noexcept
noexcept指明了函数不会抛出异常。这样做可以提升性能,因为编译期不会去思考栈展开的问题。但是有很多点需要注意:
-
只有异常说明不同的函数不能重载***(与返回类型相似,异常说明是函数类型的一部分,但不是函数签名的一部分)(C++17 起)***
-
如果虚函数不会抛出,那么它每个覆盖的函数的所有声明(包括定义)都必须不抛出,除非覆盖函数被定义为
delete- 也就是父类虚函数声明抛出异常,子类的虚函数重写的时候也必须声明抛出异常。
-
**不会抛出的函数允许调用有可能会抛出的函数。**每当抛出异常且对处理块的查找遇到了不会抛出的函数的最外层块时,就调用函数
std::terminate- 也就是函数自己不抛异常,但是不代表它们内部的调用不会抛出异常,并且编译器不会提供调用者与被调用者的
noexcept一致性检查。 - 当一个声明为
noexcept的函数抛出异常时,程序会被终止并调用std::terminate();
- 也就是函数自己不抛异常,但是不代表它们内部的调用不会抛出异常,并且编译器不会提供调用者与被调用者的
-
绝大多数情况下,析构函数会被编译器隐式添加
noexcept。- 如果希望析构函数抛出异常,必须显式使用
noexcept(false)指明
- 如果希望析构函数抛出异常,必须显式使用
-
函数指针及该指针所指的函数最好具有一致的异常说明。
-
在
typedef或类型别名中则不能出现noexcept。 -
在成员函数中,
noexcept说明符需要跟在const及引用限定符之后,而在final、override或纯虚函数的=0之前。
什么时候建议使用noexcept
以下指的是如果这些实现不抛出异常的话。
- 移动构造和移动赋值
- 尤其针对
vector而言。想要触发vector使用存储元素类型对应的移动构造时,则对应元素类型的移动构造必须声明为noexcept- 为什么?我们想一下:如果在扩容元素时出现异常怎么办?
- 当我们使用拷贝构造时:
- 申请新空间时出现异常:旧vector还是保持原有状态,抛出的异常交由用户自己处理。
- copy元素时出现异常:所有已经被copy的元素利用元素的析构函数释放,已经分配的空间释放掉,抛出的异常交由用户自己处理。
- 这样看起来比较不错。但是并没有移动。利用
move的交换类资源所有权的特性,使用vector扩容效率大大提高,但是当发生异常时怎么办?- 原有容器的状态已经被破坏,有部分元素的资源已经被偷走。若要恢复会极大增加代码的复杂性和不可预测性。所以只有当vector中元素的
move constructor是noexcept时,vector扩容才会采取move方式来提高性能。
- 原有容器的状态已经被破坏,有部分元素的资源已经被偷走。若要恢复会极大增加代码的复杂性和不可预测性。所以只有当vector中元素的
- 尤其针对
- swap
- 简单的函数。 例如获取类成员变量,类成员变量的简单运算等。
noexcept()的小技巧。
我们知道不会抛出的函数允许调用有可能会抛出的函数。但是这是有问题的。那么我们又没有办法让编译器帮我们做决定呢?
我们可以这样:
void test(int x){ //...}int sum(int x, int y) noexcept(noexcept(test(x))){ //...}noexcept(test(x))传入了一个我们希望检查是否noexcept的函数和其参数。编译器会在编译时检查这一点并根据结果为函数添加说明符。
https://www.cnblogs.com/RioTian/p/15115387.html
https://zhuanlan.zhihu.com/p/222167649
https://songlee24.github.io/2015/01/12/cpp-exception-in-constructor/
https://blog.csdn.net/liang19890820/article/details/120662921
https://blog.csdn.net/weixin_50640987/article/details/124406222
http://baiy.cn/doc/cpp/inside_exception.htm
lambda
我个人不太喜欢lambda。可读性感觉很一般。但是感觉大家都在用,那么在这里再次整理一下lambda。
另外一点是lambda和closure的关系。lambda表达式被用来创建closure类型。 来自这里
lambda 表达式是纯右值表达式,它的类型是独有的无名非联合体非聚合体类类型,被称为闭包类型,它(对于 实参依赖查找 而言)声明于含有该 lambda 表达式的最小块作用域、类作用域或命名空间作用域。
基本语法:
[capture](parameters) mutable可选 throw()可选 ->returntype{statement}-
[capture]:捕捉列表。捕捉列表总是出现在Lambda函数的开始处。- 在捕捉列表里面的参数我们称之为behavior parameter行为参数。
[]也是Lambda引出符。编译器根据该引出符判断接下来的代码是否是Lambda函数。捕捉列表能够捕捉上下文中的变量以供Lambda函数使用。- 如果把lambda当做容器的自定义排序或比较的函数对象使用,则一般都不用捕捉参数。捕捉参数可以理解为上下文所需要的内容。如果一个lambda只需要对传入的参数进行修改或访问,则不需要捕捉变量。如果需要lambda上下文中的变量,才需要进行捕捉。
- 捕获列表里面的变量将成为lambda这个匿名类的成员变量。根据捕捉方式决定其是否可以改变。
- 默认情况下,捕获列表内的变量不可修改。如要修改,必须给lambda表达式增添mutable关键字。
- 捕获列表内的变量如果按照值捕获,对其的修改不会影响外部变量。因为捕获列表内的变量成为匿名类的局部变量。并且是按照值拷贝的
- 捕获列表内的变量如果按照引用捕获,对其的修改则会影响外部变量。
-
(parameters):参数列表。与普通函数的参数列表一致。如果不需要参数传递,则可以连同括号“()”一起省略;- 参数列表里面的参数我们称之为call parameter调用参数。
-
mutable:mutable修饰符。默认情况下,Lambda函数总是一个const函数,mutable可以取消其常量性。在使用该修饰符时,参数列表不可省略(即使参数为空);- 注意,这个mutable针对的是捕获列表里面值传递的变量。而非函数入参。且引用传入的时候默认是可以修改的,可以不添加mutable
-
->return-type:返回类型。用追踪返回类型形式声明函数的返回类型。我们可以在不需要返回值的时候也可以连同符号->一起省略。此外,在返回类型明确的情况下,也可以省略该部分,让编译器对返回类型进行推导; -
{statement}:函数体。内容与普通函数一样,不过除了可以使用参数之外,还可以使用所有捕获的变量。
与**普通函数最大的区别是,除了可以使用参数以外,Lambda函数还可以通过捕获列表访问一些上下文中的数据。**具体地,捕捉列表描述了上下文中哪些数据可以被Lambda使用,以及使用方式(以值传递的方式或引用传递的方式)。语法上,在[]包括起来的是捕捉列表,捕捉列表由多个捕捉项组成,并以逗号分隔。捕捉列表有以下几种形式:
[]空表示不捕获[=]表示值传递方式捕获所有父作用域的变量(包括this)- 用值传递的捕捉方式时,类中会添加相应类型的非静态数据成员。运行的时候会用复制的值去拷贝初始化成员变量
[&]表示引用传递方式捕获所有父作用域的变量(包括this)[var]表示只以值传递方式捕获特定变量var[&var]表示只引用传递捕获特定变量var[=, &var]默认以值捕获所有变量,但是var是例外,通过引用捕获[&, var]默认以引用捕获所有变量,但是var是例外,通过值捕获[this]表示只以值传递方式捕获当前的this指针- 这里指的是复制指针。所以是值传递指针,但由于是指针,所以也是引用捕获当前对象。这里格外注意悬垂引用问题
[*this]:通过传值方式捕获当前对象 。也就是拷贝对象(C++17起)
上面提到了一个父作用域,也就是包含Lambda函数的语句块,说通俗点就是包含Lambda的“{}”代码块。上面的捕捉列表还可以进行组合,例如:
[=,&a,&b]表示以引用传递的方式捕捉变量a和b,以值传递方式捕捉其它所有变量;[&,a,this]表示以值传递的方式捕捉变量a和this,引用传递方式捕捉其它所有变量。 不过值得注意的是,捕捉列表不允许变量重复传递。例如:[=,a]这里已经以值传递方式捕捉了所有变量,但是重复捕捉a了,会报错的;[&,&this]这里&已经以引用传递方式捕捉了所有变量,再捕捉this也是一种重复。
针对匿名lambda,可以直接在其表达式结尾额外添加一组括号表示函数调用:
[](){cout <<"hello world" << endl;}(); //注意结尾额外的一组括号- 按值捕获一个变量后,如果在lambda表达式后方修改这个变量,不会影响到lambda内这个变量的值。也就是lambda表达式之前这个变量是什么,他在lambda表达式中表现的就是什么。这个变量后续的行为和lambda表达式无关。
int main(){ int val = 0; auto f = [val]() mutable{ //mutable是必须要写的。否则不可修改val cout << "val:" << val << endl; //0 val++; cout << "val:" << val << endl; //1 }; cout << val << endl; //0 val = 28; cout << val << endl;//28 f(); cout << val << endl;//28}//针对这个例子,每一次f()的调用影响的都是lambda内部的val变量为什么val=28没有改变外部的值?同时lambda内部的修改值没有影响到外面?
-
**lambda是一个匿名类,(也就是匿名的函数对象)。捕获的变量会变成这个匿名类的类成员变量。**如果按照引用捕获那么这个成员变量就是个引用。自然你在外部修改也会影响里面的值。正因为如此,如果按照值来捕获,在创建这个lambda表达式的那一刻,被按照值捕获的变量会被在这个匿名类内创建(拷贝)并按照它在这一行之前的那个值来进行附初值。
-
因为lambda的类型是匿名类,编译器认为每个lambda表达式都不同,哪怕定义完全一样其匿名类名也会不一样,所以lambda表达式只能用auto类型。
-
**lambda的默认构造函数和赋值操作默认是delete的。也就是说,lambda类型非可默认构造(C++20前)**但是,它有浅拷贝构造函数可被调用。而使用
decltype提取未计算的lambda表达式的类型是不允许的,但是,decltype提取已计算的的lambda表达式是可以的。-
auto g = [](int x){return x;}decltype(g) another = g; //可以,已计算的lambdadecltype(auto g = [](int x){return x;}) another = g; //不可以。未计算的lambda
-
-
lambda没有默认构造,没有拷贝赋值。有隐式生成的拷贝构造和移动构造。
-
lambda还有合成的用户定义转换函数。它的作用是返回一个函数指针。这个函数指针指向内部合成的静态成员函数(严格来说是public, 非虚,非explicit且const noexcept), 这个转换函数返回一个指向具有 C++ 语言连接的函数指针,调用该函数的效果与在默认构造的lambda类型实例上调用lambda类型的函数调用运算符
operator()的效果相同。- 最后一句话,我们可以理解为这个函数内部会调用本类的函数调用运算符
operator()。虽然事实并非如此,但是效果一致。 - !!!只有在捕获列表为空的时候才会合成此用户定义转换函数。!!!!
- 因此我们可以把lambda传入一个只接受函数指针的C函数。如
atexit
- 最后一句话,我们可以理解为这个函数内部会调用本类的函数调用运算符
所以我们是值传递。在lambda创建的那一刻。val已经被拷贝构造至匿名类内了。所以对类内的修改作用域只在lambda内部。自然不会影响外部。
具体例子就是这样:
//具体的类函数实现就是构造函数文件内的。这里不复制粘贴了。int main(){ myobj val (20); auto f = [val]() mutable{ //值传递 };}/*constcopy const //val被拷贝构造至lambda内。destdest*/int main(){ myobj val (20); auto f = [&val]() mutable{ //引用传递 };}/*const //引用传递不会发生拷贝。dest*/也就是说基本情况下,一个lambda的匿名类大概长这样。所以必须要显式使用mutable让其表示可以修改。
class Closure{ public:
ReturnType operator()(params) const{ //具体内容 }};https://www.jianshu.com/p/d686ad9de817
lambda的大小
我们说过lambda是匿名类,并且它会根据捕获的参数和使用的是引用捕获还是值捕获来使用对应的方式初始化匿名类内对应的成员。所以它的大小是因情况而异,取决于捕获的参数。
char a1[20];char b1[300];auto f = [a1](){}; //值捕获大小为20的数组auto f1 = [&a1](){}; //引用捕获大小为20的数组auto f2 = [b1](){}; //值捕获大小为300的数组auto f3 = [&b1](){}; //引用捕获大小为300的数组cout << sizeof(f) << endl; //20cout << sizeof(f1) << endl; //8cout << sizeof(f2) << endl;//300cout << sizeof(f3) << endl;//8所以这个lambda的大小会发生变化。
注意引用捕获导致的悬垂引用
std::function<int(int)> add_x(int x){ return [&](int a) { return x + a; };}因为参数x仅是一个局部变量,函数调用后就被销毁,但是返回的lambda表达式却引用了该变量
template <typename Func, typename... Args>std::function<void()> addTask(Func &&f, Args&&... args){ std::function<void()> func = [&](){ //注意这里是按照引用捕获了,有潜在bug f(std::forward<Args>(args)...); }; return func;}
void fuck1(int a){ std::cout << a << std::endl;}void fuck2(int a, const std::string& b, double c){ std::cout << a << b << c << std::endl;}int main(){ std::vector<std::function<void()>> vecs; int input = 10; vecs.push_back(addTask(fuck1, 10)); //注意这里是右值。 vecs.push_back(addTask(fuck2, 10, "abcde", 6.678)); vecs[0](); vecs[1]();
}我们的目的是使用std::function来包装一个任意多参数的无返回值的函数。上面的实现是错误的。因为我们一直是用右值引用把函数和参数传入addTask函数,然后lambda又使用引用捕获了参数。这里会非常危险。如果像addTask(fuck1, 10)这样使用,这个10会在当前行返回后失效。那么lambda捕获的对10的引用也会失效。当然如果能保证这个10一直有效,则没有问题。但问题就在于如何保证10一直有效。所以我们可以使用值传递。或者是使用std::bind完成我们的目的。这也就是为什么std::bind一直默认是拷贝传入。
其他资料
关于lambda和智能指针/移动捕获(通用捕获)相关内容查看智能指针章节。
注意,这个方法也可以用在当你想声明一个在lambda内部使用的变量时(理解为闭包类型的成员变量)
一些搭配容器的例子
int main(){ int x = 100; auto cmp = [](const Person& a, const Person& b){return (a.id < b.id); }; set<Person, decltype(cmp)> my_set(cmp); //set的自定义比较。利用decltype。必须传入构造函数。 my_set.emplace(3,1); my_set.emplace(1,2); my_set.emplace(2,2); for(auto& i:my_set){ cout << i.id << " " << i.day << endl; }
vector<Person> my_vec; my_vec.emplace_back(3,1); my_vec.emplace_back(1,2); my_vec.emplace_back(2,2); sort(my_vec.begin(), my_vec.end(), [](const Person& a, const Person& b){return a.id < b.id;}); //sort的自定义排序 for(auto& i:my_vec){ cout << i.id << " " << i.day << endl; } return 0;
}-
注意,在把lambda当做自定义比较器传入
set容器中的时候,不仅要在模板处指定类型,也要放入set的构造函数中。-
因为我们说过了。lambda没有默认构造函数和赋值操作。如果不把lambda作为参数传入进去的话,**
set的默认无参构造函数会调用lambda的无参构造函数。**但是lambda没有无参构造函数。所以会报错。我们必须要把lambda传入这样可以调用set的另一种有参构造函数。-
另一种有参构造:
-
set();//具体实现:set() : _Mybase(key_compare()) {} //直接构造函数对象。但是lambda没有默认构造。explicit set( const Compare& comp,const Allocator& alloc = Allocator() );//具体实现:explicit set(const key_compare& _Pred) : _Mybase(_Pred) {} //对函数对象进行拷贝。
-
-
为什么说lambda是一个非常方便的在运行时定义函数的功能
假设我们需要查找容器内小于特定数值的元素,如果使用bind,则会像是这样:
bool less_certain(int val, int elem){ return elem < val;}int main(){ vector<int>a{1,2,3,4,5,6,7}; int val = 7; int num = count_if(a.begin(), a.end(), bind(less_certain, val, std::placeholders::_1)); cout << num << endl;}在杂记3中讨论过,能用lambda就不要用bind。所以可以像这样使用。我们可以让lambda的功能依靠运行时参数
int main(){ vector<int>a{1,2,3,4,5,6,7}; int val = 7; int num = count_if(a.begin(), a.end(), [val](int elem){ return elem < val; }); cout << num << endl;}泛型lambda在模板笔记
模板lambda (C++20才正式合法)
泛型lambda其实是不显式指定模板形参的情况。而模板lambda是显示指定模板形参的情况
auto lambda = [](auto x) { // x 可以是任意类型,编译器会为每种调用生成对应的函数体 return x + 1;}; // 泛型lambda
auto lambda = []<typename T>(T x) { // 这里可以在 lambda 中显式使用 T return x + 1;};// 模板lambda一些用法、提示和注意事项
int main() { auto closure = []<typename T>(T x) { return [=] { std::cout << "Inner lambda prints: " << x << "\n"; }; }; auto closure2 = closure.template operator()<int>(10); auto same_as_closure2 = closure(10); // 和 closure2作用一致 auto closure3 = ([]<typename T>(T x) { return [=] { std::cout << "Inner lambda prints: " << x << "\n"; }; }).template operator()<int>(10); closure2(); same_as_closure2(); closure3();}我们知道lambda是有重载了operator()的类。所以我们既可以直接lambda(input)调用,也可以lambda.operator(input)调用。当有模板的时候,必须要显示使用lambda.template operator(input)来告诉编译器我们在这里要传递显式的模板参数。
所以此处,closure2和same_as_closure2是等价的。那么啥时候会有区别呢?那就是我们无法推导出模板形参类型的时候。假设这个情况:
auto closure4 = []<auto Fn>(int input) -> std::function<void(int)> { return [input](int x) -> void { cout << "input:" << input << endl; cout << "x: " << x << endl; Fn(input + x); };};auto closure5 = closure4.template operator()<[](int t) { cout << t << endl; }>(2);// auto same_as_closure5 = closure4(2);closure5(20);/*input:2x: 2022*/- 模板笔记中强调了,非类型模板参数不能用
typename,是一个具体的类型或者是auto、decltype(auto) - 此处用了
std::function做替代因为带捕获的无法转换为函数指针
我们如何理解这个呢? closure4返回了一个接受一个int作为入参的std::function对象,而closure4的形参也是int。所以说closure5接受的就是closure4返回的std::functoin对象。所以closure5的入参20是x。而closure5后面的实参2是closure4的形参。所以input是2.
此处我们故意模拟了必须要显示指定operator()的模板参数的情况。其实closure5形式上等价于same_as_closure5
在这个成员级guard中用到了此技法。
lambda在关键变量中的应用
在看吐槽微信扫描二维码出现bug的源码视频的时候学到了一个好用的小技巧。
首先就是不要重复创建变量
void func(int count){ int count2 = count; //不要重复创建变量 //.....}这样做非常不好,有损语义。因为你不好说count和count2有什么联系或者区别,这时候可以使用引用创建一个别名
void func(int count){ int& count2 = count; //不要重复创建变量 //.....}这时候有问题了,如果我想要的不是别名,而是一种修改过的值呢?比如:
count2 = 2 * count;这种语义下,单纯的别名就不太好用了。因为我们希望无论count何时何地被修改。count2永远是2* count。也就是这个语义永远成立。
那么我们可以考虑使用lambda把单纯的变量变成函数,比如:
void func(int count){ auto count2 = [&]{return 2* count;}; //使用lambda cout << count2() << endl; //注意,这样使用就需要函数调用了 这里是40 count = 200; cout << count2() << endl; //这里是400}int main(){ func(20); return 0;}这样就满足了我们想要的语义。
所以这里有一个技巧,也就是当某一个变量可以被某几个变量计算出来,并且重复计算代价比较低(重复计算的代价比单纯的计算后储存高不了多少的时候),可以把变量换成lambda函数,让它在调用时计算。这样比较减少重复代码。
lambda和一元加法
在这篇文章中,我们发现yyjson中有一段关于lambda的奇怪用法
using alc_size_t = std::uint16_t;alc.malloc = +[](void *ctx, size_t size_native) noexcept -> void * { ... };alc.realloc = +[](void *ctx, void *ptr, size_t old_size_native, size_t size_native) noexcept -> void * { ... };alc.free = +[](void *ctx, void *ptr) noexcept -> void { ... };为啥lambda前面要跟着个加法?
在cppreference关于算术运算符的介绍中,我们看到了内建一元加法的作用:
于内建一元加运算符,表达式 必须是算术、无作用域枚举或指针类型的纯右值。如果表达式 具有整数或无作用域枚举类型,那么对它实施整数提升。结果的类型是(可能为提升后的)表达式 的类型。
内建的提升操作的结果是表达式 的值。如果操作数为提升后的整数或指针类型的纯右值,则内建的一元加运算为无操作。否则,整数提升或左值到右值、数组到指针、函数到指针或用户定义转换会更改操作数的类型或值类别。例如在一元加表达式中 char 会被转换为 int ,而非泛型且无捕获的 lambda 表达式会被转换为函数指针(C++11 起)。
其实核心就是使用一元加法触发一下lambda到函数指针的隐式类型转换。多说一句,一元加法的唯一作用就是进行类型转换。
函数指针和函数对象的性能差异。(依靠编译器实现)
在很多情况下,比如针对容器或算法使用特定的排序要求、我们可能会传递一个函数对象或函数指针。
函数对象类型可以是:
- 函数指针类型
- 重载了
operator()的 类类型(有时被称为仿函数),这其中包含 lambda 函数 - 包含一个可以产生一个函数指针或者函数引用的转换函数的 类类型。
出自 C++模板第二版 — 11.1
这样的类型对应的值被称之为函数对象。
如果一个回调是通过函数指针实施的,那么性能较差。因为函数指针是通过地址调用的函数。该地址在编译时可能不可见。所以编译器较难优化(比如施加inline)
如果是通过函数对象实施,由于对象是固定的。对象位置在编译时可知。所以编译器可以针对其进行优化。
当然了,如果我们需要在运行时动态替换某些需要传入的回调,那么还是得使用函数指针。
C中的变长原始数组
struct test{ int val; char c; int arr[0]; //使用0来进行数组占位。分配一个首地址};
int main(){
test* T = (test*)malloc(sizeof(test) + sizeof(int) * 40); //给结构用malloc分配大小。大小为结构体长度+你想给数组分配多大。这里分了40个int长度也就是对应int a[40] T->val = 5; T->c = 'a'; T->arr[30] = 5; cout << T->arr[30] << endl; free(T); //因为是用的malloc来分配内存所以使用free释放 return 0;}-
注意,零长数组本身不占用内存空间。它只是首地址。
-
请记住。原始数组名称本身并不是指针。我们说的是原始数组的名称是数组首元素的地址
- 一定要区分指针和地址的区别。地址可以隐式转换成指针而已。
- 也就是说若
array是一个原始数组,则以下关系为真:
array = &array[0];
副作用和序列点 和 求值顺序
副作用
表达式有两种功能:
-
每个表达式都产生一个值( value )
-
同时可能包含副作用( side effect )。
-
访问(读或写)
volatile泛左值所指代的对象,修改(写入)对象,调用库 I/O 函数,或调用任何做出这些操作的函数都是副作用 -
副作用的其中一点是指改变了某些变量的值。 如:
-
20 -
这个表达式的值是
20。它没有副作用,因为它没有改变任何变量的值。 -
x=5 -
这个表达式的值是
5。它有一个副作用,因为它改变了变量x的值。 -
x=y++ -
这个表达示有两个副作用,因为改变了两个变量的值。
-
x=x++ -
这个表达式也有两个副作用,因为变量
x的值发生了两次改变。
-
-
序列点 (C++11前)
顺序点的意思是在一系列步骤中的一个“结算”的点,语言要求这一时刻的求值和副作用全部完成,才能进入下面的部分。在C/C++中只有以下几种存在顺序点:
-
分号(每一个完整表达式结尾)
-
未重载的逗号运算符的左操作数赋值之后(即
,处)-
注意逗号运算符有时候需要加括号来避免歧义
-
int a = funca(), funcb(), funcc(); //不行,只调用了funcaint a = (funca(), funcb(), funcc()); //加了括号可以。
-
-
未重载的
||运算符的左操作数赋值之后(即||处) -
未重载的
&&运算符的左操作数赋值之后(即&&处) -
三元运算符
? :的左操作数赋值之后(即?处) -
在函数所有参数赋值之后但在函数第一条语句执行之前。(调用函数时,所有的函数实参的求值后有个序列点。发生于函数体内任何表达式或语句的执行前)
-
在函数返回值已拷贝给调用者之后但在该函数之外的代码执行之前。(对函数的返回值进行复制后,并在函数外任何表达式执行前有一个序列点)
-
每个基类和成员初始化之后
-
在每一个完整的变量声明处有一个顺序点,例如
int i, j;中逗号和分号处分别有一个顺序点 -
for循环控制条件中的两个分号处各有一个顺序点。
对于任意一个顺序点,它之前的所有副作用都已经完成,它之后的所有副作用都尚未发生。
在两个顺序点之间,子表达式求值和副作用的顺序是不同步的。如果代码的结果与求值和副作用发生顺序相关,称这样的代码有不确定的行为(unspecified behavior).而且,假如期间对一个内建类型执行一次以上的写操作,则是未定义行为. 即:标准规定,在两个序列点之间,一个对象所保存的值最多只能被修改一次。
也就是说:**任意两个顺序点之间的副作用的发生顺序都是未定义的.**如:
a() + b() + c();这个表达式有一个序列点,也就是结尾的分号处。
由于 operator+ 的从左到右结合性被分析成 (a() + b()) + c(),但在运行时可以首先、最后或者在 a() 和 b() 之间对c()求值:
按顺序早于(C++11/17起)
包括这个回答
我们可以精简出一些规则:
The following expressions are evaluated in the order a, then b:
a.ba->ba->*ba(b1, b2, b3) // b1, b2, b3 - in any orderb @= a // '@' means any operatora[b]a << ba >> b
注意,a(b1, b2, b3) 这种函数调用表达式里面的顺序依旧是未指定的。比如foo(s(), g(), h()) 里面 s(), g(),和 h()的调用顺序是未指定的。
可变参数宏
void test(int a, ...){ //第一个参数表明后面一共有几个参数。 va_list args; //定义一个可变参数列表 va_start(args, a); //初始化可变参数列表 for(; a > 0; a--){ cout << va_arg(args, int) << endl; //使用va_arg访问下一个可变参数函数参数。第二个参数是传入参数类型 } va_end(args); //释放args}
int main(){ test(4,10,9,8,7); return 0; /* 输出: 10 9 8 7 */}/*注意C语言里的printf就是这个效果。C自带的printf函数是根据第一个参数format的占位符解析出后面的变参个数和类型,通过va_arg迭代去获取变参再填充到占位符上输出。*/可变参数宏可以让我们给一个函数增添变参特性。在C++中可以使用initializer list完成这件事
宏的三个特殊符号 #, ## , #@
-
#define ToString(x) #x- 意思是给
x加双引号。比如 char str = ToString(123132);就成了str="123132";
- 意思是给
-
#define Conn(x,y) x##y- 意思是
x连接y int n = Conn(123,456);结果就是n=123456;char* str = Conn("asdf", "adf");结果就是str = "asdfadf";- 当可变参数宏`VA_ARGS“为空的时候, 这样使用可以让编译器去除前面的多余逗号
##__VA_ARGS__- 可以查看项目相关的笔记. 里面写过
- 意思是
-
#define ToChar(x) #@x- 意思是给
x加上单引号,结果返回是一个const char char a = ToChar(1);结果就是a='1';
- 意思是给