
存储类说明符
这是一个被我忽视了的细节。在官方文档中提到了:
-
auto或 (C++11 前)无说明符 - 自动存储期。- 这类对象的存储在外围代码块开始时分配,并在结束时解分配。未声明为
static、extern或thread_local的所有局部对象均拥有此存储期。
- 这类对象的存储在外围代码块开始时分配,并在结束时解分配。未声明为
-
register- 自动存储期,另提示编译器将此对象置于处理器的寄存器。(弃用) (C++17 前) -
static- 静态或线程存储期和内部链接。 -
extern- 静态或线程存储期和外部链接。 -
thread_local- 线程存储期。 (C++11 起) -
mutable- 不影响存储期或链接。解释见 const/volatile。
static, extern 和 thread_local 不必多说,这里主要关注第一个自动储存期。
什么是自动储存期?
我们知道,变量一般存在下面地方。
-
全局变量和静态变量:储存在静态存储区(比如BSS段和数据段)
-
常量:依赖于实现和上下文。一般来说,全局常量存储在静态储存区的数据段或代码段。局部常量储存在栈段。
-
局部变量:栈区。储存在动态存储区
-
new的变量:堆区。储存在动态存储区
但是注意,当有如下代码
int main(){ int* ptr = new int(5); return 0;}ptr本身没有加储存类说明符,说明是自动存储期。我们查看上下文发现是在局部的变量。所以指针ptr自己在栈区。而new出来的东西在堆区。也就是栈上的指针指向了堆区的数据。
自动储存期指的是变量分配在哪是依靠上下文决定的。它并不一定在栈上。
举例子:
int main(){ Object obj; //什么意思? return 0;}- 要回答这个问题,我们首先要理解这个语句是什么意思。这行语句的含义是,使对象
obj具有自动储存期的性质。所谓自动储存期,意思是这个对象的存储位置取决于其声明所在的上下文。
此时我们看到,这个语句出现在函数内部并且没有其他修饰符,那么它就在栈上创建对象。
**如果这个语句不是在函数内部,而是作为一个类的成员变量,则取决于这个类的对象是如何分配的。**考虑下面的代码:
class myClass{ public: Object obj; //它在哪?};int main(){ myClass* ptr = new myClass; return 0;}- 指针
ptr所指向的对象在堆上分配空间。但是因为Object obj;语句的含义是“变量具有自动存储期”。我们查看其上下文,发现包含ptr->obj的变量处于堆上。所以,ptr->obj也是在堆上创建的。
我们继续看下面的:
int main(){ Object *ptr; ptr = new Object; return 0;}Object *ptr;代表,指针ptr是自动存储的。查看上下文发现是在函数内部,所以ptr是栈上创建的。而下面一行语句则指出,这个指针所指向的对象是在堆上面分配的。如果这两行语句出现在一个函数内部,意味着当函数结束时,ptr会被销毁,但是它指向的对象不会。因此,如果不对指向的资源进行释放,会造成内存泄漏。因为那时堆上的这个地址的资源会变为不可达。
继续看下面的:
int main(){ Object obj; Object* ptr = &obj; return 0;}- 这里我们发现,
obj是自动储存期并且在栈上。ptr也是自动储存期,也在栈上。所以这个指针指向的对象也在栈上。所以不对其处理也不会导致泄漏问题。因为都是栈上的资源。
可重入函数 和 不可重入函数
-
在实时系统的设计中,经常会出现多个任务调用同一个函数的情况。如果有一个函数不幸被设计成为这样:不同任务调用这个函数时可能修改其他任务调用这个函数的数据,从而导致不可预料的后果。这样的函数是不安全的函数,也叫不可重入函数。
-
相反,肯定有一个安全的函数,这个安全的函数又叫可重入函数。那么什么是可重入函数呢?所谓可重入是指一个可以被多个任务调用的过程,任务在调用时不必担心数据是否会出错。
-
一个可重入的函数简单来说就是可以被中断的函数,也就是说,可以在这个函数执行的任何时刻中断它,转入OS调度下去执行另外一段代码,而返回控制时不会出现什么错误;而不可重入的函数由于使用了一些系统资源,比如全局变量区,中断向量表等,所以它如果被中断的话,可能会出现问题,这类函数是不能运行在多任务环境下的。
-
也可这样理解,重入即表示重复进入,首先它意味着这个函数可以被中断,其次意味着它除了使用自己栈上的变量以外不依赖于任何环境(包括 static),这样的函数就是purecode(纯代码)可重入,可以允许有该函数的多个副本在运行,由于它们使用的是分离的栈,所以不会互相干扰。如果确实需要访问全局变量(包括 static),一定要注意实施互斥手段。可重入函数在并行运行环境中非常重要,但是一般要为访问全局变量付出一些性能代价。
-
编写可重入函数时,若使用全局变量,则应通过关中断、信号量(即P、V操作)等手段对其加以保护。
例子:
假设 Exam 是 int 型全局变量,函数 Squre_Exam 返回 Exam 平方值。那么如下函数不具有可重入性。
int Exam = 0;unsigned int example( int para ){ unsigned int temp; Exam = para; // (**) temp = Square_Exam( ); return temp;}此函数若被多个进程调用的话,其结果可能是未知的,因为当(**)语句刚执行完后,另外一个使用本函数的进程可能正好被激活,那么当新激活的进程执行到此函数时,将使 Exam 赋与另一个不同的 para 值,所以当控制重新回到 temp = Square_Exam( ) 后,计算出的temp很可能不是预想中的结果。此函数应加锁。
int Exam = 0;unsigned int example( int para ){ unsigned int temp; [申请信号量操作] //(1) 加锁 Exam = para; temp = Square_Exam( ); [释放信号量操作] // 解锁 return temp;}可重入函数特点:
- 没有静态数据结构
- 不返回指向静态数据的指针
- 所有函数数据由函数的调用者提供
- 使用
auto变量,或通过全局变量的拷贝来保护全局变量 - 若必须访问全局变量,则利用互斥信号保护
- 不调用不可重入函数
- 在unix里面通常都有加上_r后缀的同名可重入函数版本。如果实在没有,不妨在可预见的发生错误的地方尝试加上保护锁同步机制等等
不可重入函数特点:
-
函数中使用了静态变量,无论是全局静态变量还是局部静态变量
-
函数返回静态变量
-
函数中调用了不可重入函数
- 如函数体内调用了
malloc()或者free()函数 或者printf()函数printf--------引用全局变量stdoutmalloc--------全局内存分配表free--------全局内存分配表
- 如函数体内调用了
-
函数体内调用了其他标准I/O函数
-
函数是singleton中的成员函数,而且使用了不属于线程独立存储的成员变量
满足下列条件的函数多数是不可重入(不安全)的:
-
函数体内使用了静态的数据结构;
-
函数体内调用了
malloc()或者free()函数; -
函数体内调用了标准 I/O 函数。
保证函数的可重入性的方法:
- 在写函数时候尽量使用局部变量(例如寄存器、堆栈中的变量);
- 对于要使用的全局变量要加以保护(如采取关中断、信号量等互斥方法),这样构成的函数就一定是一个可重入的函数。
可重入规则改写不可重入函数:
把一个不可重入函数变成可重入的唯一方法是用可重入规则来重写它。
可重入规则:
-
不要使用全局变量。如果必须使用记得用互斥信号量保护,因为别的代码很可能修改这些变量值
-
在和硬件发生交互的时候,切记执行类似
disinterrupt()之类的操作,就是关闭硬件中断。 -
完成交互记得打开中断,在有些系列上,这叫做“进入/退出核心”或者用
OS_ENTER_KERNAL/ OS_EXIT_KERNAL来描述。 -
不能调用任何不可重入的函数。
-
谨慎使用堆栈。最好先在使用前先
OS_ENTER_KERNAL。
总之,必须保证中断是安全的
委托构造函数
委托构造函数允许在同一个类中一个构造函数调用另外一个构造函数,可以在变量初始化时简化操作。
class A { public: A(){} A(int a):a_(a){}
A(int a, int b):a_(a), b_(b) {} // 好麻烦
A(int a, int b, int c): a_(a), b_(b), c_(c) {} // 好麻烦
int a_; int b_; int c_;};
//下面是使用委托构造函数class mod_A { public: mod_A(){} mod_A(int a): a_(a) { cout <<"1param" << endl; }
mod_A(int a, int b) : mod_A(a) { //委托构造函数,注意使用后对其他成员不可再使用构造函数初始化列表初始化其他成员。 cout <<"2param" << endl; b_ = b; } mod_A(int a, int b, int c) : mod_A(a, b) { cout <<"3param" << endl; c_ = c; }
int a_; int b_; int c_;};int main(){ mod_A obj1(1); mod_A obj2(1,2); mod_A obj3(1,2,3); return 0;}/*obj1:1param
obj2:1param2param
obj3:1param2param3param*/注意。每一个构造函数函数体内的打印是必须等待构造函数初始化列表执行完毕后才能调用的。这个比较好理解。比如obj3为例。首先调用了第二个委派,然后调用第一个委派。第一个委派输出1param,然后执行完毕返回至第二个委派输出2param,然后执行完毕返回至第三个构造函数输出3param结束。
也可以逆序写:
class mod_A { public: mod_A(){} mod_A(int a): mod_A(a,0){ //委派到下面的 cout <<"1param" << endl; }
mod_A(int a, int b):mod_A(a, b, 0){ //再委派到下面的 cout <<"2param" << endl; } mod_A(int a, int b, int c){ cout <<"3param" << endl; a_ = a; b_ = b; c_ = c; }
int a_; int b_; int c_;};int main(){ mod_A obj1(1); mod_A obj2(1,2); mod_A obj3(1,2,3);}/*obj1:3param2param1param
obj2:3param2param
obj3:3param*/我们发现明明是正序调用但是为啥是逆序输出呢?也是因为在每一个构造函数函数体内的打印是必须等待构造函数初始化列表执行完毕后才能调用的。所以比如obj1为例,调用了第二个委派,然后调用第三个委派,输出3param,然后执行完毕返回至第二个委派输出2param,然后执行完毕返回至第一个委派输出param1
注意事项:
- 注意委托构造函数不能具有其他成员初始化表达式,成员初始化列表只能包含一个其它构造函数,不能再包含其它成员变量的初始化,且参数列表必须与构造函数匹配。也就是对其他成员不可使用构造函数初始化列表。我们不能在初始化列表中既初始化成员,又委托其他构造函数完成构造。
- 所以如果委托构造函数要给变量赋初值,初始化代码必须放在函数体中。如上面代码所示。
mod_A(){}mod_A(int a): a_(a) {}mod_A(int a, int b) : mod_A(a), b_(b) {} //错误。委托构造函数对其他成员不可使用构造函数初始化列表。-
在构造函数较多的时候,我们可能拥有多个委托构造函数,而一些目标构造函数很可能也是委托构造函数,这样依赖,我们就可能在委托构造函数中形成链状的委托构造关系,形成委托坏(Delegation Cycle)。
-
如果在委托构造函数中使用try,可以捕获目标构造函数中抛出的异常。
继承构造函数
继承构造函数可以让派生类直接使用基类的构造函数,如果有一个派生类,我们希望派生类采用和基类一样的构造方式,可以直接使用基类的构造函数,而不是再重新写一遍构造函数
class A { public: A(){} A(int a): a_(a) {}
A(int a, int b) : A(a) { //委托构造 b_ = b; } A(int a, int b, int c) : A(a, b) { //委托构造 c_ = c; }
int a_; int b_; int c_;};
class B:public A{ public: B() {} B(int a) : A(a) {} // 好麻烦 B(int a, int b) : A(a, b) {} // 好麻烦 B(int a, int b, int c) : A(a, b, c) {} // 好麻烦 B(int a, int b, int c, int d) : A(a, b, c), d_(d) {} // 注意这不是委托构造,所以自己的成员可以放入初始化列表。 int d_;};
//下面使用继承构造class mod_B:public A{ public: using A::A;};如果 using 声明指代了正在定义的类的某个直接基类的构造函数(例如 using Base::Base;),那么在初始化派生类时,该基类的所有构造函数(忽略成员访问)均对重载决议可见。
如果重载决议选择了继承的构造函数,那么如果它被用于构造相应基类的对象时可访问,它也是可访问的:引入它的 using 声明的可访问性被忽略。
如果在初始化这种派生类对象时重载决议选择了继承的构造函数之一,那么用这个继承的构造函数对从之继承该构造函数的
Base子对象进行初始化,而Derived的所有其他基类和成员,都如同以预置的默认构造函数一样进行初始化(如果提供默认成员初始化器就会使用它,否则进行默认初始化)。整个初始化被视作单个函数调用:继承的构造函数的各形参的初始化,按顺序早于派生类对象的任何基类或成员的初始化。
注意事项:
-
继承构造函数无法初始化派生类数据成员,继承构造函数的功能是初始化基类,对于派生类数据成员的初始化则无能为力。解决的办法主要有两个:
- 可以通过 =、{} 对非静态成员快速地就地初始化,以减少多个构造函数重复初始化变量的工作,注意初始化列表会覆盖就地初始化操作(这句话没有别的意思。就是如果一个元素既被就地初始化(如
int val = 10),又被置入初始化列表,则最后的元素的值会是初始化列表的值。非常直观好理解)。
class mod_B:public A{public:using A::A;int _d = 10;};- 新增派生类构造函数,使用构造函数初始化列表初始化
class mod_B:public A{public:using A::A;mod_B(int a, int b, int c, int d): A(a, b, c), d_(d){} // 注意这不是委托构造,所以自己的成员可以放入初始化列表。int d_;}; - 可以通过 =、{} 对非静态成员快速地就地初始化,以减少多个构造函数重复初始化变量的工作,注意初始化列表会覆盖就地初始化操作(这句话没有别的意思。就是如果一个元素既被就地初始化(如
-
构造函数拥有默认值会产生多个构造函数版本,且继承构造函数无法继承基类构造函数的默认参数,所以我们在使用有默认参数构造函数的基类时就必须要小心。
class A{public: A(int a = 3, double b = 4):m_a(a), m_b(b){} void display() { cout<<m_a<<" "<<m_b<<endl; }
private: int m_a; double m_b;};
class B:public A{ public: using A::A;};那么A中的构造函数会有下面几个版本:
A() //默认无参构造A(int) //只输入一个值,第二个值采用默认值A(int,double) //输入两个值,也就是忽视默认值A(const A&) //拷贝构造。那么B中对应的继承构造函数将会包含如下几个版本:
//同上B()B(int)B(int,double)B(const B&)注意没有A(double) 或 B(double) 因为不可以第一个有默认值而第二个没有默认值。也就是从第一个有默认值后面的参数都必须有默认值。
- 多继承的情况下,继承构造函数会出现“冲突”的情况,因为多个基类中的部分构造函数可能导致派生类中的继承构造函数的函数名与参数相同,即函数签名。
=default 类的默认函数
我们有如下代码
class myobj{ public: myobj() = default; myobj(int a, int b){ cout <<"two" << endl; }};
int main(){ myobj(1,2); myobj s; //注意这里 return 0;}如果此时我们只有第二个带参数的构造函数。如果我们执行一个新建一个对象但不提供参数,则编译器无法找到合适的构造函数。会报错。
只要我们有定义的构造函数,编译器无论如何都不会额外生成构造函数。
所以此时我们想执行myobj s应该怎么办?
- 要么手写一个空构造函数 如
myobj(){}- 要么使用
=default。
myobj() = default;-
如果使用default指示的办法,可以产出比用户定义的无参构造函数性能更优的代码(毕竟是编译器干活)
-
还有一个作用可以让使用者一眼就看出这是一个合成版本的构造函数(相当于知道类的作者没干其他事情)
-
在用户没有提供构造函数,析构函数,拷贝构造函数,拷贝赋值函数,移动构造函数和移动赋值函数这六大类特殊函数的时候,编译器会提供默认版本。如果某一个函数被实现,则该函数的默认版本将不复存在。
-
=default是函数定义
=delete 弃置函数
果使用特殊语法
= delete ;取代函数体,那么该函数被定义为弃置的(deleted)。任何弃置函数的使用都是非良构的(程序无法编译)。这包含调用,包括显式(以函数调用运算符)及隐式(对弃置的重载运算符、特殊成员函数、分配函数等的调用),构成指向弃置函数的指针或成员指针,甚至是在不潜在求值的表达式中使用弃置函数。但是可以隐式 ODR 使用刚好被弃置的非纯虚成员函数。如果函数被重载,那么首先进行重载决议,且只有在选择了弃置函数时程序才非良构
函数的弃置定义必须是翻译单元中的首条声明:已经声明过的函数不能声明为弃置的:
- 和
=default不同,=delete可以用于任何函数。
**先说结论:=delete修饰的弃置函数会参与重载决议。因为弃置函数修饰的是定义,也就是指示定义被删除。而符号需要被保留,因为所有查找和重载解析都发生在删除的定义被记录之前。同时,另一个原因是符合语义规则。**比如下面这个例子
struct onlydouble { onlydouble(int) = delete; onlydouble(double){ cout<<"called double" << endl; }};假设delete的含义是完全删除函数,则上面等同于下面:
struct onlydouble { onlydouble(double){ cout<<"called double" << endl; }};随后,我们这样的调用是合法的
int a = 200;onlydouble obj(a);但是从语义角度来说,我们不希望这样做。我们希望不接受int为入参。
所以说=delete的含义只是删除了定义,并不删除声明。所以说我们按照第一个例子调用的话是不合法的。因为找到了完全匹配的函数,此时重载决议已经结束。但是函数被声明为=delete,等于发现了函数是弃置的,非良构。这时候编译器就会发出提示,报错。
- 归根结底:
=delete的意思是“禁止使用”而不是“这个不存在”- 可以把
=delete理解为=disable
- 可以把
就像我们调用了一个声明拷贝构造为delete的类的拷贝构造函数时,报错提示的是调用了delete的函数,而非未定义的标识符。
=delete是函数定义。
https://www.open-std.org/jtc1/sc22/wg21/docs/papers/2007/n2346.htm#delete
用户提供的函数
如果一个函数由用户声明且没有在它的首个声明被显式预置或显式弃置,那么它由用户提供。由用户提供的显式预置的函数(即在它的首个声明后被显式预置)在它被显式预置的地方定义;如果该函数被隐式定义为弃置的,那么程序非良构。需要为不断变化的代码库提供稳定的二进制接口的情况下,在函数的首个声明后再定义为预置可以保证执行效率,也能提供简明的定义。
- 注意,是首个声明被显式预置或显式弃置的时候,不是由用户提供的。三个要点:首个,显式预置或弃置,这时候不是用户提供的。,所以说
=default和=delete修饰的函数不一定是不是由用户提供的。
// trivial 的所有特殊成员函数都分别在它们的首个声明处被显式预置,因此它们都不由用户提供struct trivial{ trivial() = default; trivial(const trivial&) = default; trivial(trivial&&) = default; trivial& operator=(const trivial&) = default; trivial& operator=(trivial&&) = default; ~trivial() = default;};
struct nontrivial{ nontrivial(); // 首个声明,此处并没有在它的首个声明被显式预置或显式弃置。所以它是用户提供的。};
// 没有在首个声明处被显式预置,// 因此该函数由用户提供并在此定义nontrivial::nontrivial() = default;用户声明的函数
只要写了声明就是用户声明的函数
用户定义的函数
就是函数不仅有声明还有定义。但是没找到这个词汇的专业解释。
编译期和运行期的思考
-
类是编译期的概念,也是“访问权限”、“成员数据”、“成员函数”这几个概念的“作用域”。
- 意思就是非法访问的报错是编译期就会出现问题。
-
而对象的作用域是运行期。它包括类的实例、引用和指针。
- 所以我们说类对象的虚函数表指针是运行期确定的。因为编译期间不会给对象分配内存(new是运行期的东西,静态的数据是编译期)。
-
编译期是指把你的源程序交给编译器编译的过程,最终目的是得到obj文件,链接后生成可执行文件(预处理、编译、汇编和连接)。运行期指的是你将可执行文件交给操作系统(输入文件名,回车)执行、直到程序执行结束。执行的目的是为了实现程序的功能 。
-
编译时不分配内存
- 编译期分配的内存,就比如静态,全局变量,全局常量。这是在编译的时候确定的。编译时分配内存”是指“编译时赋初值”,它只是形成一个文本,检查无错误,但是它并没有分配内存空间,而是类似一个占位符的检查,比如看看你在的位置对吗,这个位置该你占位嘛。记住,此时只是根据声明时的类型进行占位,到以后程序执行时分配内存才会正确。所以声明是给编译器看的
- 编译期内存错误,就是比如某个数据段DATA段或者CODE段等等,超过跑这个程序的目标机的存储器的限制。
- 比如一个全局数组
int array[100];由于他被分配在.data/.bss部分,所以编译器在编译期间决定将要把数组分配在该静态内存区域的某个地址。(当然,内存地址是虚拟地址。该程序假定它拥有自己的整个内存空间(例如从 0x00000000 到 0xFFFFFFFF)。这就是为什么编译器可以做出诸如“好的,数组将位于地址 0x00A33211”之类的假设。在运行时,地址由 MMU 和操作系统转换为实际/硬件地址。)随后,直到程序被装入内存运行时,这里的内存才会被真正分配。所谓的静态分配只是预先计算好的意思。但依旧需要运行时才能将其分配。至于堆对象,更是需要等到运行时调用CRT帮助我们从OS中获取内存。
-
运行时必分配内存
- 运行期分配内存,一开始程序会初始化一些全局对象(给上面的占位符分配内存),然后找到入口函数。之后用
new啊malloc()之类的函数,在堆上分配内存。 - 运行期内存错误,就是运行的时候发生的,比如申请不到内存,内存越界访问,等等。
- 运行期分配内存,一开始程序会初始化一些全局对象(给上面的占位符分配内存),然后找到入口函数。之后用
-
关于数组不能使用非常量做为大小来声明。
int main(){ int a = 10; const int b = 10; int arr[a]; //不行 int arr[b]; //可以 return 0;}- 为啥?**因为尽管我们提到过一些可以在编译时分配内存的对象。但是他们并不能在编译时计算。可以在编译时计算的只有常量表达式。**所以普通全局变量在这里也不能用。
- 常量表达式和
constexpr较为复杂。比如字面值是常量表达式。用常量表达式初始化的const对象也是常量表达式。或使用constexpr指明可以编译时计算。 - 同时,如
const int b = 10;他是局部const所以存储在栈段。但由于他是常量表达式,所以并不为其在栈上分配内存。所有下面用到b的地方都会被直接替换为10[详细说就是放入符号表。然后替换值]。直到有地方对b取地址了,才会在栈上为其分配一块内存。
constexpr和const区别
constexpr不强制编译器进行constexpr优化。或者我们说,不合法的constexpr无法通过编译。
- 相同点:
const和consexpr都是用来定义常量的 - 不同点:
const声明的常量,初始值引用的对象不一定是一个常量;constexpr声明的常量,初始值一定是常量表达式。- 也就是说:
const并未区分出编译期常量和运行期常量。但是constexpr限定了编译期常量。const修饰的对象虽然必须声明时初始化,但是如果这个值是编译时可以确定,则在编译时初始化。如果是运行时才能确定,则在运行时初始化。
- 也就是说,为了解决
const关键字的双重语义问题,保留了const表示“只读”的语义,而将“常量”的语义划分给了新添加的constexpr关键字。即凡是表达“只读”语义的场景都使用const,表达“常量”语义的场景都使用constexpr。
- 也就是说:
所以,从以上信息我们可以再详细说说二者的区别
**声明对象时使用 constexpr 说明符则同时蕴含 const。声明函数或静态成员变量 (C++17 起)时使用 constexpr 说明符则同时蕴含 inline。如果一个函数或函数模板的某个声明拥有 constexpr 说明符,那么它的所有声明都必须含有该说明符。
格外注意!!!在C++11中,声明非静态成员函数为constexpr则也包含const
针对对象:
const将对象声明为常量。这意味着保证一旦初始化,该对象的值就不会改变,并且编译器可以利用这一事实进行优化。它还有助于防止程序员编写修改初始化后不打算修改的对象的代码。‘constexpr意思是该对象适合在标准中称为常量表达式的地方使用。但请注意,constexpr不是唯一实现这个目的的方法。- constexpr 变量必须满足下列要求:
-
它的类型必须是字面类型。
- 比如
const int a = 20。这个没有声明为constexpr也可以,因为它等同于constexpr因为是字面值。
- 比如
-
它必须立即被初始化。
-
它的初始化包括所有隐式转换、构造函数调用等的全表达式必须是常量表达式
- 这句话额外针对的是自定义类型。我们可以针对内置类型使用如这样的方式直接使用constexpr
constexpr int a = 200;但是自定义类型不可以 如
class myclass{public:int a;int b;myclass(int l, int r):a(l),b(r){};};int main(){constexpr sss(2,3); //不可以}- 这句话的意思就是如果有任何隐式转换或函数调用,则这些函数都必须满足常量表达式要求。也就是一个constexpr则全部必须constexpr。只能用constexpr函数去初始化constexpr变量。这种函数足够简单,以使得编译时就可以计算其结果。
- 所以如果想要使用constexpr修饰自定义类型,则构造函数必须也为constexpr函数 如这样:
class myclass{public:int a;int b;constexpr myclass(int l, int r):a(l),b(r){}; //必须也是constexpr};int main(){constexpr myclass obj(2,3); //可以了return 0;} -
constexpr修饰指针有特殊要求。
-
一个constexpr指针的初始值必须是
nullptr或者0,或者是存储在某个固定地址中的对象- 固定地址的意思是必须是全局/静态变量
int s = 100;int main(){int ss = 100;constexpr int* b = &s;// OKconstexpr int* bb = &ss; //不行。这不是固定地址对象。return 0;} -
constexpr只对指针有效,与指针所指的对象无关。
int s = 100;int main(){constexpr int* b = &s;int* const bb = &s; //上面的等于这个。也就是常量指针。int sss = 200;b = &sss;//不允许。return 0;} -
-
针对函数:
-
可以理解为constexpr修饰的其实是函数返回值。所以必须要入参满足constexpr,返回值也要满足constexpr,计算也要满足constexpr
-
const只能用于非静态成员函数,不能用于一般函数。它保证成员函数不会修改任何非静态数据成员(可变数据成员除外,无论如何都可以修改)。杂记2中详细解释过。 -
constexpr可以与成员函数和非成员函数以及构造函数一起使用。 -
constexpr函数必须满足如下要求-
它必须非虚
-
它的函数体不能是函数 try 块
-
对于构造函数,该类必须无虚基类
-
它的返回类型(如果存在)和每个参数都必须是字面值类型
-
C++14前有如下要求:
- 函数体必须被弃置或预置,或只含有下列内容:
- 空语句(仅分号)
static_assert声明- 不定义类或枚举的
typedef声明及别名声明 using声明using指令- 恰好一条
return语句,当函数不是构造函数时。- 注:三目运算符是OK的。
- 函数体必须被弃置或预置,或只含有下列内容:
-
C++14后,20前有如下要求
- 函数体必须不含:
goto语句- 拥有除
case和default之外的带有标签的语句 try块asm声明- 不进行初始化的变量定义
- 非字面类型的变量定义
- 静态或线程存储期变量的定义
- 注意:是
=default;或=delete;的函数体均不含任何上述内容。
- 也就是说14之后可以有
if这样的语句。
- 函数体必须不含:
-
-
constexpr 构造函数
- 函数体不是
=delete;的 constexpr 构造函数必须满足下列额外要求: - 对于类或结构体的构造函数,每个子对象和每个非变体非静态数据成员必须被初始化。
- 如果类是联合体式的类,那么对于它的每个非空匿名联合体成员,必须恰好有一个变体成员被初始化
- 对于非空联合体的构造函数,恰好有一个非静态数据成员被初始化
- 每个被选用于初始化非静态成员和基类的构造函数必须是 constexpr 构造函数。
这一堆的意思是要么构造函数不能含有函数体也就是用初始化列表,要么每一个成员必须有默认值
- 函数体不是
class myclass{ public: int a = 2; //必须有默认值 int b = 3; //必须有默认值 constexpr myclass(int l, int r){ a = l; b = r; };};//要不然就这样,用初始化列表class myclass{ public: int a; int b; constexpr myclass(int l, int r):a(l),b(r){}; //初始化列表};-
constexpr 析构函数
- 析构函数不能是
constexpr的,但能在常量表达式中隐式调用平凡析构函数。
- 析构函数不能是
针对模板
- 但由于模板中类型的不确定性,因此模板函数实例化后的函数是否符合常量表达式函数的要求也是不确定的。
- 针对这种情况下,C++11 标准规定,如果 constexpr 修饰的模板函数实例化结果不满足常量表达式函数的要求,则 constexpr 会被自动忽略,即该函数就等同于一个普通函数。
- 对于 constexpr 函数模板和类模板的 constexpr 函数成员,必须至少有一个特化满足上述要求。其他特化仍被认为是 constexpr 的,尽管常量表达式中不能出现这种函数的调用。
https://stackoverflow.com/questions/14116003/whats-the-difference-between-constexpr-and-const
https://blog.csdn.net/wangmj_hdu/article/details/119516148
https://blog.csdn.net/qq_22660775/article/details/89336997
https://yuhao0102.github.io/2020/09/14/cpp%E4%B8%ADconstexpr%E4%BD%9C%E7%94%A8/
ODR使用
较为复杂。但是简而言之的说:
- 一个对象在它的值被读取(除非它是编译时常量)或写入,或取它的地址,或者被引用绑定时,这个对象被 ODR 使用。
- 使用“所引用的对象在编译期未知”的引用时,这个引用被 ODR 使用。
- 一个函数在被调用或取它的地址时,被 ODR 使用。
如果一个对象、引用或函数被 ODR 使用,那么程序中必须有它的定义;否则通常会有链接时错误。
class myclass { public: static constexpr int s = 10;};const int myclass::s; // 外部定义
int main() { std::cout << myclass::s << std::endl; // 非ODR使用 std::cout << *&myclass::s << std::endl; // ODR使用 取地址然后解引用 必须有定义}static constexpr (C++14/17)
先看代码,还是上面的代码
class myclass { public: static constexpr int s = 10;};
int main() { std::cout << myclass::s << std::endl; // 非ODR使用 std::cout << *&myclass::s << std::endl; // ODR使用 没有类外定义所以有未定义符号错误}如果 const 非 inline (C++17 起)静态数据成员或 constexpr 静态数据成员 (C++11 起)(C++17 前)被 ODR 使用,那么仍然需要命名空间作用域的定义,但它不能有初始化器。
由于constexpr从C++17开始变成了默认inline,所以可以不需要类外再次定义,可以编译通过
为什么inline之后就可以编译通过了?首先,因为类内静态数据成员的声明不是定义!!来自标准文档
所以通常静态数据成员需要类外定义。inline因为定义逐渐从优化变成了允许多次定义,可能导致违反ODR原则。所以C++17的时候,静态成员的类内初始化需要显式的inline。定义是为了给静态数据成员一个内存位置。从 C++17 开始,当你声明一个 inline 变量,包括静态数据成员,它会具有外部链接,但它可以在程序中的任何地方出现多次(正如 inline 函数)。编译器和链接器保证所有的定义都是相同的,并且在整个程序中只存在一个实例。
在技术层面上,当一个变量被声明为 inline 时,它告诉编译器和链接器允许变量在不同的编译单元(源文件)中多次定义,只要所有的定义都是相同的。此后,在链接阶段,不论这个变量在多少个编译单元中有定义,都会被视为同一个变量。这样就确保了即使对于 ODR 使用场景(例如取地址),也不会产生未定义符号错误,因为链接器能够正确地将所有引用解析到单一的定义上。
https://stackoverflow.com/questions/46874055/why-is-inline-required-on-static-inline-variables
友元
之前一直懒得写,这次抽时间整理一下
友元可以是函数,也可以是类。友元核心意义是,我不属于你,但我成为了你。
- 也就是这个类的友元函数或者友元类可以像这个类的成员一样访问这个类的私有属性。
友元函数
- 友元函数是可以直接访问类的私有成员的非成员函数。它是定义在类外的普通函数,它不属于任何类,但需要在类的定义中加以声明,声明时只需在友元的名称前加上关键字
friend - 友元函数必须在类内声明。但是可以在类内或类外定义
- 友元函数和运算符重载参见杂记2
友元类
- 友元类的所有成员函数都是另一个类的友元函数,都可以访问另一个类中的隐藏信息(包括私有成员和保护成员)
class A{ public: friend class B;};- 经过以上说明后,类 B 的所有成员函数都是类 A 的友元函数,能存取类 A 的私有成员和保护成员。
友元声明以关键字 friend 开始,它只能出现在类定义中。因为友元不是授权类的成员,所以它不受其所在类的声明区域 public private 和 protected 的影响。通常我们选择把所有友元声明组织在一起并放在类头之后
友元不是类成员,但是它可以访问类中的私有成员。友元的作用在于提高程序的运行效率,但是,它破坏了类的封装性和隐藏性,使得非成员函数可以访问类的私有成员。不过,类的访问权限确实在某些应用场合显得有些呆板,从而容忍了友元这一特别语法现象
注意要点:
- 友元关系不能被继承。
- 友元关系是单向的,不具有交换性。若类 B 是类 A 的友元,类 A 不一定是类B的友元,要看在类中是否有相应的声明。
- 友元关系不具有传递性。若类 B 是类 A 的友元,类 C 是 B 的友元,类 C 不一定是 类 A 的友元,同样要看类中是否有相应的声明。也就是朋友的朋友也是朋友这句话在友元里不成立。
使用 ifdef 条件编译
- 在编译中使用
-D可以指定宏定义。- 在这里如果使用
g++ 12.15.cpp -DTEST1 -o 12.15则会定义TEST1宏,所以会编译上面的部分。最终输出10。否则会编译下面的部分,输出10.234
- 在这里如果使用
#ifdef TEST1
#define mymacro int
#else #define mymacro double
#endif
int main(){ mymacro a = 10.234; cout << a << endl; return 0;}main函数前后和CRT
-
操作系统创建进程后,把控制权交给程序的入口函数
(gcc –e (_startEntryPoint)), 这个函数往往是运行时库的某个入口函数。glibc的入口函数是_start,msvc(vc6.0)是mainCRTStartup -
入口函数对运行库和程序运行环境进行初始化,包括堆,I/O,线程,全局变量构造(constructor)等。
-
调用MAIN函数,正式开始执行程序主体。
-
执行MAIN完毕,返回入口函数,进行清理工作,包括全局变量析构,堆销毁,关闭I/O等,然后进行系统调用结束进程
-
程序执行前装载器会把用户的参数和环境变量压入栈而不是放入寄存器。接着操作系统把控制权交给入口函数。
-
入口函数
_start中调用了_libc_start_main函数,_libc_start_main函数接受如下(仅列出一部分,更多的可以看高级C/C++编译技术3.4.2)传入参数:_libc_csu_init函数指针,__libc_csu_fini函数指针和rtld_fini函数指针-
下面是
__libc_start_main的部分细节。 -
在
__libc_start_main中,我们会调用我们所谓的主函数main。但是在这之前还有许多工作要做。- 在我们调用
__libc_start_main函数之前,所有的参数如参数,环境变量等(argc,argv,envp)都要被准备好,并且传递给它。这些参数就是我们之前提到的会被压入栈中。 - 具体格式参考 System V ABI 3.4.1
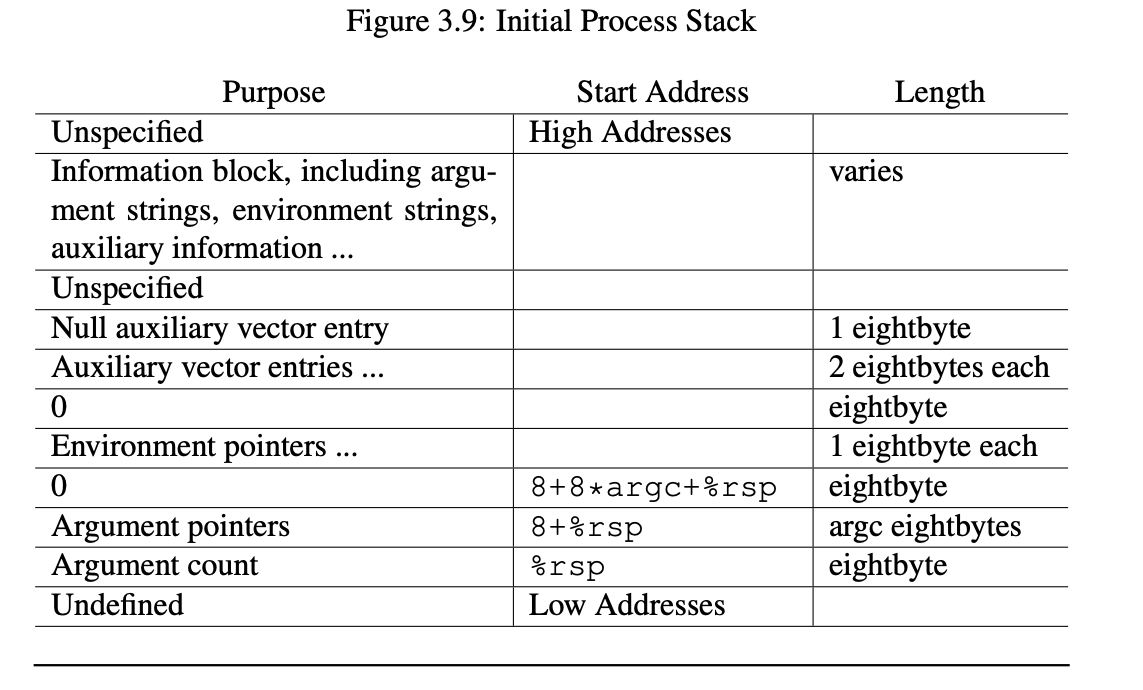
__libc_csu_init函数是在main函数调用前调用的函数,全局和静态对象的构造函数就是在这个过程被执行的- 它会调用下面我们说的
_init()函数
- 它会调用下面我们说的
- 将
__libc_csu_fini通过__cxa_exit()注册到退出链表中 - 调用
main函数 __libc_csu_fini函数是在main调用后调用的函数,全局对象的析构就是在这个过程被执行的。- 它会调用下面我们说的
_finit()函数
- 它会调用下面我们说的
- 在我们调用
-
-
用户的参数:对应
int main(int argc,char *argv[]) -
环境变量:系统公用数据,系统搜索路径等等。
-
-
初始化和OS版本相关的全局变量
-
初始化堆,每个进程都有属于自己的堆。它是一次性从系统中申请一块比较大的虚拟空间(
malloc分配的是虚拟页面,直到写入时才会映射到物理页),以后在进程中由库的堆管理算法来维护这个堆。当堆不够用时再继续申请一块大的虚拟空间继续分配。 可见,并非程序每次malloc都会系统调用(API调用比较耗时,涉及到用户态到内核态的上下文切换),效率比较高。这里契合了我们说的两种内存分配方式(mmap和brk)- 堆相关操作:
HeapCreate:创建一个堆,最终会调用virtualAlloc()系统API函数去创建堆。HeapAlloc:malloc会调用该函数HeapFree:free会调用该函数HeapDestroy:摧毁一个堆
- 堆相关操作:
-
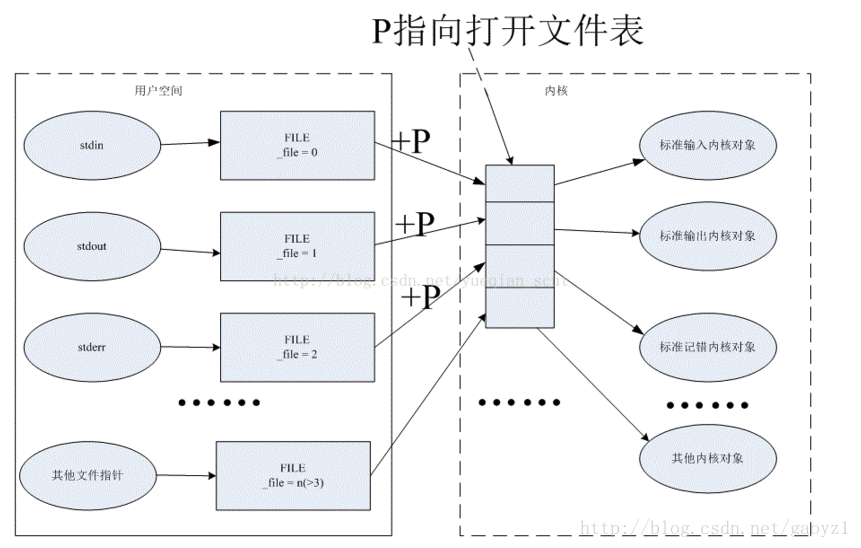
I/O初始化,继承父进程打开文件表。可见,子进程是可以访问父进程打开的文件。如果父进程没有打开标准的输入输出,该进程会初始化标准输入输出。即初始化以下指针变量:
stdin,stdout,stderr.它们都是FILE类型指针。在linux和windows中,打开文件对应于操作一个内核对象,其处于内核态,因此用户态是不能直接操作该内核对象的。用户只能操作与内核对象相关联的FILE结构指针。对应关系是:
-
获取命令行参数和环境变量
-
初始化C库的一些数据
-
全局变量构造,如各个全局 类对象的构造函数调用和标记
__attribute__((constructor))属性的各个函数。它们都应该在进入main前进行调用。需要运行时库和C/C++编译器、链接器的配合才能实现这个功能。- 因为全局变量必须在main函数之前构造、必须在main函数之后析构,所以运行库在每个目标文件中引入了两个初始化相关的段
.init和.finit - 作为扩展,GCC 支持
__attribute__((constructor))可以使任意函数在main. 构造函数可以有一个可选的优先级__attribute__((constructor(N)))。- 从 0 到 100 的优先级保留用于实现(
-Wprio-ctor-dtor违反捕获),例如gcov使用__attribute__((destructor(100))). - 应用程序可以使用 101 到 65535。65535(
.init_array或.ctors,不带后缀)与 C++ 中非局部变量的动态初始化具有相同的优先级。
- 从 0 到 100 的优先级保留用于实现(
- 编译器编译某个
.cpp(翻译单元)时,会将所有的全局对象的构造函数指针作为一个整体放到.init段,把析构函数指针放到.finit段,然后在.ctors段放置.init段的地址(该地址即是该文件的各个构造函数的总入口)。- 最后我们会拥有两个函数
_init()和_finit()。这两个函数会先后于main函数执行 - 运行时库有一个库是
crtbegin.o,它使用-1定义了.ctors/.dtors,ctrend.o使用0定义了.ctors/.dtors。 - 用链接器进行连接:
ld crtbegin.o main.o crtend.o一定要按这种顺序,否则出错。链接后的.ELF文件是将以上各个翻译单元的.init/.finit/.ctors/.dtors等段分别合并。当然.data/.text段也会相应合并。
- 最后我们会拥有两个函数
- 对于每个编译单元(.cpp),GCC编译器会遍历其中所有的全局对象,生成两个特殊的函数,第一个特殊函数的作用就是调用本编译单元的所有全局对象的构造函数来对本编译单元里的所有全局对象进行初始化。第二个特殊函数的作用就是调用本编译单元的所有全局对象的析构函数来对本编译单元里的所有全局对象进行析构。它的调用顺序与调用构造函数的顺序刚好相反
- GCC在目标代码中生成了一个名为
_GLOBAL__I_Hw的函数,由这个函数负责本编译单元所有的全局/静态对象的构造和析构,它的代码可以表示为:
- GCC在目标代码中生成了一个名为
static void GLOBAL__I_Hw(void){Hw::Hw(); // 构造对象atexit(__tcf_1); // 一个神秘的函数叫做__tcf_1被注册到了exit//可能用的不是atexit,是__cxa_exit}-
一旦一个目标文件里有这样的函数,编译器会在这个编译单元产生的目标文件(.o)的
.ctors段里放置一个指针,这个指针指向的便是GLOBAL__I_Hw。 -
全局变量构造时即是遍历
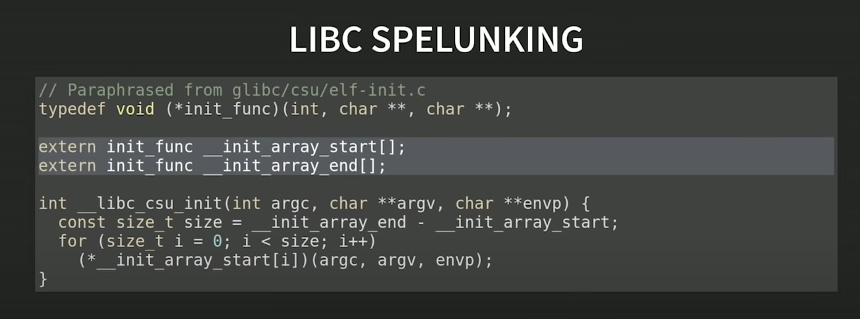
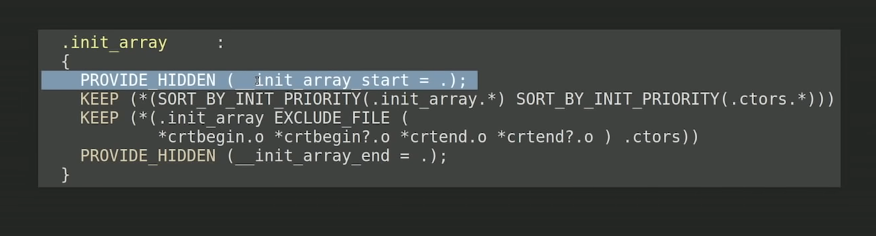
.ctors段的内容,从-1(crtbegin.o)开始,再到-1(crtend.o)结束,中间每四个字节即是各个翻译单元的构造入口函数指针,如果非0,即进行调用。- 在底层,在 ELF 平台上,初始化函数或构造函数以两种方案实现。旧版使用
.init/.ctors而新版使用.init_array.
-
为什么使用
.init_array和.fini_array -
开发人员注意到
.init/.ctors方案存在多个问题: -
碎片
_init化的功能丑陋且容易出错。.ctors里面的-1和0很难看。
-
.init并.ctors使用magic name而不是有意义的名字。 -
所以
.init_array里面就是各个全局对象构造函数的函数指针。等于遍历数组即可而不用遍历段了。
- 在底层,在 ELF 平台上,初始化函数或构造函数以两种方案实现。旧版使用
- 因为全局变量必须在main函数之前构造、必须在main函数之后析构,所以运行库在每个目标文件中引入了两个初始化相关的段
-
注册析构函数
- 为了支持C++类的析构函数,和标记
attribute((deconstructor))属性的各个函数在main之后会被调用,而且是按构造的相反顺序进行调用,同样需要编译器和链接器以及运行时库的支持,原理跟构造相仿。只是为了逆序,使用了atexit()注册各个析构函数(上面提到过),注册时在链表头插入链接,main退出以后也从链表头开始获取链表函数,并进行调用。 - 我们上面提到了编译器生成的特殊函数。这个特殊函数大概这个样子
- 为了支持C++类的析构函数,和标记
static void __tcf_1(void) //这个名字由编译器生成{ Hw.~Hw();}/*这个函数负责析构Hw对象,由于在GLOBAL__I_Hw中我们通过atexit()注册了__tcf_1,而且通过atexit()注册的函数在进程退出时被调用的顺序满足先注册后调用的属性,与构造和析构的顺序完全符合,于是它就很自然被用于析构函数的实现了。*/-
执行函数主体。调用main函数执行,等待返回。在这里可以用到之前已经初始化的各种资源,如I/O, 堆申请释放等等
-
main函数返回后(局部变量在是在return后,exit前析构。因为_libc_start_main内部调用init,然后是main, 然后是exit。所以是main函数返回后,自然main里的局部变量全部出栈。exit函数进入前析构main的局部变量),调用exit函数。大概长这样void exit(int status){while (__exit_funcs != NULL){...__exit_funcs = __exit_funcs->next;}..._exit(status);}-
__exit_funcs是存储由__cxa_atexit和atexit注册的(退出清理)函数的链表,这里的while循环遍历该链表并逐个调用这些注册的函数。可以明显看到,exit函数会在末尾调用_exit,这与OS描述“库函数exit内部调用系统调用_exit退出进程” 一致。而_exit实现由汇编实现,与平台相关。- 重申
__libc_csu_fini在退出链表中。
- 重申
-
释放堆
- 整个程序结束,那么分配给这个进程的所有资源都会被回收。堆空间自然不例外。这里哪管你用不用析构,连房子带地皮都给你扬了。所以不会内存泄漏。这里所谓的不会泄露并不是真的不泄漏,确实泄露了。但是,就算我没有delete,但是程序结束了。对系统无影响。
- 我们所说的内存泄漏是在程序的生命周期中发生的。比如我同样的程序变成了循环一万次,那么每一次new都不回收,这样就是内存泄露了。因为对我们有影响。
-
释放其他资源
-
调用
exit系统API退出进程
-
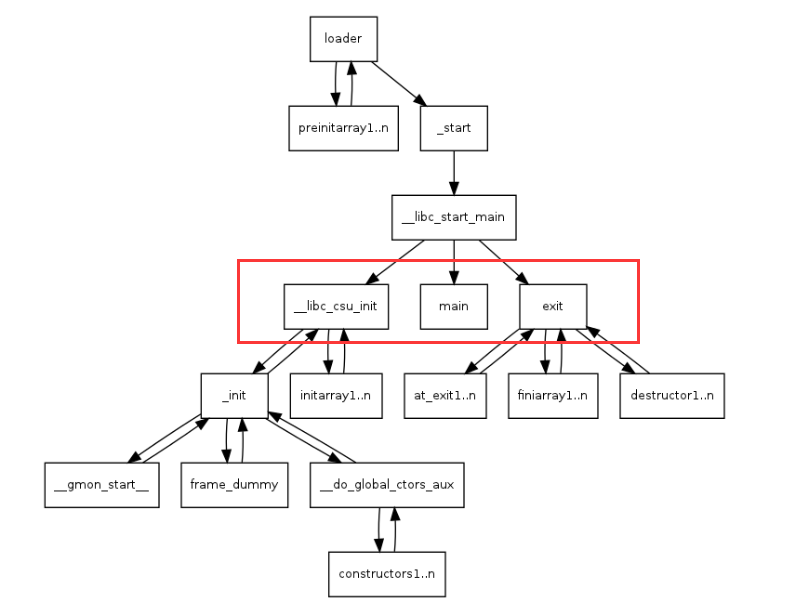
.init/.ctors/.init_array相关可以看这篇文章
atexit函数和__cxa_exit 函数
int atexit (void (*)(void))atexit函数是一个特殊的函数,它是在正常程序退出时调用的函数,我们把他叫为登记函数
- 注意
atexit函数登记的函数必须是无参且无返回值的函数。也就是函数签名必须为void (*)(void)
⼀个进程可以登记多个终止处理函数,这些函数由exit⾃动调用, atexit函数可以登记这些函数。 exit调⽤终⽌处理函数的顺序和atexit登记的顺序相反(网上很多说造成顺序相反的原因是参数压栈造成的,参数的压栈是先进后出,和函数的栈帧相同),如果⼀个函数被多次登记,也会被多次调⽤。
void func1(){ printf("The process is done...\n");}void func2(){ printf("Clean up the processing\n");}void func3(){ printf("Exit sucessful..\n");}int main(){ atexit(func1); atexit(func2); atexit(func3); return 0;}/*Exit sucessful..Clean up the processingThe process is done...*/我们可以明显看到逆序输出。
atexit函数调用时机
以下函数的调用时程序异常或者正常终止:
- 进程终⽌的⽅式有8种,前5种为正常终⽌,后三种为异常终⽌:
- 从
main函数返回; - 调⽤
exit函数; - 调⽤
_exit或_Exit; - 最后⼀个线程从启动例程返回;
- 最后⼀个线程调⽤
pthread_exit; - 调⽤
abort函数; - 接到⼀个信号并终⽌;
- 最后⼀个线程对取消请求做出响应。
atexit函数和__cxa_atexit函数的区别
__cxa_atexit()不限于32个函数。__cxa_atexit()在程序退出前通过dlclose卸载动态库时,将调用动态库的静态析构函数。- 用户不应直接调用
__cxa_atexit()函数 - 当然了,一些标准库如glibc的
atexit直接使用了_cxa_atexit(1)
EXIT和return区别
EXIT
- 是系统层级的系统调用,指的是让进程退出。调用后会开始进行资源的清理和回收。
exit是一个函数
return
return是一个关键字,用于退出这个函数。(结束函数的执行)。也就是堆栈展开并销毁局部变量。
pthread_exit
noreturn void pthread_exit(void *retval);所以使用pthread_exit可以维持子线程不退出的原因是,虽然主进程也是主线程,但是我只让主进程自己的线程退出,也就是不回收进程资源,相当于进程没有结束,子线程依旧可以执行。
-
使用
pthread_exit后,当进程中最后一个线程停止时(或有某个线程执行了exit(), abort()或终止函数时 (来自这里)), 整个进程通过调用exit而退出。所以,所有进程共享的资源会被释放。并且通过atexit注册的函数会被调用。来自这里- 有可能发生多个子线程中,主线程使用了
pthread_exit, 然后其中一个子线程可能在其他子线程结束之前调用了exit(),abort(),或其他终止函数。此时无论其他线程执行完毕与否,都会直接进行进程退出阶段。也就是如上面所说,所有进程共享的资源会被释放。并且通过atexit注册的函数会被调用。
- 有可能发生多个子线程中,主线程使用了
-
注意,
pthread_exit是有参数的。参数是个指针。这个参数的作用是可以把一些参数“塞到”这个指针中。相当于把一个调用pthread_exit函数的线程的返回值通过这个retval传出去。这样这个返回值可以被在同一个进程中的其他调用了pthread_join()的线程所使用。The
pthread_exit()function terminates the calling thread and returns a value viaretvalthat (if the thread is joinable) is available to another thread in the same process thatcallspthread_join(3).
exit与_exit 的区别
-
无论何时执行
return,都会析构局部变量,并弹栈。在main函数中执行return,会析构局部变量、弹栈,然后调用exit(包括了析构全局变量和local static变量的过程)。- 格外注意,
main中执行return会隐式调用exit
- 格外注意,
-
exit是C标准库的函数。_exit是系统调用。 -
调用
exit时会析构全局变量和local static变量(不析构局部变量),刷新IO缓冲区,关闭文件描述符,调用atexit注册的函数(以注册时相反的顺序调用),但不弹栈。最后调用exit函数。 -
直接调用
_exit不会析构任何变量,不会刷新IO缓冲区,不会执行任何通过atexit注册的函数,不弹栈,但会关闭文件描述符。- 因为系统调用非常暴力。直接把整个进程(状态机)直接给扬了
-
exit()和_exit()以及_Exit()函数的本质区别是一个是系统调用,一个是C库函数。也就是是否立即进入内核,_exit()以及_Exit()函数都是在调用后立即进入内核,而不会执行一些清理处理,但是exit()则会执行一些清理处理,这也是为什么会存在atexit()函数的原因,因为exit()函数需要执行清理处理,需要执行一系列的操作,这些终止处理函数实际上就是完成各种所谓的清除操作的实际执行体。 -
_Exit()和_exit()相同。前者来自C99,后者来自POSIX
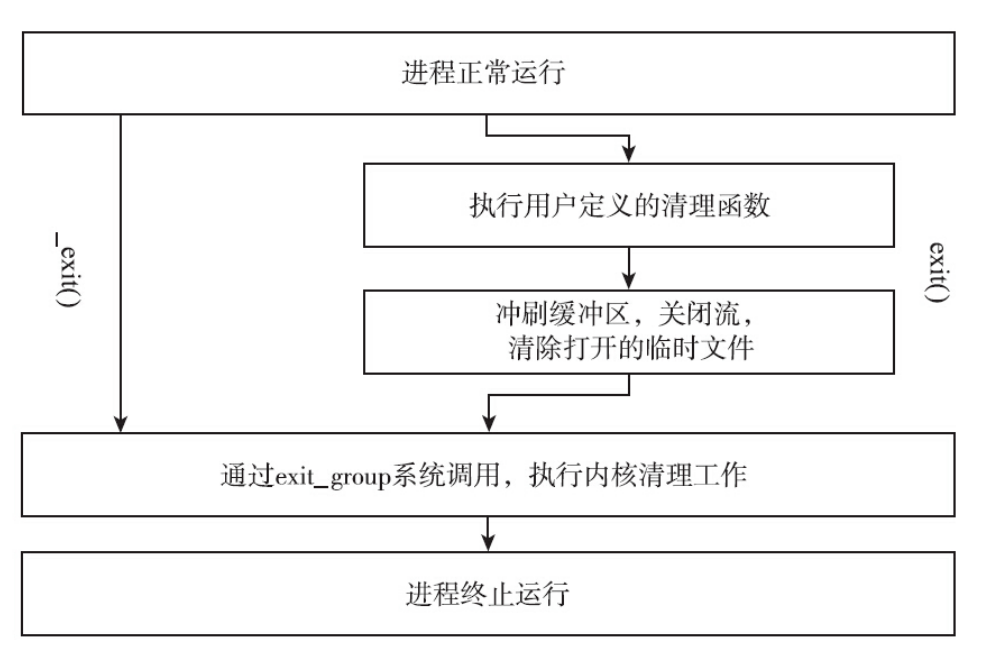
为什么 exit() 函数不是线程安全的?
主要原因 exit语义等同于从main 返回,会涉及到资源释放等相关流程,自然引入竞争问题
避免全局资源释放,使用quick_exit
另外直接列一下各种exit区别 https://learn.microsoft.com/en-us/previous-versions/6wdz5232(v=vs.140)
exit执行完整的 C 库终止过程,终止进程,并向主机环境提供提供的状态代码。_Exit执行最少的 C 库终止过程,终止进程,并向主机环境提供提供的状态代码。_exit执行最少的 C 库终止过程,终止进程,并向主机环境提供提供的状态代码。quick_exit执行快速 C 库终止过程,终止进程,并向主机环境提供提供的状态代码。_cexit执行完整的 C 库终止过程并返回给调用方。不终止进程。_c_exit执行最少的 C 库终止过程并返回给调用方。不终止进程。
例子和梳理
void func(){ cout <<"start" << endl; myobj a(20); //构建新对象 sleep(5); //睡眠5秒 cout << "end" << endl;}void func1(){ printf("atexit registure func\n");}int main(){ atexit(func1); //注册退出时执行函数判断exit是否调用了 cout <<"main start" << endl; thread th1(func); //新线程 th1.detach(); //使用detach sleep(1); cout <<"main end" << endl; pthread_exit(NULL); //强制提前退出 return 0;}- 第一种情况,使用
join的时候,main主线程会等候子线程执行完毕,不多说。 - 第二种情况,使用
detach的时候,main主线程不会等候子线程执行完毕。由于已经分离,主线程无法取得子线程控制权。所以如果main主线程执行完毕,exit会被调用。这时候会强制停止整个进程。所以子线程并不一定能够执行完毕。 - 第三种情况,使用
pthread_exit。使用pthread_exit等于强制停止主线程。main在这种情况下,既是主进程又是主线程。所以使用pthread_exit等于退出了main主线程,但是进程还在,因为main结束后的exit没有被调用。此时由于exit没有被调用,所以会等候子线程执行完毕。使用pthread_exit后,在整个进程退出时,exit还是会被调用。等于此时main的exit被pthread_exit接管。原因在上面
参考资料
https://www.cnblogs.com/matex/articles/10807092.html
https://blog.csdn.net/yueqian_scut/article/details/24384941
https://blog.csdn.net/gaoyz1/article/details/78113069
https://zhuanlan.zhihu.com/p/430683541
https://www.youtube.com/watch?v=dOfucXtyEsU
https://kongkongk.github.io/2020/06/30/construction-and-destruction/
https://blog.csdn.net/qq_38600065/article/details/117370846
https://blog.csdn.net/pwl999/article/details/78219188
https://stackoverflow.com/questions/42912038/what-is-the-difference-between-cxa-atexit-and-atexit
https://blog.csdn.net/u012961585/article/details/103848484
http://originlee.com/2015/03/27/difference-between-return-and-exit-in-cxx/
https://luomuxiaoxiao.com/?p=516
static_assert 静态断言 和 assert 动态断言
static_assert
static_assert静态断言,是C++关键字,作用是让编译器在编译时对常量表达时进行断言。如果通过,就不报错;如果不通过,就报错。
static_assert ( 布尔常量表达式 , 消息 )- 编译器在遇到一个
static_assert语句时,通常立刻将其第一个参数作为常量表达式进行演算,但如果该常量表达式依赖于某些模板参数,则延迟到模板实例化时再进行演算,这就让检查模板参数成为了可能。 - 如果 布尔常量表达式 返回
true,那么该声明没有效果。否则将发布编译时错误,且当存在 消息时诊断消息中会包含其文本。
assert
assert是动态断言,是一个仿函数宏。assert是运行期的判断,并且会强制终止程序,一般要求只能用于debug版本中,是为了尽可能快的发现问题。assert是要从release版本中去掉。所以一般开发会重新定义assert宏。
- 动态断言会降低程序性能。增大运行时花费的空间和时间。
- 由于动态断言是运行期判断,所以如果断言不通过不影响编译。因为编译期不检查动态断言。
#include <assert.h>void assert( int expression );重复包含和前向声明 杂记3也有部分
-
在A.h头文件中包含B.h
-
在A.h头文件A类中声明一个B类的对象,可以是指针,也可以不是指针
-
在B.h头文件中用extern声明类A,然后在类B中声明一个A类的指针对象(必须是指针型)、
- 注意这个应用了前向声明的头文件不需要包含前向声明的类的头文件。
-
在A.cpp和B.cpp中都只需要包含A.h,B.cpp不需要包含B.h
-
然后在A.cpp和B.cpp中分别定义A类的对象和B类的对象。---可选
-
将它们的指针分别传给对方的对象。如果是在不同的文件,也可以是this传值,比如在A.cpp中,给B.cpp中的A类对象传递A的当前对象,b->a=this;然后B类中的a就可以调用A类的成员方法了。----可选
-
最后就可以互相调用彼此的对象了。
-
main里只包含A.h 因为A有完整的B。
- 个人理解,可以在头文件中使用前向声明,然后在源文件中include
//Project.h -----------A.h#include <iostream>#include <string>#include <vector>#include "Employee.h" //包含B.h (第一条)using namespace std;class Project{ public: string name; vector<Employee> peoples; //含有B的对象 (第二条) Project() = default; Project(const string& rhs):name(move(rhs)){}; void SetPeople(const Employee& people); void printPeople();};//Employee.h -------- B.hclass Project; //前置声明A (第三条)这个文件使用了前向声明,前向声明的类的头文件不需要被当前文件包含。class Employee{ public: Project* m_proj; //包含A的指针 (第三条) int ID; Employee() = default; Employee(int val):ID(val){}; void SetProj(Project* proj);
};
//Project.cpp ---------------A.cpp#include "Project.h" //只包含 Project.h (第四条)using namespace std;void Project::SetPeople(const Employee& people){ peoples.emplace_back(people);}void Project::printPeople(){ for(auto& i:peoples){ cout << i.ID << endl; }}
//Employee.cpp ---------------B.cpp#include "Project.h" //Employee.cpp 不包含 Employee.h 只包含 Project.h (第四条)void Employee::SetProj(Project* proj){ m_proj = proj; m_proj->SetPeople(*this);}
//main.cpp
#include "Project.h" //只包含A.h即可(第八条)using namespace std;
int main(){ Project* myproj = new Project("first project"); Employee miku(1); Employee luka(2); miku.SetProj(myproj); luka.SetProj(myproj);
myproj->printPeople();
delete myproj; myproj = nullptr;
return 0;
}std::type_info和type_id操作符
-
关于type_id操作符,如果当应用于多态类型的表达式时,typeid 表达式的求值可能涉及运行时开销(虚表查找),其他情况下 typeid 表达式都在编译时解决。
-
typeid操作符的返回结果是名为type_info的标准库类型的对象的const引用。 -
C++并没有规定typeid实现标准,各个编译器可能实现方式不一样。
-
关于type_info对象,这个类的构造函数是private的,因此用户不能直接构造这样的对象,只能通过typeid()函数来获取这个对象。但是这个类对外提供了name(),operator==()等方法供用户使用
所以这样是不可以的
int a = 20;type_info t1 = typeid(a);//错误const type_info& t1 = typeid(a); //正确有几个规则需要注意一下:
-
如果 类型 是引用类型,那么结果指代的
std::type_info对象表示被引用的类型的无 cv 限定版本 -
如果 类型和 表达式 的类型具有 cv 限定,那么
typeid的结果会指代对应的无 cv 限定类型(即typeid(T) == typeid(const T))。- 如果是指针类型,这里表示忽略顶层CV,只保留底层CV。也就是不看指针本身,而是看指向的数据类型。
-
如果对处于构造和销毁过程中的对象(在构造函数或析构函数之内,包括构造函数的初始化器列表或默认成员初始化器)使用
typeid,那么此typeid指代的std::type_info对象表示正在构造或销毁的类,即便它不是最终派生类。- 很好理解。先构造父类,虚指针指向父类虚函数表,自然RTTI是父类。然后执行用户代码。然后构造子类,这时候虚指针才切换至子类,自然RTTI变为子类。然后执行用户代码。
- 在深入理解对象模型中我们反复强调:虚函数表指针的切换应该是在构造函数后,用户代码前。
先看一下基本类型的例子
int main(){ int a = 20; const int b = 30;
int& c = a; const int& d = a;
int* e = new int(5); int* const f = new int(5); const int* g = new int(6); const int* const h = new int(6);
const type_info& t1 = typeid(a); const type_info& t2 = typeid(b); const type_info& t3 = typeid(c); const type_info& t4 = typeid(d); const type_info& t5 = typeid(e); const type_info& t6 = typeid(f); const type_info& t7 = typeid(g); const type_info& t8 = typeid(h);
cout << t1.name() << endl; //int cout << t2.name() << endl; //int cout << t3.name() << endl; //int cout << t4.name() << endl; //int cout << t5.name() << endl; //int * __ptr64 cout << t6.name() << endl; //int * __ptr64 cout << t7.name() << endl; //int const * __ptr64 cout << t8.name() << endl; //int const * __ptr64 return 0;
}- 我们看到。针对类型本身和引用是忽略CV限定的。
- 针对指针类型,只看其底层类型。也就是指针指向的数据类型。
- 无论指针本身是否是常量,如果指向的数据是常量则带
const。如果指向的数据不是常量则不带const
- 无论指针本身是否是常量,如果指向的数据是常量则带
看一看带多态的例子
class Base {public: Base() {
} virtual ~Base() {
} virtual void func() {
}};
class Derive :public Base {public: Derive() {
} virtual ~Derive() {
} virtual void func() {
}};int main(){ Base b1; Derive d1;
Base* bptr = new Base; Derive* dptr = new Derive;
Base* p = new Derive;
const type_info& t1 = typeid(b1); const type_info& t2 = typeid(d1);
const type_info& t3 = typeid(bptr); const type_info& t4 = typeid(dptr); const type_info& t5 = typeid(p);
const type_info& t6 = typeid(*bptr); const type_info& t7 = typeid(*dptr); const type_info& t8 = typeid(*p);
cout << t1.name() << endl; //class Base cout << t2.name() << endl; //class Derive
cout << t3.name() << endl; //class Base * __ptr64 cout << t4.name() << endl; //class Derive * __ptr64 cout << t5.name() << endl; //class Base * __ptr64 注意这个
cout << t6.name() << endl; //class Base cout << t7.name() << endl; //class Derive cout << t8.name() << endl; //class Derive 注意这个 return 0;}-
首先注意必须有虚函数。虚函数是多态的必不可少的要求之一。也是因为RTTI信息在虚函数表内。
-
我们看到。针对多态的时候的
t3t4t5,类型依旧是对应的指针本身的类型。尤其是t5的类型依旧是父类指针类型。 -
我们如果想看指针真正指向的类型就需要对指针解引用。比如
t6t7t8。我们是对指针进行了解引用。所以这个时候尤其是t8可以看到其指向类型是子类。 -
注意:针对如果输入
typeid的参数多态类型的指针,而且是空指针并进行解引用,则会触发std::bad_typeid