
Effective STL 笔记
第二条:不要试图编写独立于容器类型的代码。
STL 是以泛化原则为基础的:
- 数组被泛化为”以其包含的对象的类型为参数“的容器;
- 函数被泛化为”以其使用的迭代器的类型为参数“的算法;
- 指针被泛化为”以其指向的对象的类型为参数“的迭代器;
- 容器被泛化为”序列式和关联式“容器。
个人理解一句话:别给多个容器写一个通用的函数。没有意义而且效率低下。
第三条:确保容器中的对象副本正确而高效。
- 当(通过如 insert 或 push_back 之类的操作)向容器中加入对象时,存入容器的是你所指定的对象的拷贝。
- 当(通过如front或back之类的操作)从容器中取出一个对象时,你所得到的是容器中所保存的对象的拷贝。
拷贝进来拷贝出去是STL的工作方式
在存在继承关系的情况下,拷贝动作会导致剥离(slicing)。也就是说,如果你创建了一个存放基类对象的容器,却向其中插入派生类的对象,那么在派生类对象(通过基类的拷贝构造函数)被拷贝进容器时,它所特有的部分(即派生类中的信息)将会丢失。”剥离”问题意味着向基类对象的容器中插入派生类对象几乎总是错误的。使拷贝动作高效、正确,并防止剥离问题发生的一个简单办法是使容器包含指针而不是对象。
上一句的例子:
class Base{ //...}class Derived : public Base{ //...};vector<Base> father; //容器类型为父类对象Derived child;father.push_back(child); //子类对象通过基类复制构造函数复制进类型为父类对象的容器时,子类独有的部分会丢失。所以我们为了实现多态,必须是容器保存父类指针。不能是对象也不能是引用。因为指针是一样大的。对象不是一样大的。而且也没有引用容器。而且对象也没法多态。
vector<Base*> father;Derived* child = new child(); //子类指针指向子类对象Base* child = new child(); //父类指针指向子类对象两种都可以。father.push_back(child);第四条:调用empty而不是检查size()是否为0。
个人理解:因为比如链表这种,size()需要线性时间查找一遍之后告诉你size。但是empty是O(1)。所以用empty不要用size更快速。
第五条:区间成员函数优先于与之对应的单元素成员函数。
个人总结:能用区间函数的就不要使用循环一个一个拷贝。增加效率。尤其是序列容器的头插。一个一个插入到头部会造成大量的拷贝和析构。因为每插入一个,后面的元素都要移动一位。
那么,都有哪些区间成员函数?
- 区间创建函数、insert、erase、assign等。
第六条 C++非常煞笔的分析机制
C++非常煞笔的分析机制。函数和函数指针。加括号不加括号
// 注意:围绕参数名的括号(比如对f2中d)与独立的括号的区别:围绕参数名的括号被忽略,而独立的括号则表明参数// 列表的存在:它们说明存在一个函数指针参数int f1(double d); // 声明了一个带double参数并返回int的函数int f2(double(d)); // 同上,d两边的括号被忽略,可以给参数名加上圆括号int f3(double); // 同上,参数名被忽略
int g1(double(*pf)()); // 参数是一个指向不带任何参数的函数的指针,该函数返回double值;g1以指向函数的指针为参数int g2(double pf()); // 同上,pf为隐式指针int g3(double()); // 同上,省去参数名所以
list<int> data(istream_iterator<int>(dataFile), istream_iterator<int>());这一行代码的解释是:这声明了一个函数data,其返回值是list<int>。这个data函数有两个参数:
■ 第一个参数的名称是dataFile。它的类型是istream_iterator<int>。dataFile两边的括号是多余的,会被忽略。
■ 第二个参数没有名称。它的类型是指向不带参数的函数的指针,该函数返回一个istream_iterator<int>。
经典错误
class Widget{ //...假设Widget有默认构造函数}Widget w(); //这是声明了一个名字叫w的函数,该函数没有参数,返回一个Wedget第七条:如果容器中包含了通过new操作创建的指针,切记在容器对象析构前将指针delete掉。
前提是你真的希望容器内指针指向的对象被析构。在构建二叉树的时候我们并不希望容器内指针指向的对象被析构,因为我们会返回一个根节点。如果析构了东西就都没了。
class test;class myfunc{ public: void operator()(vector<int*>& vec, int p){ vec.push_back(new int(p)); //新建一个指向int的指针并放入容器。 }};
struct DEL{ template<typename T> void operator()(T* ptr){ //创建删除函数利用foreach释放tt容器内的每一个指针指向的资源 delete ptr; ptr = nullptr; }};
class test{ public: int val; test(){} test(int x):val(x){}; void getbug(vector<int>& vec){ vector<int*> tt; //函数内创建指针容器 for_each(vec.begin(), vec.end(), bind(myfunc(), ref(tt), placeholders::_1)); //使用foreach和bind。记得传入容器需要加ref for_each(tt.begin(), tt.end(), [](int* content){cout <<*content << endl; }); //使用lambda表达式打印tt容器的每一个值。[]捕获列表没有参数因为我们没有用到上下文变量 for_each(tt.begin(), tt.end(), DEL()); //如果这里不用foreach搭配释放函数释放,那么tt容器在离开函数的时候会被销毁。里面的指针全部都会被移除,但是指向的资源没有释放。导致内存泄漏。因为tt是局部变量。不属于class。 }};
int main(){
vector<int> rrr = {1,2,3,4,5,6,7}; test obj; obj.getbug(rrr);
}这一条的个人解释:容器确实会调用容器内每个元素的析构。但是调用的是对应类型的析构。举个例子vector<int> a; 和 vector<int*> b。a析构的时候调用int的析构,b析构的时候调用int*的析构。但是指针不是类,它没有析构函数,所以什么都没做,仅仅是删掉了指针而没有释放指针所指向的元素。所以容器中所有指针指向的数据全部泄漏。
容器析构的时候会为每个元素调用destroy:
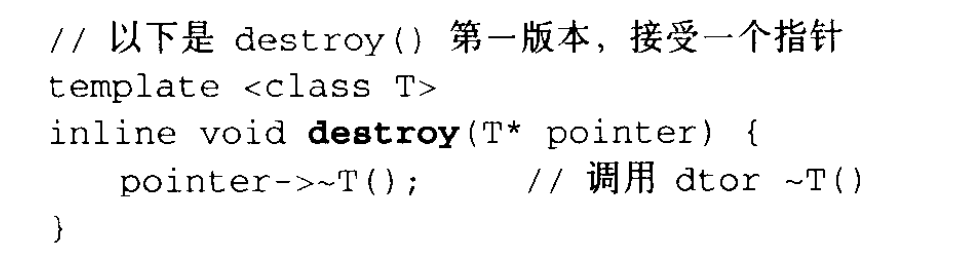
他为每个元素调用其析构函数。这里是因为传入的是迭代器。所以长这样。
所以我们普通的比如myclass可以有~myclass()这样的析构函数调用,但是myclass*这种指针类型是没有析构函数的,没有(其实是这种类型的析构函数是trivial的)~myclass*()。所以要谨记,容器析构的时候并不是delete,而是调用其对应类类型的析构函数!。
一个简单明显的例子
int main(){ vector<int*>myvec; myvec.emplace_back(new int(6)); myvec.emplace_back(new int(7)); delete myvec[0]; //去掉这两行会内存泄漏。 delete myvec[1]; return 0;}所以,当容器储存的是普通对象的时候,并无大碍。但是如果储存的是指针,则必须要手动调用析构函数。
第 八 条:切勿创建包含 auto_ptr 的容器对象
auto_ptr 的容器(简称COAP) 是被禁止的。当你拷贝一个 auto_ptr 时,它所指向的对象的所有权被移交到拷入的 auto_ptr 上,而它自身被置为 NULL。如果你的目标是包含智能指针的容器,这并不意味着你要倒霉,包含智能指针的容器是没有问题的。但 auto_ptr 非智能指针。顺带提一句,auto_ptr在c++11已被摒弃。应使用unique_ptr或shared_ptr做替代。
第 九 条:慎重选择删除元素的方法
-
要删除容器中有特定值的所有对象:
-
如果容器是vector、string或deque,则使用erase-remove习惯用法。
-
v.erase(remove(v.begin(), v.end(), VALUE), c.end);
- 上面这句的要点是。remove仅是移除。他会把把每一个不和指定value相等的元素轮番赋值给first之后的空间。假设现在是112211要移除2,那么remove后应该是长成111111。最后两个数据是脏数据。remove返回的迭代器就指向倒数第二个1,也就是最开始的脏数据。然后erase使用这个迭代器为起点移除所有到结尾位置的数据。因为这一段全都是脏数据。记住,erase后,size改变,capacity不改变。如果需要改变capacity还需要配合swap或匿名对象。
-
-
如果容器是list,则使用list::remove。
-
如果容器是一个标准关联容器,则使用它的erase成员函数。
-
-
要删除容器中满足特定判别式(条件)的所有对象:
- 如果容器是vector、string或deque,则使用erase-remove_if习惯用法。
- 如果容器是list,则使用list::remove_if。
- 如果容器是一个标准关联容器,则使用remove_copy_if和swap,或者写一个循环来遍历容器中的元素,记住当把迭代器传给erase时,要对它进行后缀递增。防止迭代器失效。
-
要在循环内部做某些(除了删除对象之外的)操作:
- 如果容器是一个标准序列容器,则写一个循环来遍历容器中的元素,记住每次调用erase时,要用它的返回值更新迭代器。防止迭代器失效。
- 如果容器是一个标准关联容器,则写一个循环来遍历容器中的元素,记住当把迭代器传给erase时,要对迭代器做后缀递增。防止迭代器失效。
第 十 条:了解分配子(allocator)的约定和限制 — 罄待深入了解
-
你的分配子是一个模板,模板参数T代表你为它分配内存的对象的类型。
-
提供类型定义pointer和reference,但是始终让pointer为T* ,reference为T&。
-
千万别让你的分配子拥有随对象而不同的状态(per-object state)。通常,分配子不应该有非静态的数据成员。
-
记住,传给分配子的allocate成员函数的是那些要求内存的对象的个数,而不是所需的字节数。同时要记住,这些函数返回T* 指针(通过pointer类型定义),即使尚未有T对象被构造出来。
-
一定要提供嵌套的rebind模板,因为标准容器依赖该模板。
-
这里有一点 使用operator new的时候,给的大小是字节数。使用自定义allocator的时候,给的大小是对象的数量。
第 十二 条:切勿对STL容器的线程安全性有不切实际的依赖。
对一个STL实现你最多只能期望:
- 多个线程读是安全的 。多个线程可以同时读同一个容器的内容,并且保证是正确的。自然地,在读的过程中,不能对容器有任何写入操作。
- 多个线程对不同的容器做写入操作是安全的 。多个线程可以同时对不同的容器做写入操作。
实现完全的容器线程安全性时可能采取的方式:
- 对容器成员函数的每次调用,都锁住容器直到调用结束。
- 在容器所返回的每个迭代器的生存期结束前,都锁住容器(比如通过begin或end调用)。
- 对于作用于容器的每个算法,都锁住该容器,直到算法结束。(实际上这样做没有意义。因为,如同在第32条中解释的,算法无法知道它们所操作的容器。尽管如此,在这里我们仍要讨论这一选择。因为即便这是可能的,我们也会发现这种做法仍不能实现线程安全性,这对于我们的讨论是有益的。)
个人理解:加锁就完事了。
下面的例子是一个不加锁也安全的例子。vec虽然是一个容器,但是这个容器里有10个小容器。我开了10个线程给这10个小容器进行多线程同时写入,是安全的。符合要求。也就是所谓的多个线程对不同的容器做写入操作。
void push(vector<int>& vec){ for(int j = 0; j < 100; j++){ vec.push_back(j); }}int main(){ vector<vector<int>> vec(10, vector<int>()); thread th[10]; for(int i = 0; i < 10; i++){ th[i] = thread(push, ref(vec[i])); //注意,这里是核心。我vec虽然是一个容器,但是我这个容器里有10个小容器。我开了10个线程给这10个小容器进行多线程同时写入,是安全的。符合要求 } for(int i = 0; i < 10; i++){ th[i].join(); } for(int i = 0; i < 10; i++){ for(int j = 0; j < vec[i].size(); j++){ cout << vec[i][j]; } cout<<endl; } return 0;
}第十四条:使用reserve来避免不必要的重新分配。
对于 vector 和 string,增长过程是这样来实现的:每当需要更多空间时,就调用与 realloc类似的操作。这一类似于 realloc 的操作分为四部分:
- 分配一块大小为当前容量的某个倍数的新内存。在大多数实现中,vector 和 string 的容量每次以 2 的倍数增长,即,每当容器需要扩张时,它们的容量即加倍。
- 把容器的所有元素从旧的内存拷贝到新的内存中。
- 析构掉旧内存中的对象。
- 释放旧内存。
每当这些步骤发生时,vector或string中所有的指针、迭代器和引用都将变得无效。
通常有两种方式来使用reserve以避免不必要的重新分配。 第一种方式是,若能确切知道或大致预计容器中最终会有多少元素,则此时可以使用reserve。第二种方式是,先预留足够大的空间(根据你的需要而定),然后,当把所有数据都加入以后,再去除多余的容量。
第十七条:使用“swap技巧”除去多余的容量
讲过很多次了。不再赘述了。看下面杂记。
vector<typename>(container).swap(container);vector<int>(c1).swap(c1);表达式vector<typename>(container)创建一个临时的矢量,它是container的副本:这是由vector的复制构造函数来完成的。然而,vector的复制构造函数只为所复制的元素分配所需要的内存,所以这个临时矢量没有多余的容量。然后我们把临时矢量中的数据和container中的数据做swap操作,在这之后,container具有了被去除之后的容量,即原先临时变量的容量,而临时变量的容量则变成了原先container臃肿的容量。到这时(在语句结尾),临时vector被析构,从而释放了先前为container所占据的内存。
swap两个vector可简单理解为交换tag。
int main(){ int a = 5; int b = 10; int c = 15; int*pa = &a; int*pb = &b; int*pc = &c; cout << &a << endl; //0x61fdac cout << &*pa << endl; //0x61fdac cout << &b << endl; //0x61fda8 cout << &*pb << endl; //0x61fda8 vector<int*> va = {pa, pb}; vector<int*> vb = {pb, pc}; cout << &va[0] << endl; //0xde1490 cout << &*va[0] << endl; //0x61fdac cout << &vb[0] << endl; //0xde14d0 cout << &*vb[0] << endl; //0x61fda8 swap(va, vb); cout << &va[0] << endl; //0xde14d0 cout << &*va[0] << endl; //0x61fda8 cout << &vb[0] << endl; //0xde1490 cout << &*vb[0] << endl; //0x61fdac}我们可以看到。VA和VB交换后,VA容器装的指针自己的地址由原来的0x61fdac换成了0xde1490。VB亦然。所以可理解为仅仅是把VA的铭牌摘下来换给了VB,VB换给了VA
第十八条:避免使用vector<bool>
同时参考more effective 条款30。
作为一个STL容器,vector<bool>只有两点不对。首先,它不是一个STL容器。其次,它并不存储bool。除此以外,一切正常。
一个对象并不因为有人说它是一个STL容器,所以它就是了。一个对象要成为STL容器,就必须满足C++标准的第23.1节列出的所有条件。其中的一个条件是,如果c是包含对象T的容器,而且c支持operator[],那么下面的代码必须能够被编译:
T* P = &C[0];换句话说,如果你用operator[]取得了Container<T>中的一个T对象,那么你可以通过取它的地址得到一个指向该对象的指针。(这里假定T没有用非常规的方式对operator&做重载。)所以,如果vector<bool>是一个容器,那么下面这段代码必须可以被编译:
vector<bool>v;bool* pb = &v[0];但是它不能编译。不能编译的原因是,vector<bool>是一个假的容器,它并不真的储存bool,相反,为了节省空间,它储存的是bool的紧凑表示。在一个典型的实现中,储存在vector中的每个bool仅占一个二进制位,一个8位的字节可容纳8个bool。在内部,vector<bool>使用了与位域(bitfield)一样的思想,来表示它所存储的那些bool;实际上它只是假装存储了这些bool。位域与bool相似,它只能表示两个可能的值,但是在bool和看似bool的位域之间有一个很重要的区别:你可以创建一个指向bool的指针,而指向单个位的指针则是不允许的。所以你以为vector存了bool,但其实他储存的不是bool,自然使用[]下标访问返回的也不会是bool*类型的指针,自然无法给bool*类型的变量赋值
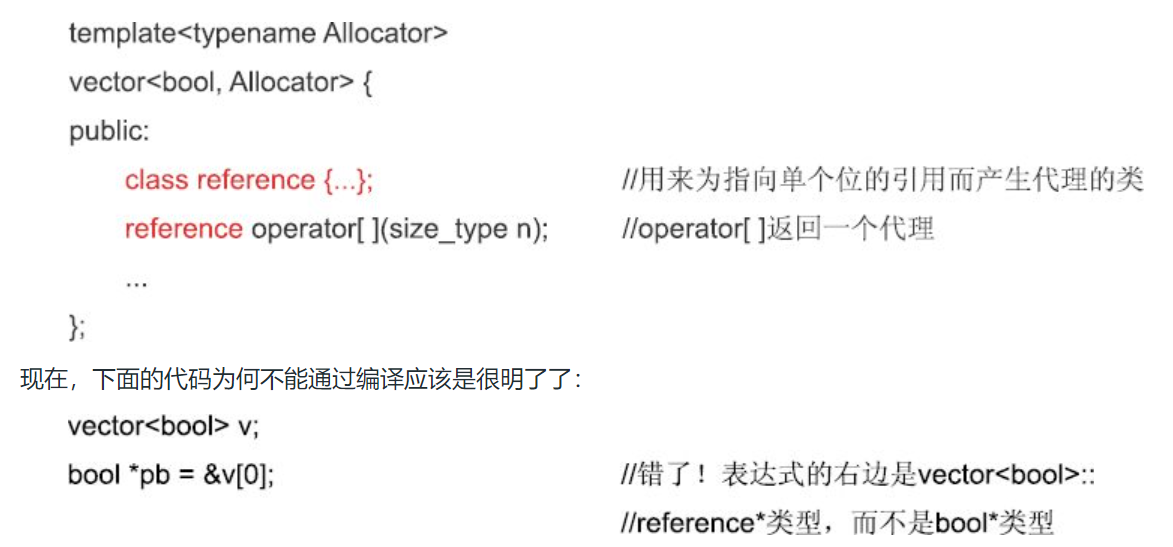
我们在more effective 条款30的笔记中写的例子就和这个差不多,类内套了一个类。同时operator[]返回的是代理类对象。所以现在我们可以很好的理解这个例子了。
当你需要 vector时,标准库提供了两种选择,可以满足绝大多数情况下的需求。
- 第一种是 deque。deque 几乎提供了 vector 所提供的一切(没有reserve和capacity),但deque 是一个 STL 容器,而且它确实存储 bool。当然 deque 中元素的内存不是连续的,所以你不能把 deque 中的数据传递给一个期望 bool 数组的 C API。
- 第二种可以替代 vector 的选择是 bitset。bitset 不是 STL 容器,但它是标准 C++ 库的一部分。与 STL 容器不同的是,它的大小(即元素的个数)在编译时就确定了,所以它不支持插入和删除元素。
细节
我们有如下代码
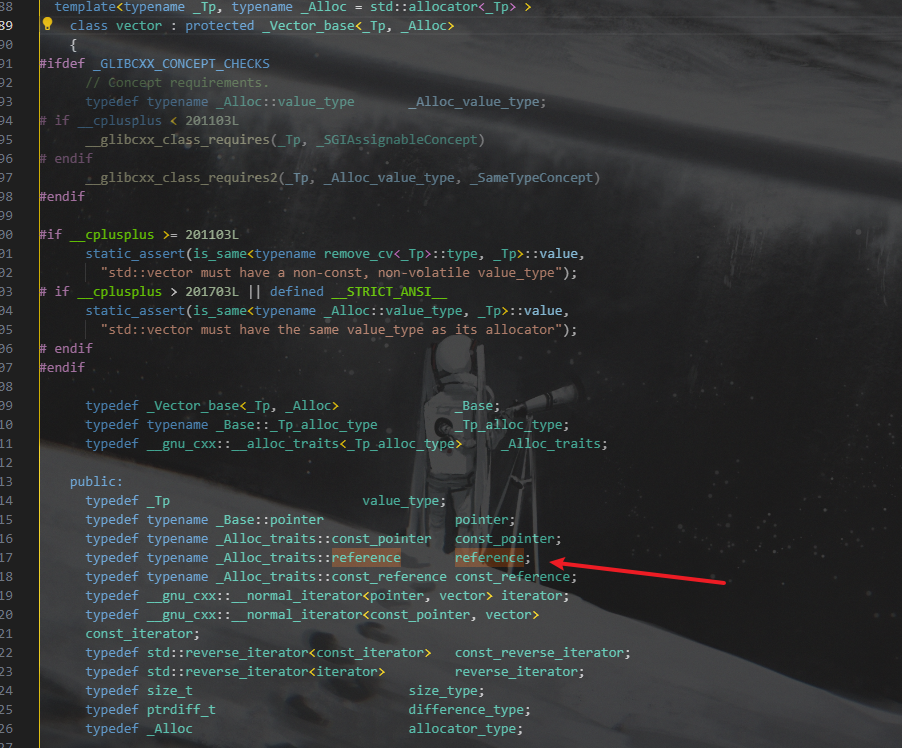
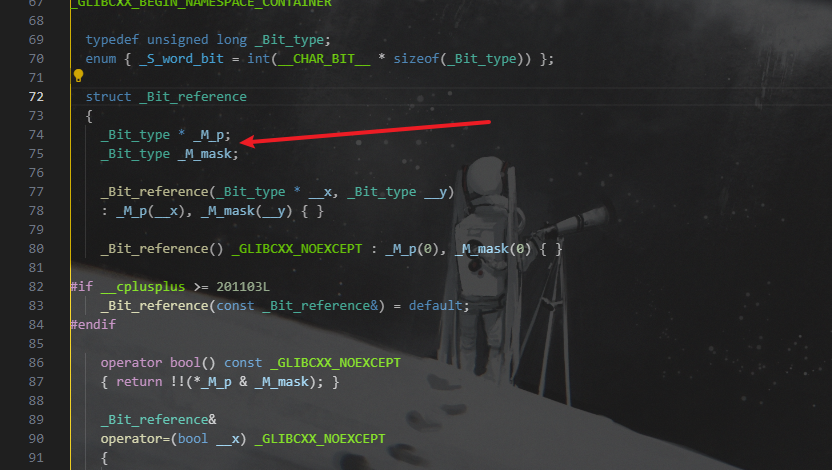
void func1() { std::vector<bool> v; v.push_back(false); std::cout << v[0] << " "; // 0 const auto b = v[0]; auto c = b; c = true; std::cout << c << " " << b << endl; // 1 1 cout << &c << " " << &b << endl; // 0x7ffd1f5c73c0 0x7ffd1f5c73b0 cout << c._M_p << " " << b._M_p << endl; // 0x5578bbd8eeb0 0x5578bbd8eeb0}void func2() { std::vector<int> v; v.push_back(0); std::cout << v[0] << " "; // 0 const auto b = v[0]; auto c = b; c = 1; std::cout << c << " " << b << endl; // 1 0 cout << &c << " " << &b << endl; // 0x7ffdc06bffac 0x7ffdc06bffa8}void func3() { std::vector<int*> v; v.push_back(new int(0)); std::cout << *v[0] << " "; // 0 const auto b = v[0]; auto c = b; *c = 1; std::cout << *c << " " << *b << endl; // 1 1 cout << &c << " " << &b << endl; // 0x7ffdc06bffa8 0x7ffdc06bffa0 cout << c << " " << b << endl; // 0x563d96d19eb0 0x563d96d19eb0 auto del = [](int* p) { delete p; p = nullptr; }; std::for_each(v.begin(), v.end(), del);}int main() { func1(); func2(); func3();}我们发现,func1修改了元素的值。但是理论上不应该被修改,如func2一样。原因就在于b和c的类型并不是bool,而是std::vector<bool>::reference。所以说他的行为和func3相似。我们从其元素地址和元素底层的值地址中就可以看出来。
第十九条:理解相等(equality)和等价(equivalence)的区别。
标准关联容器(如set, map)总是保持排列顺序的,所以每个容器必须有一个比较函数(默认为less)来决定保持怎样的顺序。等价的定义正是通过该比较函数而确定的,因此,标准关联容器的使用者要为所使用的每个容器指定一个比较函数(用来决定如何排序)。如果该关联容器使用相等来决定两个对象是否有相同的值,那么每个关联容器除了用于排序的比较函数外,还需要另一个比较函数来决定两个值是否相等。(默认情况下,该比较函数应该是equal_to,但有趣的是,equal_to从来没有被用作STL的默认比较函数。当STL中需要相等判断时,一般的惯例是直接调用operator==。
个人理解:假如我们让使用set去忽略大小写地插入字符串。则我们会基于set一个仿函数告知他这一点。随后我们插入"abc" 和"ABC"
会发现只有第一个可以插入。是因为在这时候,"abc" 和"ABC"是等价的。但是"abc" 和"ABC"并不相等。等价是我们认为告知的。
第二十条:为包含指针的容器(关联或序列式容器)指定自定义比较器。
如下代码,我们有一个装有指针的容器。如果按照默认排序 当我们使用如下代码
vector<string*> myvec;sort(myvec.begin(), myvec.end());其实会被隐含地推导为如下代码:
sort(myvec.begin(), myvec.end(), less<string*>);是明显错误的。此处会对指针排序。所以必须自定义比较器。如下。顺便练习删除器。
void deleter(string* item){ //自定义删除器。 if (item!=nullptr){ delete item; item = nullptr; }}
class mydeleter{ //自定义删除器。 public: bool operator()(string* item){ if(item != nullptr){ delete item; item = nullptr; } }};class mysort{ public: bool operator()(const string* a, const string* b) const{ if(*a < *b){ return true; } return false; }};
int main(){ vector<string*> myvec; myvec.push_back(new string("bcd")); myvec.push_back(new string("cde")); myvec.push_back(new string("abc"));
sort(myvec.begin(), myvec.end()); //这种排序方式是错误的。这会按照指针的值来排序。错误的。 sort(myvec.begin(), myvec.end(), mysort()); //必须使用自定义比较器。
for_each(myvec.begin(), myvec.end(), mydeleter()); //记住释放指针容器内的指针。上下两种都可以 for_each(myvec.begin(), myvec.end(), deleter); //记住释放指针容器内的指针。
return 0;}- 尤其是关联容器在创建之时就需要提供比较器。而默认创建的指针关联式容器的比较器是对指针排序,这明显不是我们希望的。所以创建指针关联式容器的时候就必须指定好我们的自定义比较器。
- 包含智能指针或迭代器的容器亦如此。
第二十一条:总是让比较函数在等值情况下返回false。
class myfunc{ public: bool operator()(const int&a, const int& b) const{ return a<=b; //注意这里 }};
int main(){ set<int, myfunc> s; s.insert(10); s.insert(10); s.insert(11); for(auto i:s){ cout << i << endl; }}这个set会储存两个10和一个11。这破坏了规则。
因为set会先判断两个参数是否等价。这意味着是根据我们的规则来的
他会这么判断:
!(10 <= 10) && !(10 >= 10);!(true) && !(true);false && false;false;这样他会返回不等价。于是就塞进去了。这不应该。
所以永远记住,在任何情况下都要让自定义比较函数在两个变量相等的情况下返回false。术语叫严格弱序化。
第二十二条:切勿直接修改set或multiset中的键。
- 我们已经知道了无法修改map和multimap的key。是因为保存至红黑树的
pair里面的key是const的。(下面提到了)。 - set不允许更改值是因为迭代器返回的是常量迭代器也就是
const iterator
假设我们现在有个student,里面包含了id和name。我们有个装有它的set。并且使用ID来进行排序。
假设我们想更改名字,可以吗?可以。因为针对set的排序是student的id。也就是说,实际上,student的ID是这个set中元素的键(key), 而其他数据比如name只不过和这个键绑在一起而已。所以没有理由不能更改非key的部分。
但是实际做起来有些麻烦。
class student{ public: student(int x, const string& y):id(x), name(y){}; int id; string name;
void change_name(const string& s){ name = s; }};
class mycomp{ public: bool operator()(const student a, const student b) const{ if(a.id < b.id){ return true; } return false; }};
int main(){
set<student, mycomp> my_set; my_set.insert(student(1,"miku")); my_set.insert(student(2,"luka")); my_set.insert(student(3,"nozomi"));
auto t = my_set.begin(); cout << t->name << endl; //输出miku const_cast<student&>(*t).change_name("changedmiku"); //1 static_cast<student>(*t).change_name("changedmiku"); //2 cout << t->name << endl; //经过1输出changedmiku, 经过2不变,输出miku。
return 0;
}- 这里的1是对的。2是错的。我来解释为什么。
- 首先,我们提到了,
set拿到的迭代器是常量迭代器也就是const iterator。所以我们需要把它的const弄掉才行。- 注意为什么我们使用了
student&做为新的类型?第一是因为const_cast只接受指针或引用类型的转换。不支持转换对象。 - 其次,我们需要作用到原来的对象上。所以必须使用引用的方式。来让这个临时cast出来的对象是一个原对象的引用,这样才能施加操作到原来的对象上。
- 记得我们在杂记2说的,四种cast不改变原对象,会生成一个新的对象。
- 注意为什么我们使用了
- 如果使用2的方式,我们会cast出一个临时的匿名对象出来。然后把
change_name施加到了临时对象上。所以没用。
如果我们想自由,安全的对四种关联容器进行元素修改。应使用如下几步:
- 找到你想修改的容器的元素。如果你不能肯定最好的做法,第45条介绍了如何执行一次恰当的搜索来找到特定的元素。
- 为将要被修改的元素做一份副本。在map或multimap的情况下,请记住,不要把该副本的第一个部分声明为const。毕竟,你想要改变它。
- 修改该副本,使它具有你期望它在容器中的值。
- 把该元素从容器中删除,通常是通过调用erase来进行的(见第9条)。
- 把新的值插入到容器中。如果按照容器的排列顺序,新元素的位置可能与被删除元素的位置相同或紧邻,则使用“提示”(hint)形式的insert,以便把插入的效率从对数时间提高到常数时间。把你从第1步得来的迭代器作为提示信息。
student target(2,"luka"); //目标对象auto t = my_set.find(target); // 1 寻找目标对象if(t != my_set.end()){ //如果找到了 student temp(*t); // 2 获取一个目标副本 temp.change_name("changed_luka"); //3 对副本施加更改操作 t = my_set.erase(t); //4 把容器内的对应源元素删除。注意set的erase会返回一个指向删除的元素后面的第一个元素的迭代器。 my_set.insert(t, temp); //5 在指定位置插入。}第二十三条:考虑使用排序的vector替换关联容器
这个建议的前提是这个容器会有如下三个阶段:
- 创建一个新的数据结构,并插入大量元素,在这个阶段,几乎所有的操作都是插入和删除操作。很少或几乎没有查找操作。
- 查找阶段:查询该数据结构找到特点的信息,在这个阶段,几乎所有的操作都是查找很少或几乎没有删除。
- 重组阶段:改变数据结构的内容。
为什么这样的容器最好使用vector?
- 关联式容器针对保存的每一个对象都需要额外的指针。比如map和set使用红黑树,unordered使用哈希表。都需要额外指针。这也就导致需要更多的内存。
- 关联式容器不保证是否在物理内存中相邻,所以在进行如二分查找时,会遇到更多的缺页错误。
但是这里必须保证vector有序,但是在插入或删除元素的时候,或重新分配内存的时候都会进行移动或拷贝。这开销极大,但是关联容器却没有这个缺点。所以对数据结构的使用方式是:查找操作几乎从不跟插入和删除操作混在一起”时,再考虑使用排序的vector而不是关联容器才是合理的。
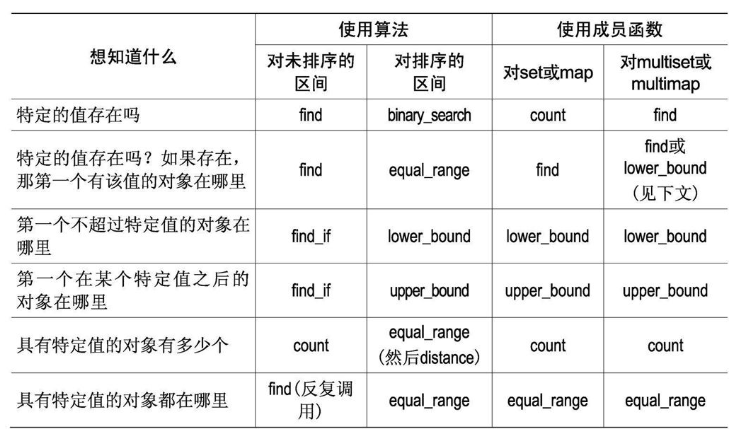
第四十五条:正确区分count、find、binary_search、lower_bound、upper_bound和equal_range。
- 在使用
序列容器和multimap,multiset的时候,find效率比count快。因为count总是会遍历完整个区间 或 检查容器中的每一个对象。而find找到后就可以返回。- 但是在
set和map里面不是问题,因为set不允许重复值,map不允许重复键。所以count总是会返回0或1
- 但是在
杂记
- remove的原理是把每一个不和指定value相等的元素轮番赋值给first之后的空间。 假如我们有{0,1,0,2,0,3,0,4},要移除所有的0, remove后会变成 {1,2,3,4,0,3,0,4} 。你使用auto打印或者是迭代器遍历的话,也会输出{1,2,3,4,0,3,0,4}。所以他什么都不删除。从下标[4]开始后的是脏数据。 所以remove不改变size,也不改变capacity 所以要利用返回的迭代器配合erase使用。

- **可以把capacity理解为STL为整个容器分配的数据存储空间的大小,size理解为尾迭代器和头迭代器的区间距离。**所以erase和remove因为都不改变capacity的大小(new出来的内存没办法动态扩缩容,只能搬移),所以数据不会真正删除,而是覆盖式赋值后,如果size改变,就改变end迭代器位置,如果不改变则不动
- 这就是为什么remove不改变size,因为覆盖式赋值后end迭代器指向位置不变
- 这也是为什么erase改变size,因为覆盖式赋值后end迭代器指向的位置变化了。
- unique也一样,是轮番赋值,不改变size和capacity。
- erase会调用析构移除数据(意味着没有析构就啥也不干)。同时将容器size缩短(更改end迭代器位置),但是依旧不改变capacity。 改变capacity可以在清除完需要的数据后使用swap或者是直接用匿名对象赋值。注意,erase依旧是和remove一样,覆盖式赋值[注意这里只针对序列式容器](把vector中要删除位置后面的所有数据移动到要删除的位置)。但是erase会把后面的脏数据删掉 [注意:用int做实验的时候因为int没有析构函数,所以数据还在那。](但是自定义类型会调用析构函数。注意!调用析构函数不代表数据会被删除或内存被释放!!释放内存依靠的是delete。)。又因为capacity不改变,所以依旧可以强制访问。
- 注意,erase调用的析构函数是自定义对象的析构。自定义对象一般在类成员有指针的时候才会有显式析构。这时候,erase调用析构仅仅是把元素的指针变量指向的数据释放掉,但是元素的指针啊,普通变量啊都还在。这时候如果强制访问了指针,会出现危险访问。这也是为什么析构函数里面,释放掉指针指向的变量后一定要将指针显式置空。
- 这里依旧注意指针容器。指针类型没有我们心中的析构函数。仅仅是指针自己没了而已。资源还在。所以此处有潜在可能导致内存泄漏。
- 这也是为什么没有任何一个函数可以改变容器的capacity。容器的capacity是容器的分配器给容器元素分配的内存,也就是说过的
new了一块区域。这块的大小不能变。所以唯一的办法就是把整个容器析构然后新建。
vector<int>t1 = {1,2,2,3,4,5};t1.erase(t1.begin() + 1); //erase了,数据清除改变size但是不改变capacityt1 = vector<int>(t1); //临时对象释放法vector<int>(t1).swap(t1); //swap释放法。-
clear直接调用的erase
-
reserve是容器预留空间,但并不真正创建元素对象,在创建对象之前,不能访问容器内的元素,因此当加入新的元素时,需要用push_back()/insert()函数。reserve不修改size大小,只修改capacity大小。而且只增不减。reserve强迫容器把它的容量变为至少是n,前提是n不小于当前的大小。这通常会导致重新分配,因为容量需要增加。(如果n比当前的容量小,则vector忽略该调用,什么也不做;而string则可能把自己的容量减为size()和n中的最大值,但是string的大小肯定保持不变。)。记住,在reserve后不可以直接使用下标的方式为其赋值,例如
vector[1] = 4这样的形式,因为reserve不构建元素。没有赋值之前,直接去访问元素会导致访问到未初始化的元素。 -
resize是改变容器的大小,并且创建元素对象,因此,调用这个函数之后,就可以引用容器内的对象了,因此当加入新的元素时,用operator[]操作符,或者用迭代器来引用元素对象。
- resize不改变capacity大小。
- resize的容器,如果n比当前的大小(size)要小,元素并没有被删除。依旧可以被访问到。在调用resize之后,size将返回n。
如果n比当前的大小(size)要小,则容器尾部的元素将会被析构。(这段应该是不同编译器实现不一样)。 - 如果n比当前的**大小(size)**要大,则通过默认构造函数创建的新元素(就是用 你给的用来填充的容器的值 创建的元素)将被添加到容器的末尾。
- 如果n比当前的**容量(capacity)**要大,那么在添加元素之前,将先重新分配内存。
上一条举例:
int main(){ vector<int>a; a.reserve(10); cout << a.size()<<endl; //0 cout << a.capacity()<<endl; //10 for(int i = 0; i < 10; i++){ a.push_back(i); } a.push_back(22); cout << a.size()<<endl; //11 cout << a.capacity()<<endl; //20 cout << &a[0] << endl; //0xd618c0 a.resize(15, 6); //此时resize的大小,大于size,小于capacity,不会发生内存重新分配 cout << a.size()<<endl; //15 cout << a.capacity()<<endl; //20 cout << &a[0] << endl; //0xd618c0 a.resize(25,6); //此时resize的大小,大于capacity,发生内存重新分配 cout << a.size()<<endl; //25 cout << a.capacity()<<endl; //30 cout << &a[0] << endl; //0xd61940}新增例子:
int main(){ vector<int> myvec{0,1,0,2,0,3,0,4}; cout << myvec.size() <<endl; //8 cout << myvec.capacity() <<endl; //8 myvec.resize(2); //resize缩小了 cout << myvec.size() <<endl; //size变为2 cout << myvec.capacity() <<endl; //capacity不变,仍是8 for(auto i:myvec){ cout << i << endl; } for(auto i = myvec.begin(); i != myvec.end(); i++){ cout << *i << endl; } auto i = myvec.begin() + 5; //因为capacity不变,所以依旧可以访问数据,但是因为size改变了,end位置改变了,所以无法通过遍历的方式访问。 cout << *i << endl;
myvec.resize(100); cout << myvec.size() <<endl; //size变为100。因为resize会创建元素 cout << myvec.capacity() <<endl; //capacity变为100。因为扩张了发生了内存重新分配。 return 0;}- capacity是vector和string独有的。它是预分配的内存容量。使用reserve时分配的就是这个。预分配也是分配了。所以也占用空间。
- STL是拷贝进来,拷贝出去的执行方式。即便是形参是引用,也会拷贝实际数据成员至容器。形参是引用只是防止入参时候的拷贝,但是放入容器依旧是拷贝。如果形参不是引用,则会拷贝两次。第一次是入参时,第二次是放入容器时。
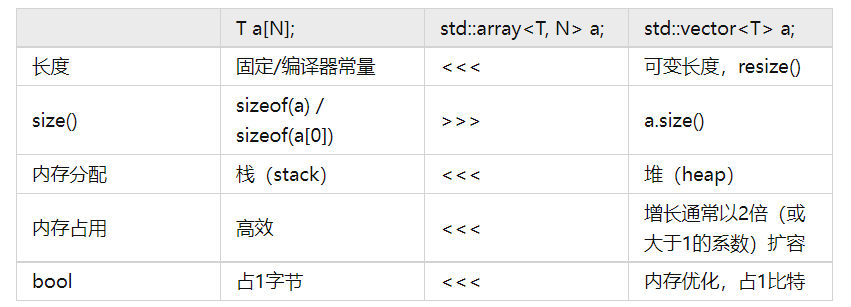
void addval(const myclass& obj){ myvec.push_back(obj); //obj会被拷贝至容器。}- 容器本身在栈上,容器的数据在堆上。也就是
vector<int> a(100, 5);。vector a本身在栈上,但是这100个5在堆上。STL帮我们执行内存分配和释放。a的本身大小只有三根指针。 array是个例外。- 原始数组也就是
T a[]这种静态数组是栈上的 - 原始数组
new出来的在堆上(啥玩意new的都在堆) - STL的array也是在栈上的。并且和原始数组一样是编译时创建。
- 原始数组也就是
- 使用
vector的构造函数初始化vector的时候,是会创建元素的。push_back会直接在尾部添加元素,所以这是reserve存在的意义。
举例:
int main(){ vector<int> myvec(2); myvec.push_back(444); for(auto i:myvec){ cout << i << endl; } return 0;}上面这段代码会输出0 0 444。因为使用了vector的有参构造默认初始化了元素,也就是创建了元素,这样在尾部添加的话自然会添加在后面而不是覆盖。这也是为什么reserve不可以用下标访问(因为只分配储存空间,而不创建元素),而有参构造可以。
vector扩容后调用移动构造的问题
- vector扩容后,如果储存的元素有移动构造且移动构造函数声明为
noexcept,那么就会触发移动构造。- 注意这一条仅适用于扩容的操作。在不是扩容的场景下,非
noexcept也可以触发移动。
- 注意这一条仅适用于扩容的操作。在不是扩容的场景下,非
vector创建时使用构造函数或reserve
- 使用有参构造函数的两种方式都会创建元素。所以
push_back会在创建的元素后添加。
vector<int>v1(5);vector<int>v2(5,0);v1.push_back(100);v2.push_back(100);for(auto i:v1){ cout << i << endl; //输出0 0 0 0 0 100}for(auto i:v2){ cout << i << endl; //输出0 0 0 0 0 100}- 使用无参构造函数不会创建元素。所以必须使用
push_back类函数来进行插入。
vector<int>v3;v3.push_back(100);for(auto i:v3){ cout << i << endl; //只输出100}- 我们提到过,
reserve只预留空间,不创建元素。所以必须使用push_back类函数来进行插入。
vector<int>v4;v4.reserve(5);v4.push_back(100);for(auto i:v4){ cout << i << endl; //只输出100}- 我们提到过,
resize是改变容器的大小,并且创建元素对象,因此,调用这个函数之后,就可以引用容器内的对象了。所以push_back会在创建的元素后添加。
vector<int>v5;v5.resize(5);v5.push_back(100);for(auto i:v5){ cout << i << endl; //输出0 0 0 0 0 100}emplace_back 和 push_back 区别
emplace_back()在容器尾部添加一个元素时,可以直接传入构造函数需要的参数来直接在容器内原地构造。因为emplace_back使用了完美转发。也就时使用emplace_back()可以不显式调用对象的构造函数来避免一次额外的构造。就是把所需参数完美转发至元素类型的构造函数。注意,是储存元素类型的构造函数-
- 具体触发移动构造或拷贝构造的规则
-
emplace_back直接传入默认构造需要的参数时,不论是否有移动构造函数,都是原地构造,只会调用一次对应的构造函数。emplace_back不可以使用参数列表。
-
emplace_back以左值对象的形式传入时,不论是否有移动构造函数,都是只调用一次拷贝构造。 -
emplace_back以显式调用对象构造函数形式传入时(临时对象,右值):- 如果有移动构造,则先调用对应的构造函数构造临时对象,然后因为是临时对象触发移动构造
- 如果没有移动构造,则先调用对应的构造函数构造临时对象然后调用拷贝构造
-
emplace_back以右值对象(例如move(左值对象),或者就是右值)的形式传入时 :- 如果有移动构造则只触发移动构造。
- 如果没有移动构造,则调用拷贝构造
-
- 具体触发移动构造或拷贝构造的规则
class myobj{ public: myobj(int x, int y):vala(x), valb(y){ cout <<"constructor" << endl;}
myobj(const myobj& obj){ this->vala = obj.vala; this->valb = obj.valb; cout <<"copy constructor" << endl; }
myobj(myobj&& obj){ this->vala = obj.vala; this->valb = obj.valb; cout <<"mv constructor" << endl; }
int vala; int valb;};int main(){ vector<myobj> vec; vec.reserve(10);
vec.emplace_back(3,3); //1直接传入默认构造需要的参数时,不论是否有移动构造函数,都是原地构造,只会调用一次默认构造函数 vec.emplace_back({3,3}); //1.1不可以,不能使用参数列表。
myobj mm(1,2); vec.emplace_back(mm); //2 左值对象的形式传入时,不论是否有移动构造函数,因为对象已经存在,所以只调用一次拷贝构造。
vec.emplace_back(myobj(1,2)); //3 显式使用构造函数时,先调用对应的构造函数构造临时对象,然后因为是临时对象触发移动构造 //如果此时没有移动构造,则先调用对应的构造函数构造临时对象然后调用拷贝构造 vec.emplace_back(move(mm)); //4 右值对象传入时(如使用move),如果有移动构造则只触发移动构造。 //如果此时没有移动构造,则调用拷贝构造
vec.push_back(myobj(1,2)); //先调用默认构造,然后因为是临时对象触发移动构造 vec.push_back(1,2); //不可以
}- 使用
push_back,必须先调用对象的默认构造然后根据是临时对象与否(右值或左值)来决定调用拷贝构造还是移动构造。- 具体触发移动构造或拷贝构造的规则:
-
push_back以参数列表的形式传入时- 有移动构造函数,先调用对应的构造函数构造临时对象,再使用移动构造。
- 没有移动构造函数,先调用对应的构造函数构造临时对象,然后使用拷贝构造。
push_back不可以直接传入构造函数所需参数。必须使用参数列表。
-
push_back以左值对象的形式传入时,不论是否有移动构造函数,都是调用一次拷贝构造函数 -
push_back以显式调用对象构造函数形式传入时(临时对象,右值):- 如果有移动构造,则先调用对应的构造函数构造临时对象,然后因为是临时对象触发移动构造
- 如果没有移动构造,则先调用对应的构造函数构造临时对象然后调用拷贝构造
-
push_back以右值对象(例如move(左值对象),或者就是右值)的形式传入时 :- 如果有移动构造则只触发移动构造。
- 如果没有移动构造,则调用拷贝构造
-
- 具体触发移动构造或拷贝构造的规则:
vec.push_back({1,2}); //1使用参数列表的时候,先调用对应的构造函数构造临时对象,如果有移动构造则直接使用移动构造。 //如果没有,先调用对应的构造函数构造临时对象,然后使用拷贝构造。vec.push_back(1,2); //1.1不可以
myobj mm(1,2);vec.push_back(mm); //2以左值对象的形式传入时,不论是否有移动构造函数,都是调用一次拷贝构造函数
vec.push_back(myobj(1,2)); //3显式使用构造函数时,先调用对应的构造函数构造临时对象,然后因为是临时对象触发移动构造 //如果此时没有移动构造,则先调用对应的构造函数构造临时对象然后调用拷贝构造vec.push_back(move(mm)); //4右值对象传入时(如使用move),如果有移动构造则只触发移动构造。 //如果此时没有移动构造,则调用拷贝构造-
使用
emplace_back传入pair的时候不要忘记,emplace_back是原地构造。就是把所需参数完美转发至元素类型的构造函数。所以
vector<pair<string,int>> history;string s = "1b23";history.emplace_back({s,0}); //错误。这时候错误地传入了pair构造完毕的临时对象。history.emplace_back(s,0); //正确,传入构造pair对象所需要的参数。
针对花括号初始化器的问题
- 不推导语境在模板笔记
std::initializer_list的笔记在杂记3
int main() { vector<vector<int>> myvec; myvec.push_back({1, 3}); // OK myvec.emplace_back({1, 3}); //不行.}为什么这个地方用emplace_back不可以? 因为你以为{1,3}是initializer_list, 但是其实它啥都不是. 因为看见这种花括号列表, 想让它变成initializer_list是有条件的. 要么是我们在做函数调用且该函数入参恰好需要个initializer_list, 要么是用auto推导一下.
同时, push_back是函数, 而emplace_back是函数模板. 所以说它需要依照类型推导来合成. 也就是emplace_back接受一个以initializer_list为入参的前提是{1,3}是一个initializer_list. 但是{1,3}变成initializer_list的前提是emplace_back有接受一个initializer_list的版本. 然后就死锁了.
顺带一提, 形参非initializer_list的时候且实参是花括号初始化器列表的时候, 这个是不推导语境.
所以应该怎么办? 有三种办法.
myvec.emplace_back(initializer_list<int>{1, 3}); // 手动构造initializer_listmyvec.emplace_back<initializer_list<int>>({1, 3}); // 显式指明模板参数, 放弃自动推导auto input = {1,3}; // 使用auto推导, 此时auto类型推导为initializer_list<int>myvec.emplace_back(input); // 利用游戏规则总结
所以上面我们发现了,emplace_back 和push_back主要的使用场景区别就在于是否可以被原地构造。也就是可以被原地构造的时候(直接传入对象构造函数所需要的参数的时候)使用emplace_back。其余场合没有区别。另外就是需要注意用花括号初始化器的问题.
一句话:push_back总是先创建对象,然后拷贝/移动到容器。emplace则可以选择直接在容器内构造对象。所以只有当我们想原地构造(直接放入容器 (直接传入构造函数参数,调用构造函数来直接构建对象))的时候选用emplace才是最佳方法。如果是想要移入一个已存在的对象,则没有区别。因为二者遇到右值对象的时候都会调用移动构造。
map的emplace原地构造和forward_as_tuple
先看一段代码
struct myobj{ myobj(int x){ cout << "myobj constructor with arg" << endl; } myobj(int x, int y){ cout << "myobj constructor with arg2" << endl; } myobj(){ cout << "myobj constructor" << endl; } ~myobj(){ cout << "myobj destructor" << endl; } myobj& operator=(const myobj& obj){ cout << "myobj copy assignment" << endl; return *this; } myobj(const myobj& obj){ cout << "myobj copy constructor" << endl; } myobj&& operator=(myobj&& obj){ cout << "myobj move assignment" << endl; return std::move(*this); } myobj(myobj&& obj){ cout << "myobj move constructor" << endl; }};
int main(){ map<int, myobj> mymap; map<int, myobj> mymap1; map<int, myobj> mymap11; map<int, myobj> mymap2{{1, myobj()}}; cout << "-----" << endl; mymap.emplace(1, 2); mymap.emplace(1, 2, 3); // 不可能,别想了 cout << "-----" << endl; mymap11.emplace(1, myobj()); cout << "-----" << endl; mymap1.emplace(std::piecewise_construct, std::forward_as_tuple(1), std::forward_as_tuple()); cout << "-----" << endl; return 0;}/*mymap2:myobj constructormyobj move constructormyobj copy constructormyobj destructormyobj destructor----- mymapmyobj constructor with arg----- mymap11myobj constructormyobj move constructormyobj destructor----- mymap1myobj constructor-----*/我们发现。mymap2构造一次,移动一次,拷贝一次。mymap用了有参构造一次。mymap11 构造一次 移动一次。而mymap1只构造一次
mymap2我们使用了初始化列表。构造是构造原始对象,移动是移动构造到initializer_list, 拷贝是拷贝构造到容器内。
mymap我们使用了有参构造。有参构造的时候emplace就地构造可以把参数转发给对应的构造函数,自然只构造一次。
mymap11我们也使用了emplace就地构造。构造是构造原始对象,移动是emplace移动构造到容器内。我们要理解就地构造,就地构造也是使用了参数就地构造。此时参数是右值的原始对象。所以调用了移动构造。为什么一定要一次拷贝或移动?原因是我们如果想用默认构造,那么就不能有参数。如果不传参数那么emplace怎么办?没办法。所以如果想用无参构造则必须先构造临时对象然后移动进去。
如果是多个参数呢?咋办?同时无参的时候需要拷贝或移动,是不是看起来很烦?下面就是如何解决这个问题。
std::piecewise_construct
std::piecewise_construct_t 是一个空类标签类型,用于区分接受两个元组实参的不同函数。也就是说,这个tag表明后面的两个 tuple 应当被分别传递给 std::pair 的两个成员的构造函数(first 和 second),而不是将整个tuple 作为一个单独的参数传递。
这个东西会匹配到一个pair针对tuple的特化:
template <class _T1, class _T2>template <typename... _Args1, typename... _Args2>_GLIBCXX20_CONSTEXPR inline pair<_T1, _T2>::pair(piecewise_construct_t, tuple<_Args1...> __first, tuple<_Args2...> __second) : pair(__first, __second, typename _Build_index_tuple<sizeof...(_Args1)>::__type(), typename _Build_index_tuple<sizeof...(_Args2)>::__type()) {} // 委托构造给下面的
template <class _T1, class _T2>template <typename... _Args1, size_t... _Indexes1, typename... _Args2, size_t... _Indexes2>_GLIBCXX20_CONSTEXPR inline pair<_T1, _T2>::pair(tuple<_Args1...>& __tuple1, tuple<_Args2...>& __tuple2, _Index_tuple<_Indexes1...>, _Index_tuple<_Indexes2...>) : first(std::forward<_Args1>(std::get<_Indexes1>(__tuple1))...), second(std::forward<_Args2>(std::get<_Indexes2>(__tuple2))...) {}// stl_pair.htemplate <typename... _Args1, typename... _Args2>_GLIBCXX20_CONSTEXPR pair(piecewise_construct_t, tuple<_Args1...>, tuple<_Args2...>);std::forward_as_tuple
这个东西很简单,就是把一对参数包装为一个tuple。该元组在以右值为实参时拥有右值引用数据成员,否则拥有左值引用数据成员。
template< class... Types >tuple<Types&&...> forward_as_tuple( Types&&... args ) noexcept;注意,不可以和make_tuple混用,下面的是绝对错误的
auto tup = forward_as_tuple(1, 2, std::string("abc"));string a = get<2>(tup);cout << a << endl;static_assert(std::is_same_v<decltype(tup), std::tuple<int&&, int&&, string&&>>); // true这个tuple内的所有对象全是临时对象的引用。
总结
所以整体来说,就是我们遇到无参或多参构造的时候,也就是需要把构造函数参数传递给emplace但是受限于语法支持时,我们选择用forward_as_tuple包装一下。第一个参数是tag,第二个参数是key的构造函数参数包装成的tuple,第三个参数是value的构造函数参数包装成的tuple。然后在构造pair的时候把第一个tuple的参数解包转发给key的构造函数,第二个tuple的参数解包转发给value的构造函数。这样一来就可以解决多参或无参的问题,来原地构造。 所有pair的情况,包括其他容器内存pair的情况都可以用这个方法进行原地构造
构造元组的一般性建议
-
要创建返回值元组,尽可能使用构造函数。如果某些参数需要是引用类型,请显式使用
cref/ref -
仅使用
std::tie将一组变量临时表示为元组:
std::tie(it, inserted) = map.insert({x, y}); // tuple unpacking 更多解释查看cppreferencestd::tie(x1, y1, z1) == std::tie(x2, y2, z2); // component-wise comparison- 仅在传递参数时使用
std::forward_as_tuple。不要将其返回值保存在任何地方。
来自本文的Errors in object lifetime: tuples that shoot at your feet章节
小贴士:
使用emplace_back的语法:
vector<vector<int>>temp;temp.emplace_back(vector<int>{...,...});在vector中判断特定元素是否存在的方法:
findfind会在查找到指定值后立即返回,所以它一般比count更快(因为count总是要遍历整个容器)。
find_if- 支持判别式(复杂查找),返回第一个元素的迭代器
count- 查找元素个数
any_of- 和
find_if类似,但是返回bool
- 和
binary_search- 可以先排序再查找。
总结
- 对于已经排序的vector,使用
binary_search - 仅判断是否存在某元素,使用
find - 需要某元素总个数时,使用
count - 支持复杂条件的查找时,使用
any_of(仅知道是否存在)/find_if(返回了第一个元素的迭代器)
使用哈希表的容器,增删改查都是O(1)。使用红黑树的容器,增删改查都是O(nlogn)
-
map,set,multimap,multiset上述四种容器采用红黑树实现,红黑树是平衡二叉树的一种。不同操作的时间复杂度近似为:- 插入:
O(logN) - 查看:
O(logN) - 删除:
O(logN)
- 插入:
-
unordered_map,unordered_set,unordered_multimap,unordered_multiset上述四种容器采用哈希表实现,不同操作的时间复杂度为:- 插入:
O(1),最坏情况O(N)。 - 查看:
O(1),最坏情况O(N)。 - 删除:
O(1),最坏情况O(N)。
- 插入:
map和unordered map区别
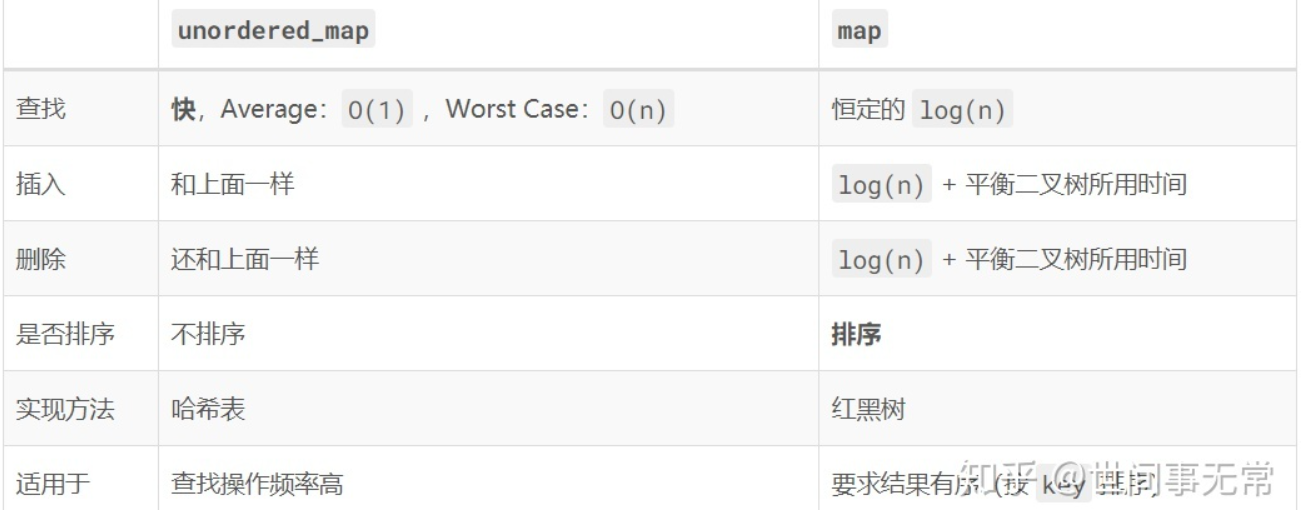
右下角那句话:要求结果有序(按key排序)
关键点:
指针容器的复制是浅拷贝。不能正确复制指针指向的内容。
举例:
vector<int*> v1 = ...;vector<int*> v2 = v1;此时不会调用拷贝构造。因为和析构一样,容器调用的拷贝构造或拷贝赋值是帮助你调用。意思就是他会帮助你调用容器内储存的类型的对应的拷贝构造或拷贝赋值。所以说深拷贝浅拷贝完全依赖于你的拷贝构造和拷贝赋值的实现方式。
这也是为什么指针容器无法深拷贝。因为指针容器储存的是指针,任何类型的指针的类型都是指针。指针类型的拷贝构造和拷贝赋值都是浅拷贝,所以他无法调用到int类型的拷贝构造,只会调用指针类型的拷贝构造。
因为此时假设
v1[0] = 0x100;*v1[0] = 0x999;//我们复制v2[0] = 0x200;*v2[0] = 0x999;vector可以复制每一个元素。就好比int x = y一样。但是这个元素如果是指针的话,他不会进行深拷贝。
指针给指针赋值仅仅是将一个指针指向的地址,复制给了另一个指针,导致两个指针指向一个地址。但是并没有生成新的对象。因为对象和对象指针不一样。
指向对象的指针本质是指针。遵循指针的一般规则。
指针容器的double-free
上面我们提到了,指针容器的互相拷贝是浅拷贝。我们也知道了指针容器必须手动释放容器内每一个指针指向的对象。(第七条)那么有一个问题,我们知道容器是值语义。容器会在传入元素的时候拷贝一份放入容器内。从里面取出的时候又会拷贝一份出来。这导致了一个非常严重的问题,尤其是针对指针容器而言。
举个例子:
vector<int*>vec1;int* b = new int(5);vec1.push_back(b);delete b;delete vec1[0];我们这个指针b在放入容器的一瞬间,会被拷贝一份。所以此时有两个指针指向了new的部分。一个在容器外,一个在容器内。所以假设我们释放了b指向的资源,则此时容器内的这个指针指向的资源也会被释放。如果我们此时害怕没有正确释放,再次释放了容器内指针指向的对象,会有double free错误。因为此时资源已经被释放。
所以指针容器一定要慎重!既要防止没有释放,也要防止重复释放,因为容器是值语义!
- 再次重申,指针容器内的元素(指针)被移除或容器被析构的时候不会调用指向元素的析构函数。也就是实际对象不会被销毁。因为容器**只是调用指针自己的析构函数而不是指针指向对象的析构函数。**然而指针类型的析构函数什么也不做。
迭代器失效
我总是把迭代器失效理解成错误的含义。我们简单讲一下真正的含义是什么。
迭代器失效,不仅仅意味着报错,也意味着你会拿到不是你想要的数据。
- 报错一般指的是由于插入元素,导致容器扩容而致使容器迁移导致指向原空间的迭代器失效。
- 拿不到想要的数据一般指的是由于删除元素,导致元素移位致使迭代器不再指向期望的元素。
vector<int> a = {1,2,3,4,5,6,7,8,9,10};auto it = a.end();cout << *(it-1) << endl; //输出10cout << a.size()<<endl; //输出10cout << a.capacity()<<endl; //输出10a.insert(a.begin() + 3, 3333); //插入后扩容,数据转移至新区域,原来区域被释放cout << *(it-1) << endl; //输出无效数据,迭代器失效。首先,我们要知道。begin() 和end()每次都会动态的返回对应的迭代器,所以这俩不会失效。
啥时候会失效呢?当有一个额外的手动赋值的迭代器出现的时候
这句话是啥意思呢
比如:
for(iter = a.begin();;) 这里你声明了一个新的iter来接收这个调用begin()返回的迭代器。这就是另一个迭代器
或者如上图的:auto it = a.end()。这里也是新的。
所以为什么在for循环里对迭代器操作的时候会失效。因为你操作的迭代器不是动态获取的,而是你已经获取到之后对迭代器进行加减操作的。
另外一个简单例子
vector<int> a;a.reserve(20);for(int i = 0 ;i < 10; i++){ a.push_back(i);}//这时候a是{0,1,2,3,4,5,6,7,8,9}auto it = a.end();cout << *(it-1) << endl; //输出9a.insert(a.begin() + 3, 3333);//这时候a是{0,1,2,3333,3,4,5,6,7,8,9}cout << *(it-1) << endl; //输出8。因为迭代器已经被赋值。对迭代器的加减操作我们可以理解为原始数组对指针的加减操作。所以原来的时候,最后一位指向的内存地址存的是9,我们可以理解为end-1是begin+9。我们执行insert之后,由于迭代器没有重新赋值,所以begin+9指向的内存地址不变。但是insert会让插入位置后的元素后移,8会被移到原来9的内存地址上。这样就是迭代器失效。
下面我们看看下标访问的情况
int main() { vector<int> myvec{ 0,1,2,3,4,5,6 }; for (int i = 0; i < myvec.size(); i++) { if (myvec[i] == 3) { myvec.erase(myvec.begin() + i); } cout << myvec[i] << endl; //注意在erase后面 } cout<<*(myvec.end()) << endl; //这里是能看到最后一个6的。//输出0 1 2 4 5 6
}这里看上去好像皆大欢喜,但是我们要摸清楚一下原理
这里是先把3删掉。erase是覆盖式赋值,把后面元素从删除的元素开始赋值。所以这时候变成了0 1 2 4 5 6 6(虽然最后一个6不可见,但依旧可强制访问)。
所以这时候index依旧为3,但是此时index = 3的值变成了4,又因为erase会改变size(也就是改变end迭代器的位置)所以会正常输入0 1 2 4 5 6
但是一旦我们把打印放在erase前面,那就出问题了。会输出0 1 2 3 5 6
为什么呢?显而易见,打印3的原因是3此时还没有删除,但是4怎么没了呢?
因为我们删掉3之后,是 0 1 2 4 5 6。但是这时候下标已经从3移动到了4。所以打印下标为4的元素自然是5。
再次强调序列式容器的erase是覆盖式删除
erase是覆盖式删除,也就是把要删除数据位置后面的数据依次拷贝至要删除的数据位置和后面的位置上,并且调用脏数据的析构,但是调用析构函数不代表数据会被真正意义上的删除或内存释放。比如指针容器。指针容器只会调用指针类型自己的析构而不会调用指针指向对象的析构。内存释放依靠的是delete。
erase调整的是size,就是调整end迭代器位置。
class myclass{ public: int val; myclass(int x):val(x){}; ~myclass(){ val = 8964; }};int main() { vector<myclass> myvec{0,1,2,3,4,5,6}; myvec.erase(myvec.begin()); myvec.erase(myvec.begin()); myvec.erase(myvec.begin()); myvec.erase(myvec.begin()); for(auto i:myvec){ cout << i.val << endl; //输出4 5 6 } cout << (*myvec.end()).val << endl; //输出8964 cout << (*(myvec.end()+1)).val << endl; //输出8964 cout << (*(myvec.end()+2)).val << endl; //输出8964 cout << (*(myvec.end()+3)).val << endl; //输出8964 cout << (*(myvec.end()+4)).val << endl; //已经越界。所以是非法数据。 return 0;
}我们分析一下过程
0 1 2 3 4 5 6 覆盖式删除1 2 3 4 5 6 6 删除后,调用最末尾元素的析构。注意我们的析构,只是进行一个值的覆盖。因为是栈对象,又没有delete所以依旧能访问到元素1 2 3 4 5 6 8964 调用析构后。以上这一部分是调用了一次erase的情况。如果我们扩展下就是
1 2 3 4 5 6 89642 3 4 5 6 8964 89643 4 5 6 8964 8964 89644 5 6 8964 8964 8964 8964 ↑end 在这这个期望很符合我们上面代码的注释部分。
看一下vector在erase的情况下的迭代器失效到底是什么意思
先看代码,这是for循环删除的代码。
class myclass{ public: int val; myclass(int x):val(x){}; ~myclass(){ val = 8964; }};int main() { vector<myclass> myvec{ 0,1,2,3,4,5,6 }; //for(auto iter = myvec.begin(); iter != myvec.end(); iter++){ //注意这一行 for(auto iter = myvec.begin(); iter < myvec.end(); iter++){ myvec.erase(iter); } for(auto i:myvec){ cout << i.val << endl; //输出 1 3 5 } return 0;
}注意!随机访问迭代器支持>和<比较!!
过程:
0 1 2 3 4 5 6 开始↑iter1 2 3 4 5 6 8964 删除后↑iter
1 2 3 4 5 6 8964 第二次for循环,iter++ ↑iter1 3 4 5 6 8964 8964 删除后 ↑iter
1 3 4 5 6 8964 8964 第三次for循环,iter++ ↑iter1 3 5 6 8964 8964 8964 删除后
1 3 5 6 8964 8964 第三次for循环,iter++ ↑iter1 3 5 8964 8964 8964 8964 删除后 ↑end我们已经通过上面的删除样例了解了,删除后数据会被覆盖过来,然后再进行iter++就会跨越一个数据。就会出现迭代器失效。
假如我们用的不是大小比较,用的是end比较,那么会出现大问题。for循环一直到天荒地老合法内存的尽头。
因为我们在最后一次删除的时候,由于是先删除的,所以end会往前缩一格,会缩到第四位也就是当前iter的位置。然后iter++移动到第五位。这时候进入for循环判断++后的iter,这时候发现 iter在第五位,end在第四位,当然不相等。于是就会一直走下去。
各种容器迭代器失效场景
vector
- 重新分配内存时(超出capacity大小时),所有都失效。
- 在当前指向元素之前进行插入操作,当前迭代器以后的迭代器都会失效。
- 在删除元素时,指向被删除元素以后的迭代器都失效
deque
- 插入元素使deque的所有迭代器失效。(因为可能中控器个数不够,需要开辟更大空间容纳中控器)
- 在deque的中间删除元素将使所有迭代器失效。(涉及到缩减缓冲区数量)
- 在deque的头或尾删除元素时,只有指向该元素的迭代器失效。
queue, stack, priority_queue 这三个容器适配器没有迭代器
list, map, set,unordered_map, unordered_set
- 增加任何元素都不会使迭代器失效。
- 删除元素时,除了指向当前被删除元素的迭代器失效外,其它迭代器都不会失效。
- **格外注意在关联式容器中当进行
my_set.erase(iter)后,iter已经失效。任何针对iter的操作如自增或自减操作都是失效的。所以要么使用erase函数返回的新迭代器,要么使用my_set.erase(iter++)**具体解析在下面。 - 针对哈希容器如unordered系列:
- 若插入引起rehash,则所有迭代器失效。若不rehash,依然有效。
迭代器失效的自增操作
student target(2,"luka");auto t = my_set.find(target);if(t != my_set.end()){ student temp(*t); temp.change_name("changed_luka"); my_set.erase(t++); //注意这里 my_set.insert(t, temp);}**格外注意在关联式容器中当进行my_set.erase(iter)后,iter已经失效。任何针对iter的操作如自增或自减操作都是失效的。**所以我们要么使用erase函数传回的新迭代器,要么使用my_set.erase(iter++)
注意这里发生了几个步骤。首先,t++会被先运算。然后我们知道t++是先赋值后自增。所以此时传入erase的迭代器指向的是我们要删除的那一个。也就是t。但是erase会在t完成自增后再进行删除操作。也就是:
- 先把
t传入erase - 执行
t++ - 因为上面两步合起来才是
t++的运算(参考杂记2)。所以在这之后才开始进行删除操作,处理传入的迭代器。也就是erase原来的t
操作等同于
student target(2,"luka");auto t = my_set.find(target);if(t != my_set.end()){ student temp(*t); temp.change_name("changed_luka"); auto t2 = t; //拿到一个新的迭代器 t2++; //新的迭代器自增,注意不可t++或者++t。这都是对t操作,我们要对t2操作 my_set.erase(t); //删掉t指向的内容 t = t2; //把t2赋值回t。 my_set.insert(t, temp);}https://stackoverflow.com/questions/41959511/erase-set-iterator-value-and-increment-iterator
- 或者使用
erase返回的新迭代器
student target(2,"luka");auto t = my_set.find(target);if(t != my_set.end()){ student temp(*t); temp.change_name("changed_luka"); t = my_set.erase(t); //注意这里 my_set.insert(t, temp);}