
inline 额外的区别
inline只意味着在程序中函数的定义可以出现很多次。
直接转载至此处
作者:吼姆桑 链接:https://www.zhihu.com/question/24185638/answer/2404153835 来源:知乎
前言
我曾在很长一段时间对inline关键字的认识都维持在相当朴素的程度:用来建议编译器将函数内联展开至调用处。这种理解在早期的C++标准(C++98之前)里问题不大,但在C++98标准以后就完全不对了。首先,现代的编译器在决定是否将函数调用进行内联展开时,几乎不参考函数声明中inline修饰符;其次,inline关键字不仅能修饰函数,也可修饰变量(C++17以后),甚至能修饰命名空间(C++11以后);此外,inline更为关键的作用是允许同一个函数或变量的定义出现在多个编译单元之中;最后,修饰命名空间的inline关键字为程序库的版本控制提供了语言层面上的支持,这与最初的函数内联的含义更是相去甚远。
inline函数
- **我们知道,若一个非static函数在多个编译单元中被重复定义,那么在链接阶段会发生multiple definition的错误,这是因为面对同一符号的多个定义,链接器并不知道使用哪个。但是对于header-only的程序库来说,所有的函数定义都位于头文件,若不加特殊处理被多个源文件包含,则一定会发生multiple definition的错误。解决这个问题的方法是在函数声明处加上inline修饰,这样的话编译器在处理该函数时就会认为它是一个弱符号,链接器在面对多个名字相同的弱符号时只会保留其中一个的定义(具体的保留规则视编译器而定)。**我用一个例子来说明inline函数的编译行为:inline函数
foo定义在头文件foo.h中,且函数内部定义了局部静态变量factor;源文件bar1.cc和bar2.cc分别包含了foo.h,并在bar1和bar2函数中都调用了foo函数;最后,源文件main.cc中的main函数调用了bar1和bar2函数:
inline int foo(int x) { static int factor = 1; return x * (factor++);}
/* bar1.cc */#include "foo.h"int bar1() { return foo(1);}
/* bar2.cc */#include "foo.h"int bar2() { return foo(2);}
/* main.cc */int Bar1(), Bar2();int main() { return Bar1() + Bar2();}用gcc编译这三个源文件并链接生成可执行文件main,链接过程中并不会发生multiple definition的错误,并且main函数的返回值表明两次调用使用了同一个局部静态变量factor。
g++ -c main.cc bar1.cc bar2.cc -fno-gnu-unique # okg++ -o main main.o bar1.o bar2.o # ok./main; echo $? # 5readelf -s main最后我们用readelf查看输出的可执行main文件的符号表,可以发现main中确实只有一份符号Foo的定义,同时Foo中的静态变量factor也同样只保留了一份。此时函数Foo和内部定义的局部静态变量factor都是weak符号。
Num: Value Size Type Bind Vis Ndx Name...49: 0000000000004010 4 OBJECT WEAK DEFAULT 23 _ZZ3FooiE6factor...53: 000000000000115f 32 FUNC WEAK DEFAULT 14 _Z3Fooi...当然,没有规定强制多个编译单元中的同名inline函数的定义必须一致,链接器并不会对这种定义不一致的行为报错,但你却无法保证生成的可执行文件中调用了哪个版本。
inline int Foo(int x) { static int factor = 1; return x * (factor++);}int Bar1() { return Foo(1);}
/* bar2.cc */inline int Foo(int x) { static int factor = 2; return x * (factor++);}int Bar2() { return Foo(2);}
/* main.cc */int Bar1(), Bar2();int main() { return Bar1() + Bar2();}对于上述例子,9.3.0版本的gcc面对这种情况很可能是根据源文件的编译顺序而决定使用哪个Foo:
g++ -o main main.cc bar1.cc bar2.cc -fno-gnu-unique # ok./main; echo $? # 5g++ -o main main.cc bar2.cc bar1.cc -fno-gnu-unique # ok./main; echo $? # 8所以面对这种其它编译单元可能定义了同名inline函数的情况,不要轻易定义该名字的inline函数,因为你既无法保证对方的定义与你相同,也无法保证链接器最终选择的定义。如果非要定义,应该将其声明为static或者将其声明定义在另一个不冲突的命名空间中。当然,不使用任何关键字修饰该函数也不行,因为这时你定义的版本对应的符号是全局的强符号,链接器在面对多个弱符号和一个强符号时一定会采用强符号对应的定义,因此你定义的版本会覆盖其它单元所定义的inline版本。除非你知道这样的后果是你所需的(确实我们有时候会这么做,例如覆盖掉程序库提供的默认版本),否则不要这样做。
inline变量
inline用于修饰变量定义是在C++17之后的事情。当inline用于修饰变量定义时,你很难说它具有内联展开的作用,因为将变量的定义内联展开到引用处没有意义,它更多地只是允许在多个编译单元对同一个变量进行定义,并且在链接时只保留其中的一份作为该符号的定义。当然,同时在多个源文件中定义同一个inline变量必须保证它们的定义都相同,否则和inline函数一样,你没办法保证链接器最终采用的是哪个定义。inline变量除了允许我们在头文件中定义全局变量,也允许我们在类定义中直接初始化静态数据成员:
struct Foo { inline static int foo = 1;};/* bar1.cc */#include "foo.h"int Bar1() { return Foo::foo + 1; }/* bar2.cc */#include "foo.h"int Bar2() { return Foo::foo + 2; }/* main.cc */int Bar1(), Bar2();int main() { return Bar1() + Bar2();}我们用gcc编译上述文件
g++ -std=c++17 -c main.cc bar1.cc bar2.cc # okg++ -std=c++17 -o main main.o bar1.o bar2.o # ok并用readelf分别查看各个目标文件,我们会发现这个内联的静态数据成员在bar1.o和bar2.o中都以弱符号的形式单独存在于一个段中,在链接后main只会包含一个foo符号,并且该符号对应的数据被合并到了.data段:
# 以下为 readelf -sS bar1.o | grep foo 和readelf -sS bar2.o的内容Section Headers:[Nr] Name Type Address Offset...[ 6] .data._ZN3Foo3fooE PROGBITS 0000000000000000 0000005c...Symbol table '.symtab' contains 13 entries:Num: Value Size Type Bind Vis Ndx Name...11: 0000000000000000 4 OBJECT WEAK DEFAULT 6 _ZN3Foo3fooE# 以下为readelf -s main | grep fooNum: Value Size Type Bind Vis Ndx Name...0000000000004010 4 OBJECT WEAK DEFAULT 23 _ZN3Foo3fooE可以看见在bar1.o和bar2.o中内联的静态数据成员被单独放到了名为.data._ZN3Foo3fooE的段中,这种将内联变量单独放置一个段的原因主要是为了在链接时消除重复代码,在链接合并段的时候面这些特殊的同名段会选择性地保留其中一个。
inline命名空间
inline命名空间是C++11标准中引入的关键词,对于一个用inline修饰的内嵌命名空间而言,它所包含的成员在可见性上如同声明在外围命名空间中一样,所以inline之于命名空间更具有字面上的含义:将内嵌命名空间在外围命名空间中“展开”。inline命名空间最主要的用途是为程序库的版本控制提供语言上的支持,有点类似于共享库中的[符号版本控制](https://zhuanlan.zhihu.com/[SymbolVersioning - GCC Wiki (gnu.org)](https://gcc.gnu.org/wiki/SymbolVersioning))(将程序使用的接口版本信息记录到可执行文件,[动态链接](https://www.zhihu.com/search?q=动态链接&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra={“sourceType”%3A”answer”%2C”sourceId”%3A2404153835})时再根据这些版本信息从[共享库](https://www.zhihu.com/search?q=共享库&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra={“sourceType”%3A”answer”%2C”sourceId”%3A2404153835})调用正确版本的接口),一般来说库的作者会为不同的版本放置到专属的命名空间,再用一个与版本无关的外围命名空间将它们包含,并通过[预编译指令](https://www.zhihu.com/search?q=预编译指令&search_source=Entity&hybrid_search_source=Entity&hybrid_search_extra={“sourceType”%3A”answer”%2C”sourceId”%3A2404153835})选择性地将开发环境支持的库版本对应的命名空间暴露给用户。例如下面的例子中库`libfoo`根据宏`some_predefined_macro`的值将不同版本的接口暴露给用户程序:
#define some_predefined_macro 2022L
namespace libfoo {#if some_predefined_macro >= 2022L inline#endif namespace libfoo_2022 { int foo(int); // better foo float foo(float); // new foo }#if some_predefined_macro >= 2019L && some_predefined_macro < 2022L inline#endif namespace libfoo_2019 { int foo(int); // old foo }// other versions ...}
using namespace libfoo;int main() { printf("foo(5) = %d\n", foo(5)); // refer to int libfoo::libfoo_2022::foo(int); // ...}当然,这种选择性地暴露内嵌命名空间成员乍一看也可以通过using namespace来完成,在C++11之前库的版本控制就是通过它来实现的。但用这种方式实现库的版本控制是有两个明显的缺陷:(1)在内嵌命名空间声明的模板无法在外围命名空间中进行特化,(2)不支持[ADL](https://zhuanlan.zhihu.com/[Argument-dependent lookup - cppreference.com](https://en.cppreference.com/w/cpp/language/adl))。一般来说库作者都不希望将版本相关的命名空间暴露给用户,而缺陷(1)又要求用户必须在模板所在的命名空间中对其进行特化,例如说下面这段代码就不行:
namespace libfoo { namespace libfoo_2022 { template <typename T> T &foo(T &); } using namespace libfoo_2022;}
namespace libfoo { template <> float &foo<float>(float &);}ADL的意思是在函数名字查找时自动将调用参数所属的命名空间包含进来,这样在函数调用时便无需显示指定作用域。那缺陷(2)意思是用内嵌命名空间的类型变量作为参数调用外围命名空间的函数,或者用外围命名空间的类型变量作为参数调用内嵌命名空间的函数是行不通的,例如下面这段代码也不行:
namespace libfoo { class Bar1 {}; namespace libfoo_2022 { void foo1(Bar1); class Bar2 {}; } using namespace libfoo_2022; void foo2(Bar2);}
int main(){ libfoo::Bar1 bar1; libfoo::Bar2 bar2; (void)foo1(bar1); // compile error (void)foo2(bar2); // compile error ...}inline命名空间可以解决using namespace在实现库版本控制时的缺陷,inline与using的区别在于用inline修饰的内嵌命名空间的成员表现得更像声明在外围命名空间:你不仅可以在外围命名空间中对inline的内嵌命名空间的模板进行特化,而且ADL也会将参数类型所在命名空间所包含的inline命名空间,以及自身作为inline命名空间所在的外围命名空间一并考虑进来:
namespace libfoo { class Bar1 {}; inline namespace libfoo_2022 { void foo1(Bar1); class Bar2 {}; template <typename T> T &foo(T &); } void foo2(Bar2);}
namespace libfoo { template <> float &foo<float>(float &);}
int main() { libfoo::foo(3.2); // call specialized libfoo::libfoo_2022::foo libfoo::Bar1 bar; libfoo::Bar2 bar2; foo1(bar1); // call lib::libfoo_2022::foo1 foo2(bar2); // call lib::foo2 ...}inline在修饰命名空间时还有一些别的特点,比如若inline命名空间与外围命名空间包含了名字重复的符号时,使用外围命名空间作为作用域对该符号进行引用将会导致编译错误,因为编译器无法确定你究竟引用了哪个命名空间的符号。但如果使用using namespace的话上述情况则总是指向外围命名空间中的符号。此外inline命名空间还具有传递性,这些具体的特性详见[cppreference](https://zhuanlan.zhihu.com/[Namespaces - cppreference.com](https://en.cppreference.com/w/cpp/language/namespace#Inline_namespaces)),但我认为inline修饰符引入到命名空间最主要的作用是在库版本控制时解决ADL和命名空间外模板特化的问题。
核心解析 inline namespace:
把一个命名空间标成 inline 后,其中的名字在外层作用域里像“直接声明在外层”一样可见(对未限定名查找/ADL可见),但符号名仍会带上这个命名空间做区分(影响符号mangling)。这让库可以同时提供多个版本的接口,并指定一个“默认版本”。
namespace mylib { namespace v1 { struct Foo { void old_api(); }; }
inline namespace v2 { // 当前默认版本 struct Foo { void new_api(); }; }}
// 用户代码:mylib::Foo x; // 实际是 mylib::v2::Foox.new_api(); // 未限定查找能直接用 v2 的名字// 仍可显式用老版本:mylib::v1::Foo y;y.old_api();查找行为:inline namespace 里的名字对外层是透明的,像直接在 mylib 里声明一样可见(未限定名查找、ADL 都能找到)。
ABI 行为:符号仍会被编码为 mylib::v2::Foo(带版本名),因此你可以同时提供 v1 和 v2 两套符号,老二进制继续链接 v1,新编译默认用 v2。
切换默认版本:只需把别的版本标成 inline 即可:
typedef和define(宏)有什么区别
- 用法不同:typedef用来定义一种数据类型的别名,增强程序的可读性。define主要用来定义常量,以及书写复杂使用频繁的宏。
- 执行时间不同:typedef是编译期处理,有类型检查的功能。define是宏定义,是预编译的部分,其发生在编译之前,只是简单的进行字符串的替换,不进行类型的检查。
- 作用域不同:typedef有作用域限定。define不受作用域约束,只要是在define声明后的引用都是正确的。
- 对指针的操作不同:typedef和define定义的指针时有很大的区别。
注意:typedef定义是语句,因为句尾要加上分号。而define不是语句,千万不能在句尾加分号。
如何加深理解移动构造和拷贝构造
class myobj{ public: myobj(int x):val(new int(x)){} int& getval(){ return *val; } myobj(const myobj& obj){ //拷贝构造 val = new int(*obj.val); } myobj& operator=(const myobj & rhs){ //拷贝赋值 if(this == &rhs){ return *this; } delete this->val; val = new int(*rhs.val); return *this; } myobj(myobj&& obj){ //移动构造 cout <<"mv" << endl; val = obj.val; obj.val = nullptr; } myobj& operator=(myobj&& rhs){ //移动赋值 cout <<"mv=" << endl; if(this == &rhs){ return *this; } if(this->val != nullptr){ delete val; } val = rhs.val; rhs.val = nullptr; return *this;
} ~myobj(){ delete val; val = nullptr; }
int* val;
};
int main(){ myobj a(5); myobj b(10); cout << a.getval() << endl; myobj c(a); //拷贝构造 cout << c.getval() << endl; myobj d = c; //拷贝构造。因为d对象之前不存在。 cout << d.getval() << endl; d = b; //拷贝赋值 cout << d.getval() << endl; myobj e = move(a); //移动构造。因为e对象之前不存在。在这之后不可访问a,因为a所有权已被转移 cout << e.getval() << endl; d = move(b); //移动赋值。在这之后不可访问b,因为b所有权已被转移 cout << d.getval() << endl; return 0;}首先我们要强化记忆,什么叫构造函数。构造函数就是创建对象的时候调用的。我们这里有一个类,里面有一根指针。首先,我们既然是构造,那么拷贝构造和默认构造都要对变量(指针)初始化(分配内存)。所以这里拷贝构造和默认构造都是new的。因为我们都是无中生有
那么移动构造和拷贝构造的区别在哪呢?
什么时候我们想要移动?假如我们要转移所有权,我们这时候会调用移动构造。也是无中生有。但是由于转移所有权,所以我们不需要new。我们只需要把原来指针指向的地址赋值给我们新变量的对应变量上即可。移动之后,因为我们的目的是转移所有权,所以应当对原对象的对应指针变量置空。
拷贝赋值和移动赋值。
-
拷贝赋值我们首先要检测自我赋值。通过地址来判断。如果是一个地址互相赋值,那么什么都不做。然后我们首先把自己的东西清理掉,也就是自己指针指向的资源释放掉。然后,由于我们是拷贝,不是移动。所以我们依旧要开辟新空间,把原来对象的指针指向的值复制过来。
-
移动赋值,我们首先也要检测自我赋值。然后也要先把自己的东西清理掉,也就是自己指针指向的资源释放掉。然后,由于我们是移动,所以我们直接复制指针而不是指针指向的值。然后把源对象的指针置空,因为我们是转移所有权。
-
返回值:
-
构造函数,无论是默认构造,拷贝构造还是移动构造,函数都无返回值。
-
赋值操作符,无论是拷贝赋值还是移动赋值,我们为了链式调用,也避免不必要的拷贝,都应该返回对象的引用。
-
-
形参:
-
拷贝构造和拷贝赋值,应该接受对象的常引用。
-
移动构造和移动赋值因为涉及到对源对象的修改,即 对源成员变量(指针)置空,所以不能是常量。而且要接收右值。因为是移动。
-
-
什么时候该触发移动构造呢?
-
如果临时对象即将消亡,并且它里面的资源是需要被再利用的,这个时候我们就可以触发移动构造。
- 比如
vector.push_back(obj(8));这就是往容器添加一个临时对象。这时候如果此临时对象有移动构造,则调用完默认构造后,直接触发移动构造进行搬移省去一次内存分配。否则需要调用拷贝构造。
- 比如
-
移动构造在使用vector的情况下,一般是vector扩容的时候重新分配内存的时候使用,如果元素的自定义类型有移动构造就会用移动构造。没有就是拷贝构造。这里的移动构造必须是
noexcept
-
针对自定义类强制生成移动构造
针对自定义类强制生成移动构造会满足member-wise move。也就是移动。它会帮我们调用每一个成员的移动构造。
class myobj{ public: int val; //基本数据类型 string str; //自定义类型可移动 unique_ptr<int>u_ptr = nullptr; //智能指针,也算自定义类型可移动
myobj(int x, const string& rhsstr, int num): val(x), str(rhsstr), u_ptr(make_unique<int>(num)){ cout << "const" << endl; } myobj(myobj&& rhs) = default; //强制生成移动构造。};int main(){ myobj obj(4, "abc", 22); cout << *obj.u_ptr << endl; cout << obj.str << endl; return 0;}/*输出const22abc*/如果决定移动它:
int main(){ myobj obj(4, "abc", 22); cout << *obj.u_ptr << endl; myobj obj1(move(obj)); //移动后 if(obj.u_ptr != nullptr){ cout <<"not null" << endl; } else{ cout <<"null" << endl; } cout << obj.str << endl; return 0;}/*输出const22null(这行是空字符串)
*/- 我们看到,
unique_ptr和string都被正确移动了。原对象的智能指针为空,字符串也为空。
但是,裸指针(指针类型)并没有移动构造,所以必须写出我们自己的移动构造。包括两个部分,一个部分是设置为default强制生成构造函数可以帮我们完成的member wise move。另一个部分是给原始指针进行置空
class myobj{ public: int val; //基本数据类型 string str; //自定义类型可移动 int* ptr = nullptr; //注意此处替换为原始指针
myobj(int x, const string& rhsstr, int* num): val(x), str(rhsstr), ptr(num){ cout << "const" << endl; } myobj(myobj&& rhs) = default; ~myobj(){ delete ptr; ptr = nullptr; }};int main(){ myobj obj(4, "abc", new int(22)); cout << *obj.ptr << endl; if(obj.ptr != nullptr){ cout <<"not null" << endl; } else{ cout <<"null" << endl; } cout << obj.str << endl; return 0;}/*输出const22notnullabc*/如果我们决定移动它:
int main(){ myobj obj(4, "abc", new int(22)); cout << *obj.ptr << endl; myobj obj1(move(obj)); cout << *obj1.ptr << endl; if(obj.ptr != nullptr){ cout <<"not null" << endl; } else{ cout <<"null" << endl; } cout << obj.str << endl; return 0;}/*输出const2222 //此行为obj1的输出。也是22notnull(这行是空字符串)*/- 我们看到,
string被正确移动了。原对象的字符串为空。但是由于原始指针没有自己的移动构造,所以编译器只能帮助我们进行member wise move,无法帮助我们给原始指针进行置空。
所以我们要这么写:
myobj(myobj&& rhs): val(move(rhs.val)), //基本数据类型,这么写永远不会错。虽然没什么用。 str(move(rhs.str)), ptr(move(rhs.ptr)){ //原始指针类型,这么写永远不会错。虽然没什么用。 rhs.ptr = nullptr;}于是就会有正确结果:
int main(){ myobj obj(4, "abc", new int(22)); myobj obj1(move(obj)); cout << *obj1.ptr << endl; if(obj.ptr != nullptr){ cout <<"not null" << endl; } else{ cout <<"null" << endl; } cout << obj1.str << endl; return 0;}/*输出const22 //此行为obj1的输出。也是22null //obj的指针已经空了。abc //此行为obj1的字符串。正确移动了。*/for循环
for ( init; condition; increment ){ statement(s);}for循环的更新条件(第三个条件)是迭代之后执行的,也就是最后执行的。
重要优化 for循环的判断表达式(第二个条件)是每一次循环都会执行。如果判断表达式中有函数调用则每次都会调用
如下面代码,for循环调用了五次,则func函数也会被调用5次。
int func(int x) { cout <<"call" << endl; return 5;}int main() {
for (int i = 0; i < func(i); i++) { cout << "for" << endl; } return 0;}i++和++i
- ++i ++i 先自加,再赋值。
#include<stdio.h>int main(){ int i = 0; int j = ++i; cout << i << j <<endl; return 0;}此时输出 i=1 j=1
- i++
i++ 先赋值,再自加。
#include<stdio.h>int main(){ int i = 0; int j = i++; cout << i << j <<endl; return 0;}此时输出 i=1 j=0
i++是右值,++i是左值
在内置类型的情况下
int a = i++;这句话在编译器眼里是下面这样的两句话:
int a = i;i++;而
int a = ++i;在编译器眼里则是这样:
i++;int a = i;i++和++i在非自定义类型的情况下,只要不发生赋值,则原理没有差别。但是性能有差别。
我们深入看一下自定义类型的情况
struct mybase{ // 前置++ mybase& operator++() { data++; return *this; }
// 后置++ const mybase operator++(int) //注意返回const { auto tmp = *this; // 执行++有两种选择, data++或者调用上面的前置++ data++;
return tmp; //注意这里注意这里temp是局部变量,不可返回引用!! }
int data = 0;};注意这里后置的++我们有一个非常奇怪的写法。我们用一个临时变量保存了自己,然后再把自己的值+1,然后返回一个自己的拷贝。不能返回引用!因为这里的temp是临时变量,返回引用就炸了
同时应为其添加const。原因是i++++这样的调用并不应该合法。首先因为它不符合如int这样的内置类型的语义。其次,i++++的第二个++是作用于i++返回值的临时对象身上的,所以最终i也只会被++一次。
这也就是为什么i++先赋值再自增了。因为我们赋值过去的是一个没有自增的自己。
这也是为什么i++是一个右值。因为他符合了右值的定义之一:返回了一个非引用类型的 函数调用。因为++本身也可以重载,也是函数调用。他返回了一个临时对象的自己。
所以++i反而看起来非常简单。我们先给自己+1然后返回自己的引用。这也是为什么++i是先自增再赋值,也是为何++i是左值。
性能区别
-
内置类型(比如
int):- 编译器会优化,所以前置++和后置++性能无差别。
-
自定义类型(STL迭代器):
- 前置++操作的性能优于后置++
__normal_iterator& operator++(){ // 前置操作++_M_current;return *this;}__normal_iterator operator++(int){ // 后置操作return __normal_iterator(_M_current++);}- 上面是STL中iterator的源码。从上面代码可以看出,迭代器的前置和后置操作主要有以下两个区别:
- 返回值:前置操作返回对象的引用,后置操作返回类型为对象,
- 拷贝:前置操作无拷贝操作,后置操作存在一次对象拷贝
- 正因为这两个原因,前置操作符就地修改对象,而后置操作符将导致创建临时对象,调用构造函数和析构函数(某些情况下编译器会做优化,此处不做讨论),导致了前置操作和后置操作的性能差异。
-
其他自定义类型:
- 前置++操作的性能优于后置++。
编译过程
记住ISO即可
.h/c/cpp通过 预处理器处理为.i的预处理代码
.i的预处理代码通过编译器处理为.s的汇编代码
.s的汇编代码通过汇编器处理为.o的目标代码(可重定位二进制)
.o的目标代码通过链接器生成可执行文件.exe/.out (如果没有外部代码或者dll/lib库文件就直接生成可执行文件)
从cpp源代码到可执行程序经过了哪些过程?
A: 在Linux系统下从.cpp开始, 经过
1.预处理阶段, 在这部分主要处理include的文件包含关系, 还有宏的替换, 做完.cpp变为.i 2.编译阶段会做语法分析还有优化之类的, 将代码转换为汇编, 做完.i变.s 3.汇编阶段会把前面得到的汇编代码转换为二进制的机器代码, 做完.s变.o 4.最后运行链接器将所有可重定位文件合并为一个可执行文件, 做完.o变prog. 对于可执行文件可以调用系统中被称为加载器的函数来将文件复制到内存并开始执行.
其中自己了解较多的是最后的链接阶段. 链接器为了将输入的多个可重定位文件组合为一个可执行文件, 要做的事主要有两个, 一是符号解析, 二是重定位. 其中符号解析意思是说一个文件里会有很多对符号的定义和引用, 所谓符号就是全局变量,函数和静态变量这些. 然后符号解析就是将每个符号引用与一个符号定义关联起来. 而重定位做的事是把每个符号定义与一个内存地址关联起来, 然后将所有对这个符号的引用都指向这个地址.
详细说符号解析的话需要先说链接器的输入, 也就是可重定位文件的文件格式. 虽然它是二进制文件, 但实际上是有各种分段的, 比如有个固定的头部, 描述了文件类型, 机器类型等等一些主要信息. 还有放机器代码的段, 再往下还有放全局变量的段等等. 而文件中会有一个放符号表的段, 其中存放了这个文件定义和引用的全局变量以及函数这些信息.
符号表中有三类不同的符号主.分别是1.由当前文件定义的全局符号(定义的全局变量,函数等) 2.引用的其他文件定义的全局符号, 3.只被当前文件定义和引用的符号(static全局变量和函数). 每个符号条目并不是只有一个名字, 而是有一个固定的格式结构. 这个结构会标明符号名字, 大小, 类型(变量还是函数), 链接性(全局变量是GLOBAL, static全局变量大概会是LOCAL)等等.(之前看到过一个问题是说为什么static全局变量可以把作用域限制在本文件, 讲到这里就可以回答这个问题了. 因为static符号被单独分了一类, 链接器不会拿static符号去跟别的文件做解析.)
符号解析就是利用这些符号表信息去做解析的. 对于那些定义和引用都在同一文件的符号解析很简单. 但是本文件引用了其他文件定义的符号就会复杂一些. 编译器会把这样的只有引用的符号交给链接器, 由链接器去其他文件找这个符号的定义, 如果找不到就会报错. 符号解析还有一个问题是重名问题, 编译器在编码符号的时候会给他一个强弱属性, 已初始化的全局变量就是强, 未初始化的就是弱. 然后如果重名, 链接器去选择的时候会优先选择强符号, 如果都是弱符号, 那就随便选一个. 但如果两个重名符号都是强那会直接报错.
符号链接还可以跟静态库链接(静态库就是提前写好的一些函数文件打包为一个单独文件, 可以用它来当作链接器输入). 在链接静态库的时候, 链接器会维护三个列表: 1.可重定位文件的列表, 2.未解析的符号(有引用但还没定义的符号) 3.已定义的符号. 链接器会从左向右扫描文件然后用这三个表来做符号解析. 这其中要注意的问题是文件的顺序很重要, 顺序不对了解析会失败.
上面就是符号解析的说明了, 接下来是重定位部分. 重定位要做的就是把文件合并一下,然后给每个指令和符号分配内存地址. 再然后就是把对符号的引用指向刚才分配好的地址.
重定位做完就可以得到一个可执行的目标文件.文件由三个大部分组成: 1.只读代码段, 2.读写数据段, 3.不加载进内存的符号表和调试信息这些. 而将一个可执行文件加载到内存后所呈现的布局主要有四个大的部分. 从下到上分别是:1.只读代码段, 2.读写数据段(用来放全局变量, 细分为已初始化和未初始化的两部分), 3.堆, 4.栈. 然后在堆栈之间还有预留给动态库的内存映射区域. 最后在栈的上面还有用户不可见的内核内存.
整数相除
两个整数相除,无论用什么接都是整数。因为会自动窄化。所以想要让两个整数相除保留小数点,则必须转换成double或float再进行除法操作
int a = 3;int b = 6;double c = a/b;// C = 0;double a = 3;double b = 6;double c = a/b;// C = 0.5形参(parameter)和实参(argument)区别
- 形参 parameter是在函数头的参数
void func(int parameter){
}这里我们明显看到了parameter的位置
- 实参 argument是传递的参数
int argument = 10;func(argument);这里我们明显看到了argument的位置
函数参数(parameter)的默认值的继承
c++的函数参数的默认值是不可以被继承的。表面上可以使用只是“借用”,但不是继承。同时会有奇怪调用。 我们看下面的例子
struct A { virtual void f(int a = 7){ cout << a; cout <<"A" << endl; }};struct B : public A { void f(int a){ cout << a; cout << "B" << endl; }};int main() { A* pa = new A; B* pb = new B; A* m = new B;
pa->f(); //7A pa->f(10); //10A
pb->f(); //error: no matching function for call to ‘B::f()’ pb->f(10); //10B
m->f(); //7B m->f(10); //10B}-
**虚函数调用中使用的默认参数(argument,参数的默认值)由对象的(指针或引用)的静态类型决定。 派生类中的重写的虚函数不会从被它重写的虚函数中获取默认参数。**来自标准库文档
- 表面上的参数默认值的继承其实是借用,而不是继承。
pb->f(),参数的默认值从静态类型决定。所以此处参数的默认值应该是从B类寻找。但是B类重写的函数的参数没有默认值,导致没有合适的值放入函数调用。函数签名不匹配,无法调用。
- 表面上的参数默认值的继承其实是借用,而不是继承。
-
**当父类虚函数和子类虚函数参数都有默认值,但是值不同的时候,如果产生了多态调用,则此时会忽略子类默认值,使用父类默认值,但是实际调用的是子类函数。**也就是在使用父类指针指向的对象调用虚函数时,函数会按实际指向的对象调用对应的成员函数(动态绑定的结果),而函数的默认参数依旧为父类对象中的默认参数(静态绑定的结果) 所以永远不要重新定义一个继承而来的默认参数值,因为默认参数值是静态绑定的,而虚函数——你应该重新定义的唯一的函数——是动态绑定的。effective C++ 37条
类(对象)内存模型:
大小
-
类内存大小有关的:
-
非静态数据成员(包括常量)。也就是常量会对类大小有影响。
-
虚函数表指针(虚函数产生)
-
虚基表指针(虚继承产生)
-
-
类内存大小无关的:
- 成员函数
- 静态成员函数
- 静态数据成员
- 静态常量数据成员
-
空类大小为1,为了分配一个内存起始地址
- 空类被继承后,会有空基类优化,所以空基类的占用大小会变成0。前提是当前继承空基类的类不是空类。
class x {};class y:public x{int a;};//sizeof(x) = 1//sizeof(y) = 4- 类内如果含有空类的对象,则空类对象大小依旧会被算为1。
class x {};class y:public x{x objint a;};//sizeof(x) = 1//sizeof(y) = 8//基类对象 1 + int 4 + 补齐 = 8- 如果是链式空基类继承,则所有的空类大小都为1。
class x {};class y:public x{};class z:public y{};//sizeof(x) = 1//sizeof(y) = 1//sizeof(z) = 1
内存布局
内存对齐
C++类成员变量的内存分布是:按照声明顺序,从上到下,按照内存对齐的原则进行分布的。
用预编译命令#pragma pack(n) 或结构体名字前加 alignas(n)用来指定对齐系数(单位)为n个字节。n的取值范围为1, 2, 4, 8, 16。gcc默认对齐系数是4,msvc默认对齐系数是8。
struct alignas(4) EbaInfo { uint8_t eba_switch; uint8_t eba_state; uint8_t eba_direction;};- 内存分配的顺序是按照声明的顺序。
- 类中第一个成员的偏移量(offset)为
0,以后每个成员(该成员的数据类型长度为k)相对于结构体首地址的offset为min(k, s)的整数倍。 - 如果一个类里有结构体成员,则结构体成员要从其内部最宽基本类型成员的整数倍地址开始存储。
- 整体对齐规则:整个结构体的大小应是对齐单位
s的整数倍。
检查结构体对齐单位可以使用alignof()。 使用g++ -fdump-lang-class *.cpp生成布局信息文件。
举例:
class A { char a; int b; double c;};
class B { char a; double b; int c;};
int main() { cout << sizeof(A) << endl; //16 cout << sizeof(B) << endl; //24}A类的大小:
char a占1个字节,偏移值为0,目前A类占1字节。int b占4个字节,根据内存对齐原则的第二条,b起始位置的偏移量应该4的整数倍,所以b要在a后面空3个字节,然后放入,因此偏移值为4,目前为止A类占用8个字节(3个padding)。double c占8个字节,可以直接从b后的第一个字节开始放入,偏移值为8。此时A类占用16字节,符合内存对齐的第三条原则,整个类的大小(16)是对齐单位(8)的整数倍,因此不需要补齐。所以A类总共占用16字节。
同理,B类的大小:
char a占1个字节,偏移值为0,目前B类占1字节。double b占8个字节,根据第二条规则,b要在a后面空7个字节,然后开始放入,因此偏移值为8,目前为止B类占用16个字节(7个padding)。int c占4个字节,可以直接从b后的第一个字节开始放入,偏移值为16,此时B类占用20个字节。根据内存对齐的第三条原则,整个类的大小应该是对齐单位(8)的整数倍,因此需要补齐3个字节到24字节。所以B类总共占用24字节。
带有虚函数的情况:
class D {public: virtual void funA();
private: char a; int b; double c;};
int main() { cout << sizeof(D) << endl; //24}vptr占8个字节,偏移值为0,目前D类占8字节char a占1个字节,偏移值为8,目前D类占9字节int b占4个字节,根据内存对齐原则的第二条,b起始位置的偏移量应该4的整数倍,所以b要在a后面空3个字节,然后放入,因此偏移值为12,目前为止D类占用16个字节(3个padding)。double c占8个字节,可以直接从b后的第一个字节开始放入,偏移值为16。此时D类占用24字节,符合内存对齐的第三条原则,整个类的大小(24)是对齐单位(8)的整数倍,因此不需要补齐。所以D类总共占用16字节。
所以在某种极端情况,如这样
class a{ char a; int b; char c; int d; char e; int f; char g; int h;};
class b{ char a,b,c,d; int e,f,g,h;};
int main() { cout << sizeof(a) << endl; //32 cout << sizeof(b) << endl; //20 return 0;
}因为根据规则,a的每一个char后都需要补3位为了满足每一个变量的起始偏移地址必须为该变量大小的整数倍。这里int是4,所以必须要补到4这样是1倍。所以每一个char都占据了一个int空间。所以整个class相当于是4*8 = 32。
然而b的四个char连续放置。1是1的整数倍所以不需要补齐操作。所以只有4+4*4 = 20。
由此可见,变量的声明顺序会极大地影响类的内存布局和类对象的大小。
出现在派生类中的 base class subobject 有其完整原样性
无论是否是多继承下,每一个继承的类,会先进行对齐,然后再进行下一个继承。
假设类A是(8+1)9 + 补齐 = 16,类B也是9 + 补齐 = 16, 类C继承了类A和类B,所以类C是32 (多继承)
假设类A是(4+1)5 +补齐 = 8,类B继承了类A但是类B自己也是5,则会变成类A的8 + (4+1)+ 补齐的3 = 16, 类C继承了类B然后自己是4,就是 16 + 4 = 20。
因为C++ Standard 保证:“出现在派生类中的 base class subobject 有其完整原样性!” 子类会被放在父类的对齐空白字节之后,因为父类的完整性必须得以保证,父类的对齐空白字节也是父类的一部分,也是不可分割的。所以会保持继承->对齐->继承第二个->对齐… 深入探索C++对象模型
类内函数内声明的变量(局部变量)作用域是函数而不是类
所以类的函数内的变量不会算作类的大小。
class test{ public: void funcs(){ int val; }};大小一定是1。
NRV优化
NRV优化一句话就是,在函数返回值是值传递的时候,按理来说需要有临时变量调用拷贝构造。编译器对这些事情有优化。
内置类型:
如int double ,指针等内置类型,使用eax寄存器直接储存,然后访问
自定义类型:
一句话:编译器会把函数返回值当成形参,然后直接写回。
举例:
void myfunc(solution& ret, solution& a, solution& b);
solution myfunc1(solution&a, solution& b);我们的myfunc和myfunc1起到了同样作用,只不过我们人为写成两种形式,一种是返回值,一种是写回。编译器也是优化成了这样,把我们外部接着返回值的变量以**引用(这样才能写回)**方式当做函数形参,然后函数仅需写回即可。
举例:
原函数和调用代码
Vector add(Vector& a, Vector & b){ Vector v; v.x = a.x + b.x; v.y = a.y + b.y; return v;}int main(){ Vector a, b; Vector c = add(a, b); return 0;}编译器优化过的函数和调用代码:
void add(Vector& __result, Vector& a, Vector & b){ __result.x = a.x + b.x; __result.y = a.y + b.y; return;}int main(){ Vector a, b; Vector c; add(c, a, b); return 0;}https://www.cnblogs.com/autosar/archive/2011/10/09/2204181.html
类的私有静态变量可以通过作用域访问运算符直接访问
main函数结束也会为栈对象调用析构,但是不会为堆对象调用。
类内函数内声明的变量(局部变量)作用域是函数而不是类
所以类的函数内的变量不会算作类的大小。
指针和引用的区别:
引用从来都不是所谓的“指针包装器”。它们的行为完全不同。是完全不同的两种数据类型。
-
可以把引用看成一个const指针。因为是const指针所以必须定义时初始化,也不能更改指向。但是这个并不全对。比如
-
double p = 3.33;int& ref = p; //错误int&& ref = p;//可以。
-
我们上面提到了。隐式类型转换会创建临时对象。这里就是调用了
int的形参为double的构造函数创建了一个临时对象。临时对象是右值。右值没有地址。我们这里用的又是左值引用,自然会产生错误。 -
所以我们注意到了,隐式转换的临时变量是右值。所以可以用右值引用去接。但是!!这时候这个ref并不是p的引用,而是一个临时变量的引用。ref此时代表的并不是p而是一个临时对象!
-
-
指针是一个单独的实体,引用则是别名
- 所以指针有地址
- 引用虽然(可能)也有地址(也分配内存),但是引用和引用所引用的变量共用一块内存空间。当然了,引用本身确实有自己的内存空间,和指针一样。但是经过编译器处理后,访问这块内存时将直接转而访问其指向的内存。因此在程序中无法读取到这块内存本身。(依靠实现)
-
引用不可以赋值,所以引用只能在定义时初始化一次,之后不可更改。指针可以更改该并且可以把定义和初始化分开。
-
引用不能为空,指针可以为空。
-
sizeof指针的大小是指针自己的大小。sizeof引用是对象的大小。 -
没有引用的引用,没有引用数组,也没有指向引用的指针。
- 下面我们的
b和c都是a的引用。c并不是b的引用。因为没有引用的引用。
- 下面我们的
int main(){ int a = 10; int &b = a; int &c = b; c = 20; cout << a << b << c <<endl; //20 20 20 return 0;}-
指针有自增操作。
-
引用不可以重新赋值(不能更改指向)
int main(){ int a = 10; int b = 20; int c = 30; int& aref = a; cout << aref << endl; //10 aref = c; //注意这里! cout << aref << endl; //30 cout << a << endl; //30 return 0;}我们看到aref是a的引用,也就是它俩是一个东西。执行aref = c的时候,并不是把aref变成c的引用,而是把c的值赋给aref也就是赋给a的引用。所以最后a和aref都会变成30。
- 使用一个引用给一个变量赋值,则会调用其拷贝构造构造出一个新的变量。因为引用的行为和普通变量一样
int a = 10;int& b = a;int c = b; //在这里a会被拷贝然后给c。也就是c会被拷贝构造。因为如果这里换成int c = a,也是会被拷贝构造。引用就相当于变量的别名。所以这里引用和普通变量行为一样- 自然而然的,函数的值传递和引用传递可以解释通了
void func(int& a);void func1(int a);
int var = 100;int& ref = var;
func(var);func(ref);func1(var);func1(ref);-
第一个调用:标准的引用传递。
- 变量
var传递进函数func的时候,函数内部会创建一个叫a的引用,引用的对象是外部的var
- 变量
-
第二个调用:引用的引用。
- 引用
ref传递进函数func的时候,函数内部会创建一个叫a的引用,引用的对象是引用ref的引用对象也就是var。因为没有引用的引用。
- 引用
-
第三个调用:标准的值传递。
- 变量
var传递进函数func1的时候,函数内部会创建一个叫a的变量,变量拷贝构造自外部的var。
- 变量
-
第四个调用:也是值传递。
- 引用
ref传递进函数func1的时候,函数内部会创建一个叫a的变量。我们刚提到了,使用引用初始化一个普通变量会调用拷贝构造,拷贝自引用的引用对象。所以这里a的变量是拷贝自引用ref所引用的对象,也就是var。
- 引用
-
移动一个元素的引用就等同于移动一个元素本身
int main(){ myobj a(200); myobj& b = a; //b是a的引用 myobj c = move(b); //这里移动b和移动a效果相同 cout << *a.val << endl; //无论访问a还是b都是无效。因为移动b等同于移动a。 return 0;}引用的可能实现
C++ 标准只说明它应该如何表现,而不是它应该如何实现。
一般来说编译器会把引用实现为指针。并采用特殊优化。比如int& i = j。编译器在编译的时候会把所有遇到i的地方替换为j的内存地址。也就是在符号表内添加类似注释的东西通知i是j的别名。所以在底层,引用确实可能会被分配内存,也可能不分配。
内置类型使用引用传递不会提高性能
这之所以不能提高性能,是因为在底层实现上,按引用传递还是通过传递参数的地址实现的。地址会被简单编码,这样可以提高从调用者向被调用者传递地址的效率。不过按地址传递可能会使编译器在编译调用者的代码时有一些困惑:被调用者会怎么处理这个地址?理 **论上被调用者可以随意更改该地址指向的内容。这样编译器就要假设在这次调用之后,所有缓存在寄存器中的值可能都会变为无效。**而重新载入这些变量的值可能会很耗时(可能比拷贝对象的成本高很多)。你或许会问在按 const 引用传递参数时:为什么编译器不能推断出 被调用者不会改变参数的值?不幸的是,确实不能,因为调用者可能会通过它自己的非 const引用修改被引用对象的值(这个解释太好,另一种情况是被调用者可以通过 const_cast 移除参数中的 const)。----C++模板第二版 7.2.1
继承权限和访问权限
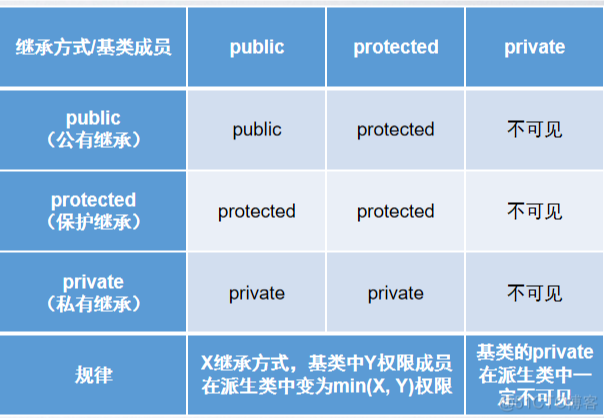
默认继承方式
继承的默认类型取决于继承(派生)类型,而不是正在继承的类型(基类)。
- struct,默认为public
- class,默认为private
class A {};struct B: /* public */ A {}; //派生类型是struct,默认为public
struct A {};class B: /* private */ A {}; //派生类型是class,默认为private函数指针和类成员函数指针
//静态的成员函数指针语法:void (*ptrStaticFun)() = &ClassName::staticFun;//成员函数指针语法:void (ClassName::*ptrNonStaticFun)() = &ClassName::nonStaticFun; //必须加作用域<返回值类型>(<类名>::*<指针名称>)(<参数列表>) = &<类名>::<非静态成员函数名称>我们来通过具体例子来说明其中的坑。
void normal_func(){ cout << "func" <<endl;}
void call_back_test(int& a, int& b){ cout << a + b << endl;}
class test{ public: int val = 5; void class_nonstatic_func(){ cout << "class_nonstatic_func" <<endl; } static void class_static_func(){ cout << "class_static_func" <<endl; } void callback(void(*ptr)(int&, int&), int& a, int& b){ ptr(a, b); //普通函数调用 void(*normal_funcptr)() = &normal_func; //类内获取全局函数指针。注意全局函数必须写在这一行的前面。 normal_funcptr(); //调用 语法糖 (*normal_funcptr)(); //调用
void(test::*class_nonstatic_func_ptr)() = &test::class_nonstatic_func; //类内获取类非静态成员函数指针 (this->*class_nonstatic_func_ptr)(); //调用。调用类成员函数指针必须加*解引用。而且需要绑定对象。类内就是用this。
void(*class_static_func_ptr)() = &test::class_static_func; //类内获取类非静态成员函数指针 class_static_func_ptr(); //调用 语法糖 (*class_static_func_ptr)(); //调用
}};
int main(){ void (*normal_funcptr)() = &normal_func; //普通函数指针 void (*normal_funcptr1)() = normal_func; //也可以不取地址。语法糖。
normal_funcptr(); //调用方式,不解引用也可以,语法糖 normal_funcptr1();
(*normal_funcptr)(); //解引用,正确方式。应该这么写,更加清晰。 (*normal_funcptr1)();
test classobj; test* classobj_ptr = new test(); void (test::*class_nonstatic_func_ptr)() = &test::class_nonstatic_func; //获取类非静态成员函数指针,必须取地址 //获取类获取类非静态成员函数指针 必须在指针名字前面加类作用域,用来辨别。 (classobj.*class_nonstatic_func_ptr)(); //对象调用。调用类成员函数指针必须加*解引用。而且需要绑定对象(通过对象调用)。 (classobj_ptr->*class_nonstatic_func_ptr)(); //指针调用。调用类成员函数指针必须加*解引用。而且需要绑定对象(通过对象调用)
void(*class_static_func_ptr)() = &test::class_static_func; //获取类静态成员函数指针 ,必须取地址 //获取类获取类静态成员函数指针 不需要指针名字前面加类作用域。因为静态成员函数可以理解为在类作用域内的全局函数。 //所以取地址还要加作用域,函数名字不需要。 class_static_func_ptr(); //直接调用。语法糖 (*class_static_func_ptr)(); //直接调用。解引用
//!(classobj.*class_static_func_ptr)(); //对象调用错误 //!(classobj_ptr->*class_static_func_ptr)();//指针调用错误
return 0;}-
声明
- 普通函数指针
- 直接取名字即可
- 类成员函数指针
- 必须在指针名字前面加类作用域,用来辨别。
- 类静态成员函数指针
- 和普通函数指针一样,不需要加作用域。因为静态成员函数可以理解为在类作用域内的全局函数。(所以赋值依旧需要取地址+作用域)
- 普通函数指针
-
赋值
- 普通函数指针
- 可以直接用函数名赋值。语法糖。
- 也可以取地址
- 类成员函数指针和类静态成员函数指针
- 赋值必须要加作用域解析运算符并且取地址
- 普通函数指针
-
调用
- 普通函数指针
- 直接调用。语法糖
- 解引用调用。注意解引用必须加括号。
- 类成员函数指针
- 不可以直接调用,必须解引用。同时必须绑定对象使用对象调用或对象指针调用
- 类内必须使用this用来充当绑定对象。
- 类静态成员函数指针
- 和普通函数指针一样。
- 直接调用。语法糖
- 解引用调用。注意解引用必须加括号。
- 普通函数指针
成员函数模板 函数指针和类模板 成员函数指针
template<typename T> //类模板class myclass{ public: void func(){ cout << "class func" << endl; } int func2(int a){ cout << "class func2" << endl; return a; }};
class nclass{ public: template <typename T> void func(T a){ cout <<"nclass func" << endl; cout << a << endl; } template <typename RT, typename T> //函数模板 RT func2(T a){ cout <<"nclass func" << endl; cout << a << endl; return a; }};- 由于模板本身没有地址(模板中详细介绍过),所以必须要依托其实例化后的东西才可以。所以需要显式指明模板参数。
- 类模板成员函数指针
- 左侧指针声明的时候,不仅要依照类成员函数指针语法,同时要显式指明类模板参数。
- 右侧进行取地址的时候,也必须要指定类模板参数。因为不指定参数不会引发实例化,无法取地址。
myclass<int> myclassobj; //实例化的对象
void(myclass<int>::*myptr)() = &myclass<int>::func;(myclassobj.*myptr)();
int(myclass<int>::*myptr2)(int) = &myclass<int>::func2;(myclassobj.*myptr2)(4);- 成员函数模板函数指针
- 左侧指针声明的时候,由于此时不涉及类模板,则语法和普通类成员函数指针一致
- 右侧取地址的时候,由于函数模板可以自动推导类型。所以不需要显式指明模板参数。
nclass nclassobj; //实例化的对象
void(nclass::*nptr)(int) = &nclass::func;(nclassobj.*nptr)(234);
float(nclass::*nptr2)(int) = &nclass::func2;(nclassobj.*nptr2)(2343);
float(nclass::*nptr_noneed)(int) = &nclass::func2<float, int>; //不是必须显式指明模板参数。(nclassobj.*nptr_noneed)(2343);类成员(变量)指针
-
类成员变量指针与普通意义上的指针不一样。存放的是类内偏移量。
-
指向成员变量的指针并不指向某一个具体对象的内存地址。它指向的是一个类的特定成员,而不是指定某一个特定对象的成员。
-
指向类成员变量的指针”的实现方式是获取该类成员在类中的偏移值,这也同样印证了指向类成员变量的指针不可以单独访问 (依赖于某一特定对象) 的原因 —— 它只是偏移值,需要通过特定的对象来访问该对象此偏移值处的子对象。
-
在我们对一个 “指向类内数据成员的指针” 赋予初始值,实际上是获得了该数据成员在类内的偏移量。除非是对一个类内的 static 数据成员进行
&操作,否则不会带来一个实际的地址,而是一个偏移量。
//静态的成员变量指针语法:int *ptrStaticitem = &ClassName::Staticitem<成员变量数据类型>*<指针名> = &<类名>::<静态数据成员名称>//成员变量指针语法:int ClassName::*ptrNonStaticitem = &ClassName::nonStaticitem<成员变量数据类型><类名>::*<指针名> = &<类名>::<非静态数据成员名称>class person{ public: int id = 20; static int info;};int person::info = 10;
int main(){ person human; person* human_ptr = new person(); int person::*nonstatic_ptr = &person::id; //非静态成员变量指针 cout << human.*nonstatic_ptr << endl; //必须对指针解引用后通过对象或指针访问 cout << human_ptr->*nonstatic_ptr << endl; //指针解引用访问。
int* static_ptr = &person::info; //静态成员变量指针 cout << *static_ptr << endl; //解引用 cout << person::info << endl;//直接通过作用域运算符访问类静态成员变量。 return 0;}- 非静态成员变量:
- 和非静态成员函数相似。不可以直接使用,必须解引用后绑定对象使用对象调用或对象指针调用
- 静态成员变量:
- 和静态成员函数相似。可以直接使用,不必绑定对象。
类成员(变量)指针和类成员函数指针的具体区分方式在模板的结尾。但是记住一点,类成员函数指针是类成员(变量)指针的子集。
为构造函数提供默认值
两种方式。第一种是用构造函数初始化列的方式:
class test{ public: test(int x = 5, int y = 10):_x(x), _y(y){}; int _x, _y;};int main(){ test t; cout << t._x << endl;}第二种是常规方式
class test{ public: test(int x = 5, int y = 10){ _x = x; _y = y; } int _x, _y;};int main(){ test t; cout << t._x << endl;}指针名称解读
顺序系列
int* p[10]意思是p是一个大小为10的储存int*类型指针的数组 。- 它是一个指针数组
int (*p)[10]意思是有一个指针p指向一个大小为10的储存int类型的数组。- 它是一个指向数组的指针
int* p(int)是一个名为p的函数,这个函数返回int*,入参是int。- 它是一个函数
int (*p)(int)是一个名为p的函数指针,这个函数指针指向的函数返回值为int,入参为int。- 它是一个函数指针
const系列 const关键字总是优先作用于左侧的东西,除非左侧没东西。
const int *ptr; = int const *ptr; = const int* ptr; = int const* ptr- 把
*念成指向, 这句话翻译过来就是:指针ptr指向const int - 这是一个常量指针。
- 把
int* const ptr- 把
*念成指向 这句话翻译过来就是:const指针ptr指向int
- 把
- “const int* const ptr`
- 把
*念成指向 这句话翻译过来就是:const指针ptr指向const int
- 把
指针计算
指针A给指针B赋值的意思是将指针A指向的地址赋给指针B
int digit = 5;int* a = &digit;int* b = a; //指针a指向的地址赋给指针b 没有新对象产生所以不会调用拷贝构造。int* c = &*a; //等同于将指针a先解引用(*a = 5),得到指针a指向的的值。然后把这个值取地址(&*a)赋值给指针c。
cout << b << endl; //打印b储存的地址。也就是b指向的地址。 等同于&digit和*&bcout << *b << endl; //解引用b 打印b指向的地址的值。cout << &b << endl; //打印b自己的地址。cout << &digit << endl; //打印变量地址。再来个例子:
int a = 5;int* ptr = &a;
cout << &a <<endl; //打印a的地址。0x61fe1ccout <<ptr << endl; //打印指针ptr储存的值,也就是a的地址。0x61fe1ccout <<&ptr << endl; //打印指针ptr自己的地址。0x61fe10cout <<*&ptr << endl; //打印指针ptr储存的值。也就是a的地址。0x61fe1c// *&ptr = ptr = &a;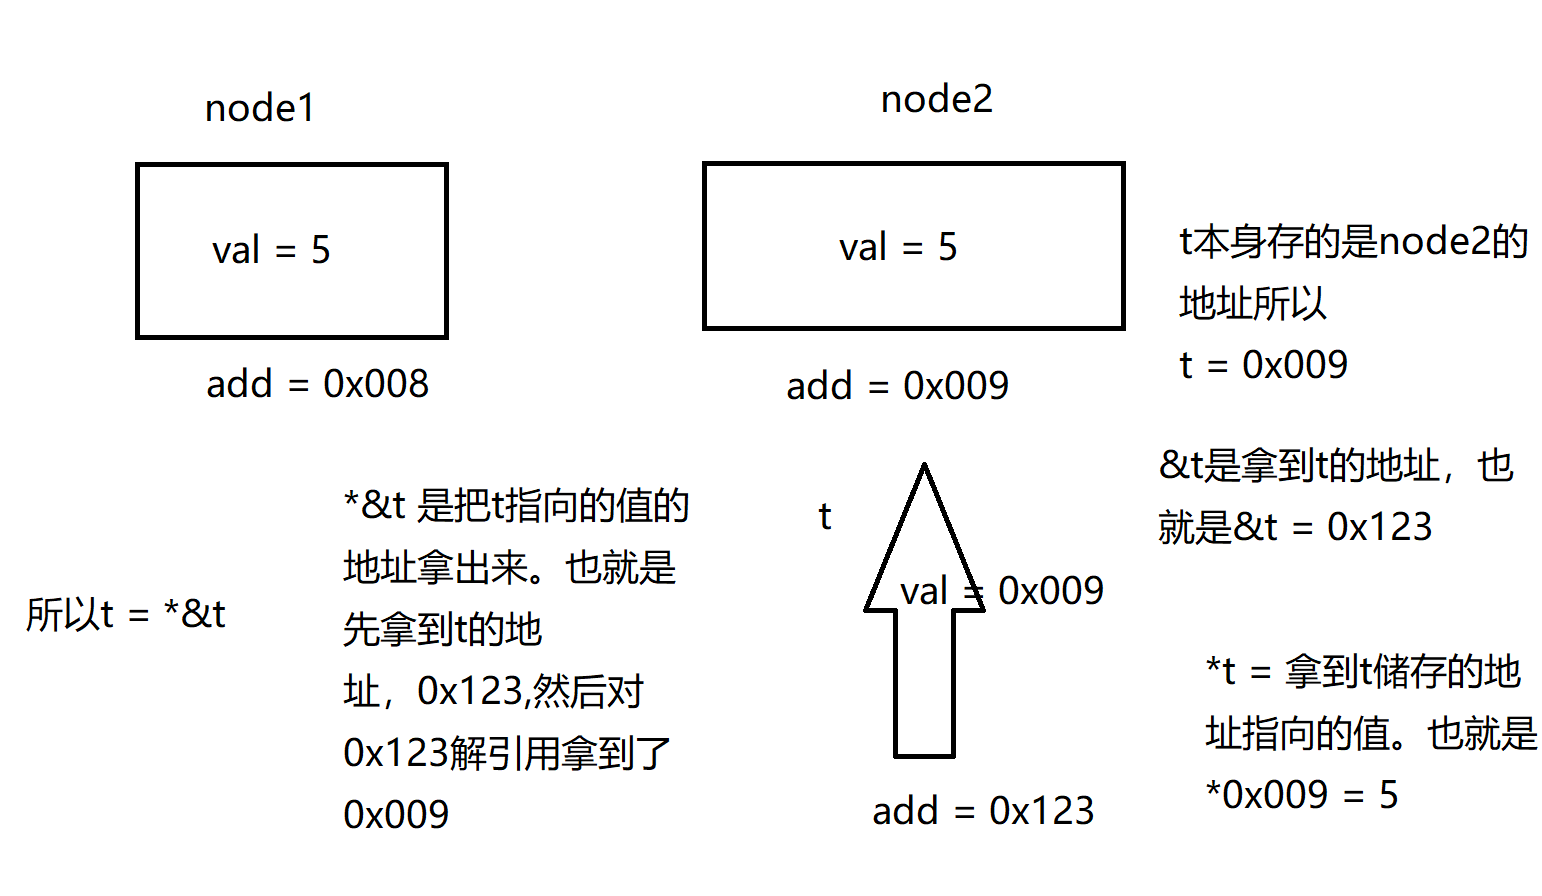
指针加法
指针直接和数字相加:意思是指针当前指向的地址 + 对应指针类型的大小 * 数字。
举例:
int * p;p = (int*)malloc(100); //分配100字节。cout << p<< endl; //打印p储存的地址。也就是指针指向的地址。是内存首地址。此处输出 0x771410auto y = p + 1; //把p指向的地址偏移4位(因为int是4字节)后赋值给y。printf("%#x",y); //打印y储存的地址。也就是指向的地址。此处输出 0x771414也就是说指针直接和数字相加,可以理解为用指针操作数组。加几就是将指针往后移动几位。具体偏移量也就是对应对象的大小*移动位数。
如果想要指定一个具体的偏移量应该怎么办?
首先,可以使用转型将指针转换为对应类型。然后再加数字。
举例:
obj* p;p = (obj*)malloc(sizeof(int) * 10);cout << p<< endl; //打印p储存的地址。也就是指针指向的地址。是内存首地址。 此处输出 0x771410auto x = (char*)p + 1; //把p指向的地址偏移1位后赋值给x。因为char是1位。printf("%#x\n",x); //打印x储存的地址。也就是指向的地址。此处输出 0x771411auto y = (obj*)p + 1; //把p指向的地址偏移8位后赋值给x。因为obj是指针类型。8位。printf("%#x\n",y); //打印y储存的地址。也就是指向的地址。此处输出 0x771418注意:指针类型转换指的是指针转换为对应类型的指针。
此处不要使用cout
auto x = (char*)p的意思是把指针p转为char*类型的指针。不可以auto x = (char)p。 这样做的意思是直接转换成了char。当然,所有的指针都是8字节。记住,指针类型指的是告诉指针应该读取指针指向的地址之后多大的数据。
怎么理解这个操作呢。我们可以想一下。如果 a是int*类型,也就是int类型指针。意思是指针a指向的数据是int,所以需要以4字节为一段进行读取。也就是一次读取四个字节。那么a+1其实是对地址进行了+4操作。因为指针+1的意思是将指针往后移动一个对象位。也就是指针当前指向的地址 + 对应指针类型的大小(此处为4) * 数量(此处为1)。但是我们如果想要对地址+1的话怎么办?我们可以把指针a转换为char*类型也就是char类型指针。而不是int类型指针。这样相当于告诉编译器,指针a指向的数据是char。所以需要以1字节为一段进行读取。也就是一次读取一个字节。所以此时a+1就是对地址进行了+1操作。也就是指针当前指向的地址 + 对应指针类型的大小(此处为1) * 数量(此处为1)。
移动一个对象位也就是移动的偏移量为对象大小。
int digit = 5;int* a = &digit;cout << a << endl;auto x = (char*)a + 1;printf("%#x\n",x);注意!(char*)a + 1往后移动1位的时候,(char*)a的意思是把指针a看成指向char类型的指针(告诉编译器一段是1)。所以(char*)a + 1不是+2,还是+1。因为指针a指向的地址根本没变。仅仅是看成了char类型的指针后+1
成员函数的引用限定符
假如有些情况下,我们想限制某些成员函数只能被左值对象调用,或者只能被右值对象调用,C++11中引入了引用限定符:
- 在函数声明后面加上&符号,表示该方法只能被左值对象调用
- 在函数声明后面加上&&符号,表示该方法只能被右值对象调用
class myobj{ public: // void func(int a, int b){ // cout << "normal func" << endl; // } void func(int a, int b) &{ cout << "lref func" << endl; } void func(int a, int b) &&{ cout << "rref func" << endl; }};
int main(){ int a = 10; int b = 100; myobj obj; obj.func(a, b); //左值对象 输出 lref func move(obj).func(a, b); //通过move把左值变为右值,此时是右值对象 输出rref func return 0;}-
注意事项:
- 引用限定符只能用在成员函数上,而且不能用于
static函数。(this指针原因) - 带有一个
&和不带&的函数只能保留一个。因为他们的含义有二义性。 - 和
const搭配使用的时候,const限定符必须写在引用限定符之前
void func(int a, int b) const &{ //可以cout << "lref func" << endl;}void func(int a, int b) & const{ //不可以cout << "lref func" << endl;} - 引用限定符只能用在成员函数上,而且不能用于
引用限定符和const搭配的注意事项
struct test{ void f() const &{ // 注意const std::cout << "lvalue" << std::endl; } void f() &&{ std::cout << "rvalue" << std::endl; }};int main() { test a; a.f(); // lvalue test{}.f(); // rvalue}一切正常。如果我们去掉右值版本的呢?
struct test{ void f() const &{ // 注意const std::cout << "lvalue" << std::endl; }
};int main() { test a; a.f(); // lvalue test{}.f(); // lvalue}可以通过编译,我们发现临时对象调用的也输出lvalue。
但是如果我们去掉const且去掉右值版本的呢
struct test{ void f() &{ //无const std::cout << "lvalue" << std::endl; } // void f() &&{ // std::cout << "rvalue" << std::endl; // }};int main() { test a; a.f(); test{}.f(); // 错误}因为我们需要把后面的const和引用限定符的组合放在一起看。这一组修饰是限定了this指针,和const一样。
因为const&可以接一切,所以此时临时对象也可以调用这个const&修饰的版本。如果不加const,则不行。