
C++杂记 - 2
关于delete this
能否在类的析构函数中调用delete this?
不能
实验告诉我们,会导致堆栈溢出。原因很简单,delete的本质是“为将被释放的内存调用一个或多个析构函数,然后,释放内存显然,delete this会去调用本对象的析构函数,而析构函数中又调用delete this,形成无限递归,造成堆栈溢出,系统崩溃。
能否在类的其它函数中调用delete this?
可以,但不可以涉及到任何和this指针(成员变量,成员函数,虚函数)相关的东西。一旦涉及到this指针,如操作数据成员,调用虚函数等,就会出现不可预期的问题。
首先,让我们明确几点概念
-
在类对象的内存空间中,只有数据成员和虚表指针,并不包含代码内容。类的成员函数单独放在代码段中
-
在调用成员函数时,隐含传递一个
this指针,让成员函数知道当前是哪个对象在调用它。当 调用delete this时,类对象的内存空间被释放。在delete this之后进行的其他任何函数调用,只要不涉及到this指针的内容,都能够正常运行。一旦涉及到this指针,如操作数据成员,调用虚函数等,就会出现不可预期的问题。 -
delete this释放了类对象的内存空间,但是内存空间却并不是马上被回收到系统中,导致这段内存空间暂时并没有被系统收回。此时这段内存是可以访问的。这时访问数据成员可能是随机数,访问虚表发生指针无效的概率很高,系统崩溃。
什么时候可以?
this指向的实例必须是new出来的,不能是new[] /placement new出来的,也不能是栈上的,也不是全局变量。只能是简单的new出来的。
调用了delete this 的成员函数(下面称为当事函数)返回后,这个实例不可以调用其他任何成员函数(这好理解,涉及到this指针,因为实例不存在了)。这个成员函数应当成为这个实例访问的最后一个函数。
调用了delete this 的成员函数后(从delete this这一行之后开始),这个实例不可以调用任何成员函数和成员变量(这好理解,理由同2)
调用了delete this之后,不得以任何形式提及this,包括比较、打印、类型转换等(因为this已经不存在了)。
换言之,为什么一个指向类成员的指针被delete并置空后依旧可以调用不访问类成员数据的函数?或者是为什么一个类类型的空指针可以访问类内非虚且不访问成员变量的函数?
class myclass{ public: void print(){ cout <<"myclass" << endl; }
int vala = 10;//类成员没有被print函数访问。
};int main(){ myclass* ptr = new myclass(); ptr->print(); //输出myclass delete ptr; ptr = nullptr; ptr->print(); //输出myclass return 0;}我们看到delete后依旧可以调用没有访问类成员的函数。另一个前提是该函数不是虚函数。因为虚函数的调用需要依靠对象的虚函数指针找虚函数表。调用delete资源释放后置空导致和this有关联了。所以报错。
**非虚的类成员函数在编译的时候就已经解决了访问问题。也就是编译成带作用域的全局函数。并添加this形参。**也就是访问非虚而且不访问类成员(变量)的函数是不涉及到this指针的。虽然指针必须要被传入,但是传入参数并不关心当前指针是否有效。只要没有解引用this指针即可。
我们再思考一下。如果上面的例子换成C写是什么样子的?
struct myclass_inC{ int vala = 10;};
void print(myclass_inC* self){ cout <<"myclass" << endl;}
int main(){ struct myclass_inC *myclass_c = NULL; print(myclass_c); //输出my_class return 0;}在深度探索C++对象模型的笔记4.1我们提到:
因为编译器会把每所有的非虚函数(此处不确定是否正确。有的笔记里写的是普通函数,普通成员函数和静态成员函数。书里此处没有提及静态成员函数。)进行处理:
首先是把对象调用的方式改为值调用。也就是在形参的第一个位置放一个this指针(指向对象的指针)做为入参
其次是把函数内对于非静态数据成员的直接操作变成用this指针的操作。
然后是名称重新编译成独特名称(这一步的目的是实现重载。注意,C++重载是依靠名称和参数,C只有名称)
最后是实施NRV优化(如果有)
类成员函数在处理后可以理解为变成了带作用域的全局函数。虚函数也只不过是多了查表的步骤。
我们上面用C写的例子和处理后的非虚类成员函数差不多。此时我们可以看到。尽管我们的类指针是空的。但是它依旧符合函数入参类型。而且我们在函数内并没有通过这个指针访问任何数据成员。所以并不会报错。单纯传递空指针是可以的。所以是可以调用这样的成员函数的。
什么时候需要虚析构函数
是多态基类的时候。多态一定有虚函数。(effective C++ 第七条)
多态实现:通过指针+向上转换(子类转父类)(父类指针指向子类对象) + 虚函数 = 动态绑定 、虚机制
为什么如果析构函数不是虚函数的时候,仅仅执行父类析构函数?
很多人可能会有疑问,问我们知道构造顺序是先父类构造再子类构造,析构顺序是先子类析构再父类析构(仅多态情况)。那么为什么我父类析构不是虚析构的时候仅执行父类析构?难道不应该是仅执行子类析构吗?
因为忘了一点,多态调用必须是虚函数才可以,仅通过父类指针指向子类对象是不会触发虚机制(动态绑定(多态))的。
虽然父类指针可以指向子类,但是其访问范围还是仅仅局限于父类本身有的数据,那些子类的数据,父类指针是无法访问的。
类继承是静态绑定,包含虚函数的情况才是动态绑定
class A{ public: A(){}
};
class B: public A{ public: B(){} int bval = 3;};
class C :public B{ public: C(){} int cval = 4;};
int main(){ A* a = new C; cout << a->bval << endl; //错误。类A没有成员bval}当定义一个指向子类实例的父类指针的时候,内存中实例化了子类,由于子类继承了父类,因此内存中的子类里包含父类的所有成员。但由于申明的是父类指针,因此该指针不能够访问子类的成员,而只能访问父类的成员。然而在父类里可以声明纯虚函数和定义虚函数,使用父类指针访问虚函数或纯虚函数的时候,访问到的是子类里重写的函数。当然,对于虚函数,如果子类里没有对其重写的话,仍然访问到父类里定义的虚函数。
父类指针指向子类对象,仅可访问子类的父类部分。因为不知道子类的内存布局,所以没法访问子类的部分。也就是说,父类指针指向子类对象会发生隐式转换。所以说它还是个父类类型。
多态的时候由于有RTTI所以可以在运行时获知子类类型。
我们提到过,指向虚表的指针_vfptr是子类的父类部分。也就是父类指针可以访问的到子类的指向子类自己的虚表的指针_vfptr。父类访问这个指针后即可访问子类的虚表。(反复强调虚表一个类只有一个)。访问到这个虚表后,就会查表。即访问对应的虚函数。如果子类有重写,那么这个对应的虚表中的函数会在编译期就从父类的覆盖为子类的。这样就可以执行子类的函数了。如果子类没写,那个虚表里面的函数就还是父类的虚函数。
所以,如果没有虚析构,则虚表里没有这一条。那么编译的时候发现不是虚函数,就会静态的将父类的析构函数编译过来。如果有了虚析构,则虚表里会有这一条。于是就会执行正常多态析构动作,先调用子类析构,再调用父类析构。也就是根据指向的对象找到对象的虚表指针,找到对象的虚表再调用对应的虚函数。实现多态。
运算符的重载,参数的数量怎么确定?在类里面和不在类里面?不在类里面声明怎么访问类里面的属性(如果是私有的呢?)
运算符重载可以继续被重载。符合函数重载规则即可。
类模板的运算符重载 在 模板笔记内
运算符重载
class multiple{ public: int vala; int valb; multiple(){} multiple(int x, int y):vala(x), valb(y){} const multiple operator*(const multiple& rhs) const{ multiple temp(this->vala * rhs.vala, this->valb*rhs.valb); return temp; } 注意 乘法我们说是有两个参数即a*b 但是这里现在是成员函数,第一个参数默认是调用对象 即this 所以形参只有一个rhs。 但是我们可以写为非成员函数,这样形参就会有rhs和lhs。 非成员函数在进行隐式类型转换的时候可以实现交换律。参考effectiveC++ 条款24 void getval(){ cout << this->vala<< ", " << this->valb << endl; }
};
const multiple operator*(const multiple& lhs, const multiple& rhs){ multiple temp(lhs.vala * rhs.vala, lhs.valb*rhs.valb); return temp;}
//类外可以这么写。注意const不可修饰非成员函数!!int main(){ multiple t1(5,5); multiple t2(6,4); multiple t3 = t1 * t2; t3.getval();这里t3 = t1 * t2本质上是t3 = t1.operator*(t2)t1是this,t2是rhs,t1.operator*(t2)对应函数返回值}注意 这里重载第三个const的目的是让这个函数成为const函数。目的是可以被const对象调用 这里的例子就是我们避免意外赋值,使重载返回值也是const 因为如果不设置const的话 像是
(t1 * t2) = t3;这种就不会报错。因为t1*t2被当成了一个multiple类型的变量。可以给它赋值。因为它返回一个multiple对象。但是这违背了我们的意愿。所以我们加const来模拟常量确保t1*t2不会被赋值 如果我们这个重载函数不设置const属性(也就是第三个const)的话,我们这样就无法链式调用了。因为我们现在的t1*t2返回的是一个const multiple对象。const对象无法调用非const函数。所以我们的函数必须要const
-
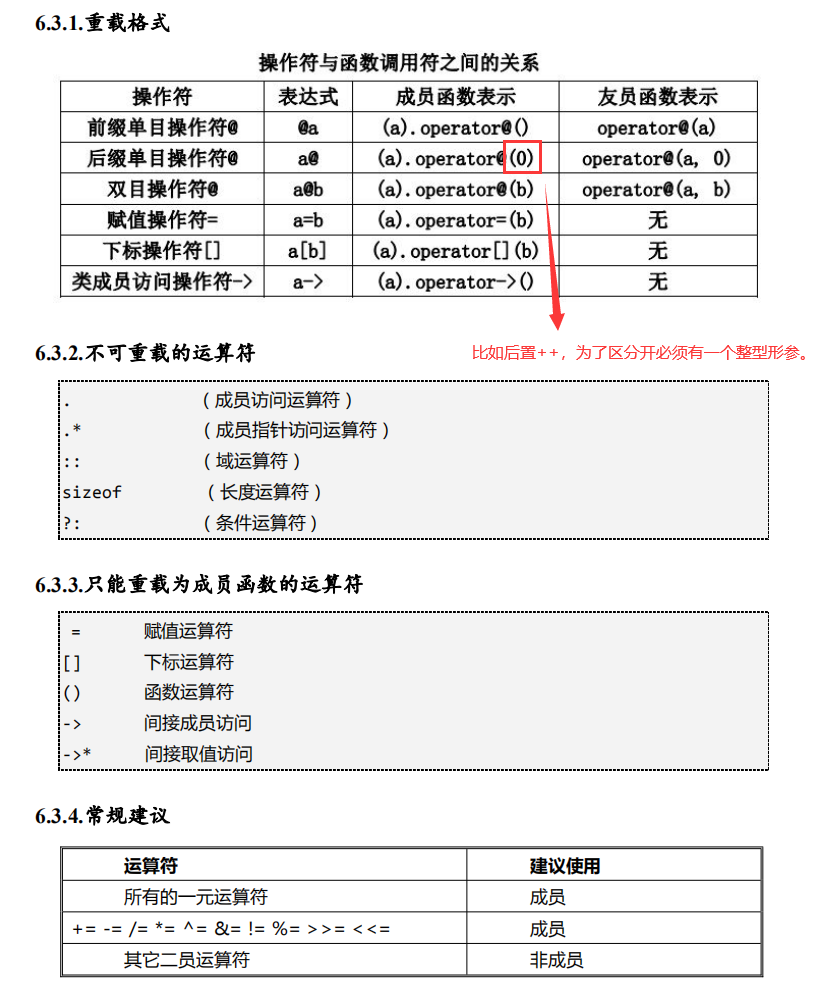
当运算符重载为类的成员函数时,函数的参数个数比原来的操作数要少一个(后置单目运算符除外),这是因为成员函数用this指针隐式地访问了类的一个对象,它充当了运算符函数最左边的操作数。因此:
-
双目运算符重载为类的成员函数时,函数只显式说明一个参数,该形参是运算符的右操作数。
-
前置单目运算符重载为类的成员函数时,不需要显式说明参数,即函数没有形参。
-
后置单目运算符重载为类的成员函数时,函数要带有一个整型形参。
-
调用成员函数运算符的格式如下:
<对象名>.operator <运算符>(<参数>)它等价于<对象名><运算符><参数>
-
-
当运算符重载为类的友元函数时,由于没有隐含的this指针,因此操作数的个数没有变化,所有的操作数都必须通过函数的形参进行传递,函数的参数与操作数自左至右一一对应。调用友元函数运算符的格式如下:
operator<运算符>(<参数1>,<参数2>)它等价于<参数1><运算符><参数2>- 友元函数不属于任何类,但是可以当做类成员函数使用,即访问私有部分。友元函数必须在类内声明。但是可以在类内或类外定义
class multiple{public:multiple(){}multiple(int x, int y):vala(x), valb(y){}friend const multiple operator*(const multiple& lhs, const multiple& rhs); //类内声明void getval(){cout << this->vala<< ", " << this->valb << endl;}private:int vala;int valb;};const multiple operator*(const multiple& lhs, const multiple& rhs){ //类内或类外定义均可。multiple temp(lhs.vala * rhs.vala, lhs.valb*rhs.valb);return temp;}int main(){multiple t1(5,5);multiple t2(6,4);multiple t3 = t1 * t2;t3.getval();} -
在类外,因为不是成员函数所以没有this指针,所以必须要有全部参数。
-
运算符重载写为友元的核心目的是解决两个不同的类的数据访问问题。
- 比如
A和B想要做A+B的时候。因为A不能访问B的私有成员。所以可以把这个A.operator+(const B&)写进B并且声明为friend。
- 比如
注意,类外的运算符重载(此处指的是类的运算符而不是函数调用运算符)的时候,不能单独写一个类。要么在原来的类里面,要么是全局函数
class myclass{ public: int val1; int val2; myclass(){} myclass(int x, int y):val1(x), val2(y){} bool operator()(const myclass& a, const myclass& b){ cout <<"comp" <<endl; return a.val1 < b.val1; }
};
class mycomp{ //这么写是错的。这里的运算符重载被当做了mycomp的运算符重载 public: bool operator<(const myclass& a, const myclass& b){ cout <<"comp11" <<endl; return a.val1 < b.val1; }};bool operator<(const myclass& a, const myclass& b){ cout <<"comp11" <<endl; return a.val1 < b.val1; }
int main(){ set<myclass> myset; //如果重载的是小于号,则写在类内类外都不需要在模板处指定排序类型。 set<myclass, myclass> myset1; //如果重载的是括号也就是调用运算符,则无论写在类内类外都需要在模板处指定排序类型。 myset.insert(myclass(5,10)); myset.insert(myclass(1,10)); myset.insert(myclass(10,10)); return 0;}如果是指针容器呢?
class myclass{ public: int val1; int val2; myclass(){} myclass(int x, int y):val1(x), val2(y){} bool operator()(const myclass& a, const myclass& b) const { cout <<"comp" <<endl; return a.val1 < b.val1; } bool operator()(const myclass* a, const myclass* b){ cout <<"comp112" <<endl; return a->val1 < b->val1; }
};
class mycomp{ public: bool operator()(const myclass* a, const myclass* b){ //写在类外 cout <<"comp11" <<endl; return a->val1 < b->val1; }};int main(){ set<myclass*, myclass> myset; //指针容器,必须使用重载函数调用运算符的方式,并且指定其类型。可以写在类外 set<myclass*, mycomp> myset; //也可以 myset.insert(new myclass(5,10)); myset.insert(new myclass(1,10)); myset.insert(new myclass(10,10)); return 0;}指针容器,必须使用重载函数调用运算符的方式,并且在容器模板处指定其(排序函数所在的)类型。可以写在类外。因为重载普通的运算符 如 <,要求传入的形参必须是类类型。但是指针不是类类型。所以无法写在类外。因为对象指针和对象不是一个东西。对象指针依旧是指针类型。所以他会去指针的类里面找重载,写在类内的重载无法被触发。
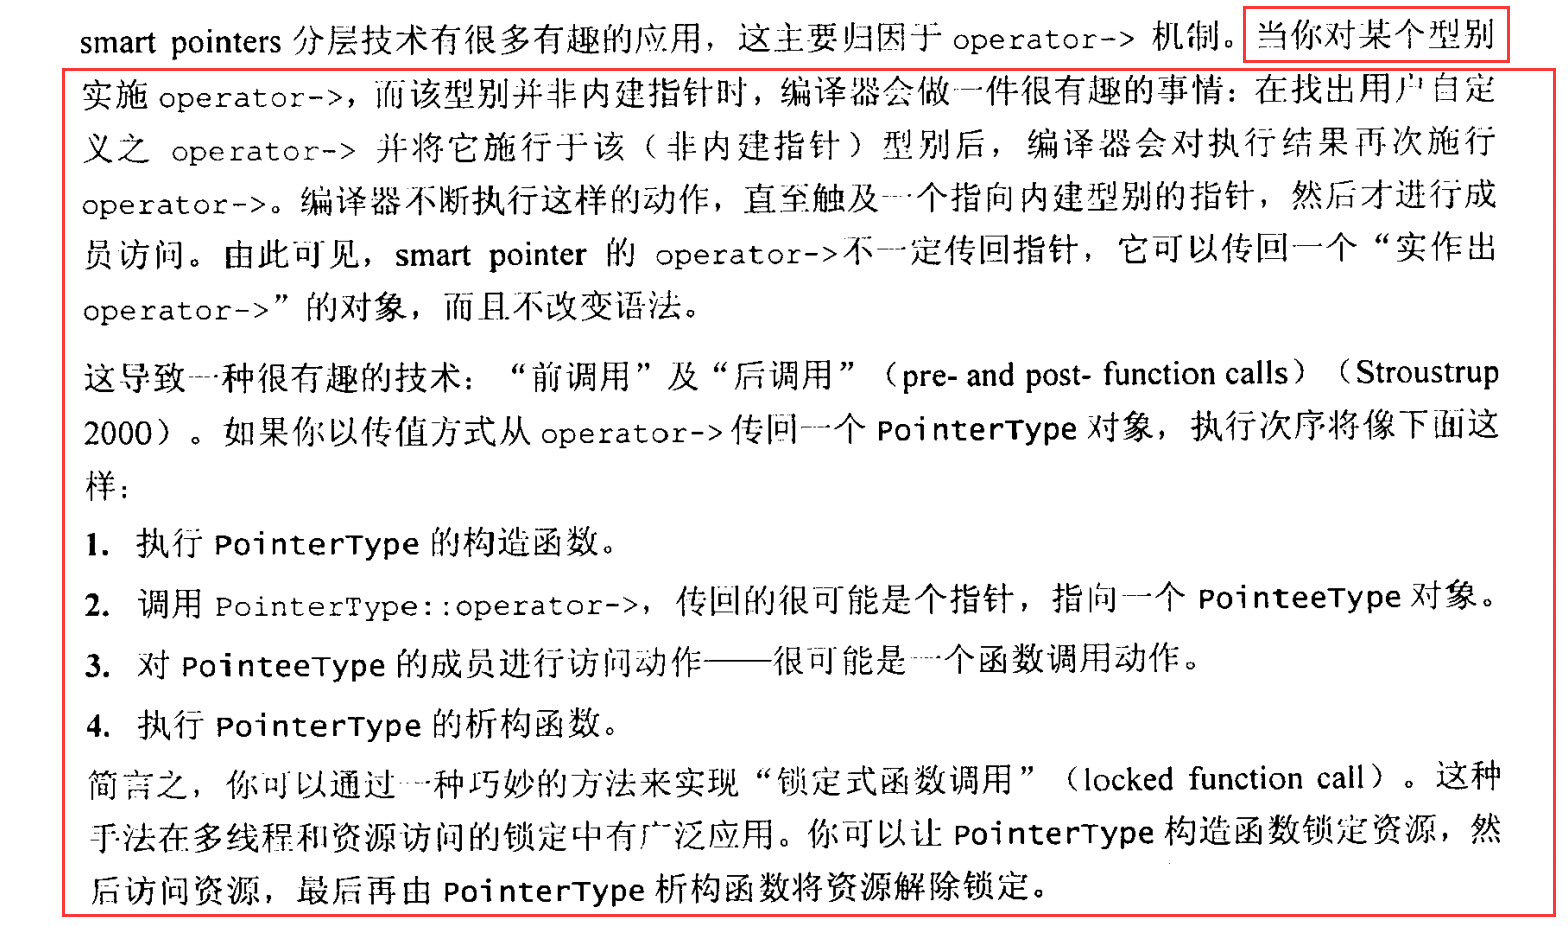
成员访问运算符 -> 重载
类成员访问运算符( -> )可以被重载,它被定义用于为一个类赋予”指针”行为。运算符 -> 必须是一个成员函数。如果使用了 -> 运算符,返回类型必须是指针或者是类的对象。
class obj{ public: int val; obj(int x):val(x){};
void objfunc(){ cout <<"obj" << endl; } void getval(){ cout << val << endl; }};class objhelper{ public: objhelper(){ objptr = new obj(10); //构造函数初始化另一个类的对象 } obj* operator->(){ //注意,返回的是obj类的指针。 return objptr; }
~objhelper(){ delete objptr; //析构函数释放对象。 } obj* objptr; //类内持有一个另一个类的指针。
};int main(){
objhelper helper; helper->objfunc(); //输出obj helper->getval(); //输出10
return 0;}从上面代码我们可以看到,重载类成员访问运算符多半是起到一个帮助作用,帮助我们访问另一个类。
重载成员访问运算符根据调用者的类型不同,有两条作用规则:
- 如果调用者是指针,则按照内置的箭头运算符去处理。表达式等价于
(*调用者).member。首先解引用该指针,然后从所得的对象中获取指定的成员。如果调用者所指的类没有名为member的成员,则编译器报错。 - 如果调用者是一个定义了
operator->()的类对象,则调用者->member等价于调用者.operator->() ->member。其中,如果operator->()的返回结果是一个指针,则转第1步;如果返回结果仍然是一个对象,且该对象本身也重载了operator->(),则重复调用第2步,否则编译器报错。最终,过程要么结束在第一步,要么无限递归,要么报错。 https://blog.csdn.net/friendbkf/article/details/45949661
——来自Modern C++ Design 7.3 P.160
解引用运算符*重载
*是一个一元操作符,作用于指针,获取指针所指单元的内容。当某个类中对*操作符重载时,是将该类对象当做一个指针看待,用*操作符提取指针所指向的内容。它一般有两个版本。一个是普通成员函数返回某个类中的指针的解引用的引用,也就是指针指向的对象的引用。另一个版本是常量成员函数返回const引用。(再次强调返回值不是函数签名。但是修饰成员函数的const是函数签名)
- 为什么要返回引用?如果不返回引用则无法给解引用的对象赋值。比如
*ptr = 200- 不返回引用的话,解引用返回的是一个临时对象,是右值。无法给右值赋值。
//在上面的代码中添加:obj& operator*(){ //返回的是引用!! return *objptr; //返回类内指针的解引用}
const obj& operator*() const{ return *objptr;}取址运算符&重载
罕有使用。参考模板笔记的std::address_of部分和more effective c++的条款30。
解答:
- 在类内,如果是双目运算符就少一个。因为左手部分是this。隐式传递。如果是类外,就正常两个。
- 不在类里面声明,可以正常访问类公有部分。如果需要访问私有部分就需要使用友元函数。
关于为什么赋值运算符必须有返回值并且一般都返回引用
比如在移动赋值或者拷贝赋值中返回的都是引用。
原因主要是性能和为了链式调用。
- 链式调用:
a = b = c;//就是先执行b=c然后执行a = b。等价于a.operator=(b.operator=(c))此时若不返回左值的引用,将会生成临时对象,
因为不能修改标准库,所以重载流插入<<和流提取>>的时候如果在类内则必须用友元的方式。要么就是全局
为什么有时候运算符重载要在类外也写一份?
我们来看下面这个例子
class myInt{ public: int val1; myInt(){} myInt(int x):val1(x){} //这里没有explicit
const myInt operator+(const myInt& rhs){ return myInt(this->val1 + rhs.val1); }
};
const myInt operator+(const myInt& lhs, const myInt& rhs){ //这里类外要有一份 return myInt(lhs.val1 + rhs.val1);}
int main(){ myInt a(10); myInt b(20);
myInt c = a + b;
myInt d = a + 10; //这个等于 myInt d = a + myInt(10); 因为有转换构造所以可以。
myInt e = 10 + a; //这等于 myInt e = myInt(10) + a; 如果不写类外,这个不行。 cout << c.val1 << endl; cout << d.val1 << endl; return 0;}- 我们这里有隐式类型转换。因为有单参的转换构造函数。所以如果构造函数用explicit修饰了就不行了,就要显式调用构造函数生成临时对象了。
- 其次,如果不写类外实现,如
10+a这样的就不能调用。因为a+10是a.operator+(10),但是没有10.operator+(a)。所以这时候就需要有一个全局的接受两个参数的operator+。这两个可以并存。所以现在是operator+(10, a)。是可以的。 - 所以一般来说,当前面的调用者是基本类型的时候,就需要写一个全局的操作符重载。
千万不要重载 ||, && 和 ,
因为他们的表现方式和内建版本不同。
- 布尔逻辑运算符的重载版本无法实现短路求值,并且不会令左侧操作数的求值按照顺序早于右侧操作数。
- 逗号运算符的重载版本不会令左侧操作数的求值按照顺序早于右侧操作数。
关于逗号运算符这里有一个非常特殊的点。在文档中提到了:
因为此运算符可能被重载,所以泛型库都用
a,void(),b这种表达式取代a,b
在stackoverflow也有同样的疑惑,为什么要这么做?
我们拆开看。在a有自己的逗号运算符的时候,a,void()会变成a.operator,(void())。但是因为void()表达式会返回一个void类型, 但是void不是有效类型(不完整类型),所以a无论是任何类型都不可能有一个自己的逗号运算符重载的操作数类型是void。同时重载operator,必须提供一个参数(右操作数)。 所以这里一定会用到内置的版本。在运算完后,结果会变成void,因为第一个表达式的运算结果在求值后会被丢弃,只会保留第二个的结果。现在是void,b了。左侧void必然只会用内置类型的逗号表达式。所以这样做是有效的。
剩下的请参照杂记4的序列点部分和more effective c++ 条款7
运算符重载的语义,个人感悟
运算符重载就是函数调用,一定要思考语义。
首先关于函数内部要做什么,要不要修改左侧操作数?
用加法举例子,如果你想要达到执行a+500能直接把a的数也改变,那么可以直接在加法重载内改变a的值。如果你不允许链式调用,则没必要有返回值。这完全合法。
包括拷贝赋值运算符也不是强制返回T&的。如果你不想链式调用,完全可以写成这样
struct myclass{ int val = 0; myclass(int x):val(x){}; myclass operator+(const myclass& rhs){ return myclass(val + rhs.val); } void operator=(const myclass& rhs){ val = rhs.val; cout <<"copy assignment" << endl; }};int main(){ myclass obj(200); myclass obj2(300); cout << obj2.val << endl; obj2 = obj; cout << obj2.val << endl;}a.operator=(b)压根不是返回值作用于a。是先修改了a然后同时返回自己而已。目的就是链式调用。所以a = b这个表达式,返回值压根就没用上。
所以核心就是要思考某个特定的运算符重载是否符合直观性的语义。也就是一般性的使用方式。
关于mutable
很多人多mutable有错误认知。不仅仅是因为用得少,而且是有模糊概念。
mutable是修饰成员变量所用。他的作用是让这个成员变量在任何时候都可以被修改,无论是:
- 做为参数传入形参带有
const的函数 - 做为参数传入被
const修饰的(成员)函数 - 在被
const修饰的(成员)函数中 - 被
const修饰的变量中
首先举反例:
mutable int a; //这是啥?const mutable int a; //这又是啥?下面,正式开始举例:
class multiple{ public: multiple(){} multiple(int x, int y):vala(x), valb(y){}
mutable int vala; int valb;
};我们拿到了类的定义。我们开始举例
mutable const int vala; //不可以 这啥玩意const mutable int vala; //不可以 这啥玩意为了简便起见,我们只举成员函数的例子
class multiple{ public: multiple(){} multiple(int x, int y):vala(x), valb(y){} //------------------------------------- 被const修饰的成员函数 void test1(multiple& x) const{ vala = x.vala; x.vala = vala; } //-------------------------------------被const修饰的函数形参 void test2(const multiple& x){ vala = x.vala; x.vala = vala; } //-------------------------------------被const修饰的成员函数 和 被const修饰的函数形参 void test3(const multiple& x) const{ vala = x.vala; x.vala = vala; } //------------------------------------- mutable int vala; int valb;};以上三个函数代表了三个例子。我们发现被无论是在被const修饰的成员函数中 还是 被当成参数传入被const修饰的函数形参中,我们都可以修改mutable修饰的变量。
还有第四个例子
const multiple t1(3,3);t1.valb = 3; //不可以t1.vala = 3; //可以 因为被mutable修饰四种cast显式(强制)类型转换表达式(运算符/关键字/特殊运算符),都不改变对象本身。
-
**四种cast强制类型转换是表达式(特殊运算符)。**他只是长得像类模板但是不是。
- 这类运算符还包括如
new,delete,sizeof,typeid,noexcept等。
- 这类运算符还包括如
-
四种cast强制类型转换对转换对象没有任何影响。他只是生成一个你想转换的类型的临时变量。
- 无论何种类型转换都是创建对应类型的临时”对象”。
- 此处可能不严谨。如果转换的类型是引用,则不会创建“对象”因为引用不是对象。我们可以说cast总是会创建一个临时的“东西”
-
强制类型转换并不改变原对象类型,只是通过原对象生成新的对象。
-
C风格类型转换是运算符。优先级是第三级。C++风格类型转换也是运算符。优先级是第二级。
-
通过如构造函数的方式进行显式类型转换,我们称之为函数风格转换functional-style cast。
- 比如
新类型 (表达式) - C风格的不要搞混。C风格的是
(新类型) 表达式 - C风格和函数风格没什么差别 ---- effective C++ 条款27
- 比如
-
函数指针有类型,所以可以进行类型转换
记住了,所有类型转换表达式后面的圆括号里面塞的也是表达式!!!
int* p = new int(20);void* pp = static_cast<void*>(p); //p是表达式。void* pp = static_cast<void*>(int*);//这是啥玩意?int*是类型,不是表达式例子:
float ss = 10.12345;cout << ss << endl; //10.12345cout << static_cast<int>(ss) << endl; //10cout << ss <<endl; //10.12345由此可见,强制类型转换会生成一个转换类型的临时变量。并不改变原来的对象。
https://zh.cppreference.com/w/cpp/language/explicit_cast
强制类型转换可以进行引用类型的转换
其实就是通过原对象生成一个原对象的引用。这个操作合法。
例子:
float ss = 10.12345;float& dd = static_cast<float&>(ss); //生成一个ss的引用。也就是通过ss生成一个新的float&类型的对象。cout << dd <<endl; //10.1235dd = 9.324;cout << dd << endl; //9.324cout << ss << endl; //9.324reinterpret_cast简单介绍
需要记住的有两点:
reinterpret_cast表达式不会编译成任何 CPU 指令(除非在整数和指针间转换,或在指针表示依赖它的类型的不明架构上)。它纯粹是一个编译时指令,指示编译器将 表达式 视为如同具有 新类型 类型一样处理。reinterpret_cast不能去除CV。去除CV需要使用const_cast
关于static_cast 和 const_cast之间的区别
static_cast
static_cast <type-id> (expression)将expression转换为type-id类型,主要用于非多态类型之间的转换,不提供运行时的检查来确保转换的安全性。主要在以下几种场合中使用:
- 用于类层次结构中,父类和子类之间指针和引用的转换;
- 当进行上行转换,也就是把子类的指针或引用转换成父类表示,这种转换是安全的;
- 当进行下行转换,也就是把父类的指针或引用转换成子类表示,这种转换是不安全的,也需要程序员来保证;
- 用于基本数据类型之间的转换,如把
int转换成char,把int转换成enum等等,这种转换的安全性需要程序员来保证;- static_cast可以转换对象。
- 转换对象的前提是:
- 基础类型之间:提到过比如
int换成char - **有继承关系之间的对象。且由于是对象,只能进行上行转换。也就是子类对象转为父类对象。父类对象转为子类对象不可能的。**因为只能往小切,不能往大扩。多出来的内存空间不知道用来作什么。
- 可被转换(如拥有转换(构造)函数)的对象
- 基础类型之间:提到过比如
- 转换对象的前提是:
- static_cast可以转换对象。
- 把void指针转换成目标类型的指针,是及其不安全的;
- 将一个左值转换为右值引用,这是允许的。(std::move的实现)。对于操作右值引用的代码来说,将一个右值引用绑定到一个左值的特性允许它们截断左值。有时候这种截断是安全的
- static_cast不能移除掉表达式的const、volatile和__unaligned属性。但是可以添加。
dynamic_cast
dynamic_cast <type-id> (expression)将expression转换为type-id类型
-
dynamic_cast转换仅适用于指针或引用。
-
*type-id必须是类的指针、类的引用或者是void ;如果type-id是指针类型,那么expression也必须是一个指针;如果type-id是一个引用,那么expression也必须是一个引用。
-
必须满足多态条件(有虚函数,因为依赖RTTI)
-
不能移除CV限定。
dynamic_cast主要用于类层次间的上行转换和下行转换,还可以用于类之间的交叉转换。在类层次间进行上行转换时,dynamic_cast和static_cast的效果是一样的;**在进行下行转换时,dynamic_cast具有类型检查的功能,比static_cast更安全。在多态类型之间的转换主要使用dynamic_cast,因为类型提供了运行时信息。**就像我在虚表那一章节说的。虚表头还有一块东西就是RTTI,表明了当前类的类型信息。
一般来说,dynamic_cast 用于下行转换的时候,只能用于有虚函数表的类。因为dynamic_cast依赖于RTTI的type_info,然而这个信息储存在虚函数表的头部。
这个dynamic_cast是怎么用的呢?我们父类指针指向子类对象的时候,限制了指针仅可以读取子类对象的父类部分。我们进行dynamic_cast的时候,会使用RTTI信息。这个信息是储存在虚函数表的头部。也就是编译器找到了虚函数表指针(子类对象的虚函数表指针一定指向自己的虚函数表,所以RTTI信息类型也是子类),然后问RTTI:”这人想要让我转换成子类,也就是多读点儿子类的东西,你帮我看看我指向的对象到底是不是子类,多读的那部分被正确初始化了没有?合法不合法?“。RTTI看了一眼回答:”哦,你指向的部分实际类型确实是一个子类的类型,因为他new的时候new的是一个子类对象。我检查了,都初始化了,也合法,那你就多读点儿吧“。这就是dynamic_cast和RTTI的联系。
有一个实际问题,当我们需要判断该指针实际指向的类型的时候,假如我们加了一堆ifelse然后用dynamic cast判断,这非常慢,尤其是继承非常复杂的时候,效率非常低。需要注意。所以很多引擎的RTTI是自己的。
dynamic_cast 在传入引用和指针的时候不一样。
- 使用指针的时候,如果可以转换则传回真正的地址。
- 如果不可以则会返回0(
nullptr)表示转换失败
但是使用引用的时候却不可以这样。首先,引用不能像指针那样设置为0。设置为0代表着有一个临时对象产生出来,然后这个临时对象初始值为0,然后这个引用成为了这个临时对象的别名。(右值相关,对吧。)
- 所以使用引用的时候,如果可以转换则会把对象引用至正确的子类。
- 但是如果失败,由于引用不可以传0,则会抛出一个
bad_cast_exception
dynamic_cast 的向上转换是编译时还是运行时
向上转换是编译时。
- 但是在某些stack overflow 的回答中侧面展示了另一种可能。也就是这依赖于实现
- https://stackoverflow.com/questions/7687041/dynamic-cast-with-rtti-disabled
- RTTI是可以关闭的,但是关闭之后dynamic_cast会对一些转换标记为非法。这些标记通常会被用于那些向下转换。
- 也就是说使用dynamic_cast向上转换的时候,转换关系在编译时是已知的。那么这个时候dynamic_cast不会依赖于RTTI,也就是会被提前到编译时。
- include社群的回答是这样:
- 在使用dynamic_cast进行非向下转换(也就是向上转换和同类型转换的时候),不涉及RTTI,也就是不涉及运行时。编译时就可以做到。
- 进行向下转换的时候,必然RTTI也就是必然运行时。
- 因为upcast是自动的,不需要任何的显式cast。
- 来自CPP开发者
dynamic_cast最终会调用libstdc++中的__dynamic_cast函数。- 如果是向上转换,编译时即可完成。
- 如果是向下转换,需要运行时才可以。
关于更多dynamic_cast,虚继承,多重虚继承和dynamic_cast的设计,看这里
关于const_cast
给一般读者:
- 常量指针(指向常量的指针)被转化成非常量的指针(或逆向),并且仍然指向原来的对象;
- 常量引用被转换成非常量的引用(或逆向),并且仍然指向原来的对象;
- 不改变原指针/引用的常量状态。
- 不可进行类型更改,只能进行CV操作。
我们来看代码:
using namespace std;class multiple{ public: multiple():valc(0){} multiple(int x, int y, int z):vala(x), valb(y), valc(z){} int vala; int valb; const int valc;
};
int main(){ multiple p(1,3,5); const multiple* const_ptr = &p; //指向常量的指针 //--------------------------------------------------------------------- const_ptr = const_cast<multiple*> (const_ptr); //进行const cast const_ptr->vala = 100; //不可以, 必须要赋值给新的指针。 const_cast<multiple*> (const_ptr)->vala = 100; //可以
//--------------------------------------------------------------------- multiple* ptr = const_cast<multiple*> (const_ptr); //赋值给新指针 ptr->vala = 10; //可以 ptr->valc = 100; //不可以。因为valc是常量。}具体使用场景
1. 一个函数的形参不是const指针/引用,并且编程者事先已经知道在这个函数中不会对参数进行修改,但需要传递的实参却是已经定义好的const对象。为了成功调用这个函数,就需要利用到const_cast在实参传递前对其进行处理,从而使函数能够成功接收这个实参
代码:
void Function(int &val){ cout<<val<<endl;}int main(){ const int value=21; Function(value); //不可以 Function(const_cast<int&>(value)); //转换为常量引用,可以 return 0;}2. 如果我们定义了一个非const的变量,却使用了一个指向const对象的指针来指向它,而在程序的某处希望改变这个变量时发现只有指针可用,此时就可以const_cast进行处理
int main(){ int value=26; const int* const_ptr=&value; *const_ptr=3; //不可以 int* ptr=const_cast<int*>(const_ptr); //转换为非常量指针。可以 *ptr=3; return 0;}- 使用const_cast去除const限定的目的绝对不是为了修改它的内容,只是出于无奈
给能思考的读者。因为这里我还没有完全弄明白,可能存在错误
原因是全局const在静态区。不能间接修改。因为这个内存段所属的页面的权限是只读的,硬写一定会段错误。而局部const在栈上。这个内存段所属的页面是可读也可写的,所以可以间接修改。但是修改任何标记为const的变量都是未定义行为。
我们直接看代码
class multiple{ public: multiple():valc(0){} multiple(int x, int y, int z):vala(x), valb(y), valc(z){} int vala; int valb; const int valc;
};int main(){ const multiple np(2,4,6); //常量对象 multiple ucnp = const_cast<multiple&>(np); //这里下面会解释 ucnp.vala = 10; //--------------------------------------------------------- cout << ucnp.vala<< endl; //输出10 cout << ucnp.valb<< endl; //输出4 cout << ucnp.valc<< endl; //输出6 //--------------------------------------------------------- cout << np.vala<< endl; //输出2 cout << np.valb<< endl; //输出4 cout << np.valc<< endl; //输出6}这里面我们进行const_cast的时候返回值并没有使用引用来接受。这是可以的。这里会产生一个临时变量做为中间值传给了结果值
有没有注意到问题,我们的np不是引用,是个对象。可能无法直观感受,我们接着看
这句话不知道对不对。来自:https://www.cnblogs.com/dracohan/p/3417842.html
下面有更狠的。
我们把ucnp换成引用。看看结果如何
int main(){ const multiple np(2,4,6); //常量对象 multiple& ucnp = const_cast<multiple&>(np); //注意这里 ucnp.vala = 10; //--------------------------------------------------------- cout << ucnp.vala<< endl; //输出10 cout << ucnp.valb<< endl; //输出4 cout << ucnp.valc<< endl; //输出6 //--------------------------------------------------------- cout << np.vala<< endl; //输出10 cout << np.valb<< endl; //输出4 cout << np.valc<< endl; //输出6}好像没什么问题啊?确实是这样的嘛。常量引用转换成非常量引用,有啥问题?
你再仔细看一眼。np是什么?是对象啊。这是个常量对象啊,我们修改了常量对象啊!
我们可以来一个更明显的例子:
int main{
multiple p(1,3,5); cout << p.valc << endl; //输出5 int& wtf = const_cast<int&>(p.valc); //修改常量。 wtf = 1000; cout << p.valc << endl; //输出1000 return 0;}我们的valc是一个const int。但是这里我们修改了一个对象里的常量。
以上操作,编译器没有任何警告。但是这应该是一个未定义行为。需要避免修改任何已经声明为常量的对象。const_cast只能正确转换顶层(引用,指针)的常量性质,但是无法正确转换底层(引用的本体,指针指向的对象)的常量性质。强行转换会导致未定义行为。
const_cast的一些错误使用可能不会让编译器报错。但是它不会做你想要让它做的,
const_cast的正确使用方式
假设有如下代码
class my_array{ public: const char& operator[](size_t offset) const{ return buffer[offset] } char& operator[](size_t offset){ return const_cast<char&>(const_cast<const my_array&>(*this)[offset]) } private: char buffer[10];};int main(){ const my_array c_arr; my_array arr; return 0;}- 这种情况下,与其写两个函数,不如让非
const的调用const。具体过程如下。 - 如果是
const对象调用,则正确匹配至const成员函数。 - 如果是非
const对象调用,则正确匹配至非const成员函数。在非const成员函数内,我们先把自己cast成const引用,必须是引用否则就新建对象了。然后这时候调用operator[]会匹配到const的成员函数。这时候返回的是const char&。然后再把这个带const的cast成char&。这样做是安全的,因为传入的数组本来就不是const的,可以修改。我们只是把自己cast成了const引用。但是本身还是非const。
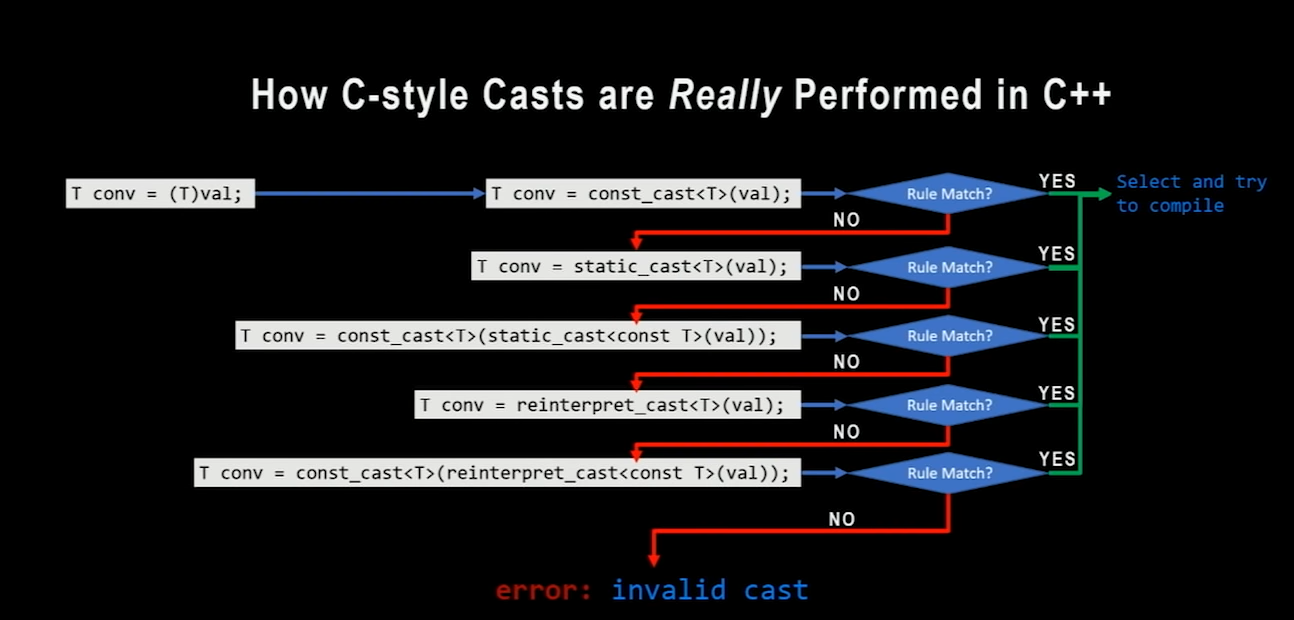
C风格cast的过程
来自这里
explicit 和 隐式类型转换 和 转换构造函数
叽叽歪歪一大堆没意思。先看一个关键知识点
当一个构造函数只有一个参数,而且该参数又不是本类的const引用时(这里存在不同说法。一说是只要不是本类类型即可),这种构造函数称为转换构造函数,即转换构造函数为单参构造函数的一种,又是类型转换函数的一种。这里的只有一个参数可以拆分为,只有一个形参,或,形参中只有一个没有默认值。
- 注意了。这里提到的是转换构造函数。下面提到的
operator开头的叫用户定义转换函数。 - c++11后单参的限制被放宽了。只要不被explicit修饰的构造函数都可以叫做转换构造函数。(也就是多个参数也可以)
- 隐式声明的及用户定义的非显式复制构造函数与移动构造函数也是转换构造函数。
explicit只能限制住拷贝初始化,并不能限制直接初始化(杂记1拷贝初始化那段里面有原因)。我们下面提到了四种隐式转换的条件。
啥意思?
只有一个形参
class A{public: A(int i):a(i){} //单参构造函数 int getValue() { return a; };private: int a;};int main(){ A a = 10; //case1 A a(10); //case2 注意这是直接初始化,不会受到explicit限制。 A a; //case3 a = 10; return 0;}case1中,我们没有临时对象。而是直接把10作为参数传递给类型转换构造函数。使用了拷贝初始化(先调用默认构造,再调用拷贝构造)这虽然使用了”=“,但是实际上我们在创建新对象。创建新对象的时候一律是拷贝构造而不是拷贝赋值。因为对象还不存在
case2中,我们没有临时对象,使用直接初始化调用默认构造。
case3中,我们有临时对象。编译器执行 a = 10;的时候相当于先使用 A(10);在栈中创建了一个临时对象。然后再调用对象a的拷贝赋值 a(10) 给a初始化(因为对象a已经存在)。然后临时对象销毁。这就是编译器做的隐式转换工作。
也就是说,如果我们使用了explicit,这里将会变成:
A a;a = A(10); //显式调用构造函数 禁止隐式转换多个形参但是只有一个没有默认值
class A{public: A(int i, int j = 5):a(i),b(j){} //单参构造函数 int getValue() { return a; };private: int a; int b;};原理和上面一样。但是有一个知识点:函数默认值假如第N个参数有,那么N后面的参数必须全都有。
发生隐式转换的条件
注意!四种情况会发生隐式转换:
- 混合类型的算数运算表达式。
int a = 3;double b = 4.5;a + b; // a将会被自动转换为double类型,转换的结果和b进行加法操作- 不同类型的赋值操作。(这里包含拷贝初始化)
int a = true ; ( bool 类型被转换为 int 类型)int * ptr = null;(null被转换为 int *类型)- 函数参数传值
void func(double a);func(1); // 1被隐式的转换为double类型1.0- 函数返回值。(此处例子)
double add( int a, int b){ return a + b;} //运算的结果会被隐式的转换为double类型返回针对第四种我们举个例子。看代码:
class tmp{ public: string _text; tmp(string c): _text(c) {} //单参构造,可以看做转换构造
};class test{ public: string _text; test(string a): _text(a){} //单参构造,可以看做转换构造 test(tmp s): _text(s._text){} //单参构造,可以看做转换构造。此处入参是tmp类型,return一个test类型,可以看成tmp可以转为test};class twonumber{ public: test ret(){ test(tmp("cde")); return(tmp("abc")); //此处返回的对象是一个tmp,但是函数头的返回类型却是test。可以运行。这里使用了构造函数的隐式转换。使用了临时对象 return(test(tmp("abc"))); //如果设置了explicit,则需要这样进行显式转换。 } //!由于return语句内是隐式转换,所以对应的构造函数如果有explicit关键字则无法进行隐式转换。即便这里看起来像拷贝初始化。
};int main(){ twonumber ttt; test rrr = ttt.ret(); cout << rrr._text << endl; return 0;}隐式类型转换都会创建临时对象
我们在上面看到了,为什么下面的类型转换是OK的?
test ret(){ test(tmp("cde")); return(tmp("abc"));}因为虽然我们要返回test对象,而且我们实际把一个tmp对象塞进去了,但是test类有一个使用tmp对象为形参的构造函数。编译器此时会调用test类的形参为tmp的构造函数,生成一个临时对象。然后再把这个test类型的临时对象return出去(赋值回去)。
这里比较特殊是做为函数返回值了。可能有NRV优化。但是正常的隐式转换就是这个样子,调用对应类型和入参的构造函数构造临时对象,再赋值。
显式类型转换无非就是手动调用了构造函数。
为什么引用传参不会发生隐式类型转换从而产生临时对象?
假设我们有一个函数
void changesomething(string& s){ //改变一些东西}如果此时有隐式类型转换,则一定会有临时对象。那么我们修改的其实是那个临时对象。传入的那个字符串并没有被修改。所以这会引起错误。
所以c++禁止为非常量引用产生临时对象,而常量引用没所谓。以为常量引用保证了对象不会被修改。注意这个和拷贝没啥关系
说到底,我们啥时候想禁用呢?
- 当类中同时存在“non-explicit-one-argument 构造函数和类型转换函数的时候。有可能产生二义性。所以需要对“non-explicit-one-argument构造函数前加explicit防止编译器隐式自动转换类型
- explicit可以理解为,在拷贝初始化的时候,尝试去对等号右侧对象进行一个隐式转换以满足等号左侧的类型要求。但是explicit会让隐式转换序列中,忽略掉explicit标注的类型转换函数(转换构造函数或用户定义的类型转换函数)。所以他会找不到对应的转换方式所以约等于禁止隐式转换了。
- 也就是说,如果加了explicit,使用拷贝初始化的时候我们就必须用显式类型转换。比如C风格cast或c++风格的cast或显式调用构造函数进行直接初始化。
- 显式地调用构造函数进行直接初始化实际上是显式类型转换的一种。
再次重申,explicit只限制拷贝初始化,不限制直接初始化。而且对象类型为本类类型的时候不限制。因为如果是本类类型不涉及任何类型转换。
A a(5); //可以。直接初始化A a = 5; //不可以,拷贝初始化。A b(a); //可以。对象类型为本类,不属于类型转换。不发生隐式转换。A b = a; //可以。对象类型为本类,不属于类型转换。不发生隐式转换。- 可以进行多种构造函数的搭配自由使用
class obj{ public: obj(){}; obj(int a):val1(a){}; explicit obj(int a, int b):val1(a), val2(b){}; int val1; int val2;};
int main(){ obj t1; //可以,有默认构造函数 obj t2(10,20); //可以,explicit只能限制拷贝初始化。这里是直接初始化。 obj t3 = (10,20);//不可以,禁止隐式类型转换。 obj t4 = obj(10,20);//可以,显式类型转换。 obj t5 = (20); //可以。因为这个构造函数没有被explicit修饰
vector<obj> myvec{obj(10,20), (20)}; //可以这样搭配使用。
return 0;}所以explicit卡在哪儿了?卡在隐式类型转换所需的构造等号右侧的临时对象了。
我们上面提到了如果其他对象的类型不是目标类型或从目标类型派生,那就需要找能转换的转换序列(包括转换构造函数和用户定义转换函数)。说人话就是我们要使用等号右面的这个东西,构建出一个等号左边的类型的临时对象。但是在这个临时对象的构造中(转换序列的查找中),忽略掉所有带explicit声明符的可用函数。这时候自然就防止了隐式类型转换。因为一般情况下,我们期望的是提供一系列参数,然后进行对象构造。按理说直接初始化提供的参数和拷贝初始化提供的参数是相同的。因为在拷贝初始化临时对象后,会调用拷贝构造或移动构造来对左侧的对象进行初始化。
但是,它有时候想的和你不太一样。比如
explicit myobj(int x):val(new int(x)){ //explicit cout <<"const" << endl;}myobj(int x, int y = 20):val(new int(x)){ //带默认值 cout <<"const with default value" << endl;}myobj b = 10; //可以
/*const with default valuemvdestdest*/- 这个时候为啥可以呢?因为尽管通过
10来构造myobj临时对象的时候,第一个匹配的构造函数是explicit不能用,但是第二个可以用。所以此时依旧可以拷贝初始化。
对于类来说,直接在类型后面加上括号,就是调用构造函数
类型后面+名字再+括号只不过是给了个名字而已。
class p{ public: int a; int b; p(){} p(int x, int y):a(x),b(y){}
};int main(){ p t1; t1.a(5); //这是啥东西?构造函数怎么能构造出来对象的变量而不是对象本身呢?怎么可以通过构造函数给变量赋值? t1.a = 5;//对了
}类型转换函数 (用户定义转换函数)
我们提到过:当一个构造函数只有一个参数,而且该参数又不是本类的const引用时(这里存在不同说法。一说是只要不是本类类型即可),这种构造函数称为转换构造函数,即转换构造函数为单参构造函数的一种,又是类型转换函数的一种。
-
所以类型转函数还有一个单独的函数。也就是
operator type()。他的作用是把一个类类型转换成另一个类类型。也叫类型转换函数或用户定义转换函数。注意和转换构造函数区别开。 -
它的目的是让我们的这个类对象可以转换成满足目标类对象的构造函数的样子。
-
注意,用户定义转换函数依旧可以被
explicit修饰。具体作用和构造函数一致。- 如果用户定义转换函数被
explicit修饰,则该用户定义转换函数不是用户定义转换,不被隐式类型转换考虑 - 使用
explicit修饰用户定义转换函数后,就需要使用如static_cast的形式显式触发类型转换。
- 如果用户定义转换函数被
-
一般来说,转换构造函数的目的是把其他类转换为本类。用户定义转换函数的目的是把本类转换为其他类。
基础语法:
class 源类{ 源类(目标类){ //这种转换构造函数的目的是把目标类转为源类。也就是把其他类转为本类 } operator 目标类(){ //这种用户定义转换函数的目的是把源类转为目标类。也就是把本类转为其他类。 目标类 obj; //根据需要进行从源类型到目标类型的转换
return obj; }}class Type{
operator OtherType(){
OtherType obj; //....
return obj; }}此处,我们的目的是把Type转换为OtherType
所以可以有这样的类型转换调用(隐式):
int main(){ OtherType obj = Type(); return 0;}来看进阶例子。此处是把other转换为test
class test{ public:
int val_1; int val_2; test(int x = 4, int y = 5):val_1(x), val_2(y){}};
class other{ public: int val1; int val2; other(int x = 10, int y = 100):val1(x), val2(y){} operator test(){ //用来把other转换为test。 test obj; obj.val_1 = val1; obj.val_2 = val2; return obj; }};
int main(){ other O; test T; cout << T.val_1 << endl; T = O; //other转化为test T = (test)O; //显式
test obj1(other()); //不行,语法不对,会被当成函数。必须要用花括号 test obj1(other{}); // OK 因为有类型转换。
cout << T.val_1 << endl; return 0;}**类型转换函数会为我们提供隐式类型转换。所以会产生临时对象。**其实代码中就体现出来了。因为我们单独创建了一个对象。
注意这里我们test类没有写自己的拷贝构造。所以编译器默认生成了。当我们执行test obj1(other{});的时候,编译器先会想办法把other弄成满足test构造函数的要求的类型。这里我们test没有对应的构造函数,所以会开始查看other的转换函数。转换函数内部先生成test类对象(构造),然后拷贝出来(拷贝构造)然后再使用拷贝出来的test临时对象去调用拷贝构造去构造obj1(第二次拷贝构造)。[没有编译器优化的时候]
- 用户定义转换函数内并不一定需要返回一个目标类对象。也可以是返回一个可以构造目标类对象的参数。(满足目标类的构造函数)
class middle{ public: int val_a; int val_b; middle(int a, int b):val_a(a), val_b(b){}};
class test{ public:
int val_1; int val_2; test(int x = 4, int y = 5):val_1(x), val_2(y){} test(const middle& a):val_1(a.val_a), val_2(a.val_b){}};
class other{ public: int val1; int val2; other(int x = 10, int y = 100):val1(x), val2(y){} // operator test(){ //不能有重载,会有二义性。 // test obj; // obj.val_1 = val1; // obj.val_2 = val2; // return obj; // } operator test(){ //用来把other转换为test。 middle obj(val1, val2); //因为test类可以接受一个middle对象来进行构造。所以这样也可以。 return obj; }};
int main(){ test t_obj = other(1,2);}因为test类可以接受一个middle对象来进行构造。所以这样也可以。
当然了最好的写法是和返回语句写到一起。这里是为了看起来清晰。
- 因为核心是让我们源类对象转换成满足目标类对象的构造函数的样子。所以甚至这样都是可以的
class test{ public:
int val_1; int val_2; test(int x = 4, int y = 5):val_1(x), val_2(y){}};
class other{ public: int val1; int val2; other(int x = 10, int y = 100):val1(x), val2(y){} operator test(){ //用来把other转换为test。 return val1; }};
int main(){ test t_obj = other(); cout << t_obj.val_1 << t_obj.val_2 << endl; //10 5
}因为test类对象的构造函数都含有默认值。所以我甚至在转换函数内只返回了第一个参数的值。这个值随后会被当做第一个参数放入test的构造函数。所以最后输出的结果会是10,5。这个10来自other对象构造函数的默认值。这个5来自test对象构造函数的默认值。
- 用户自定义的转换函数还可以是虚函数,但是只有从基类的引用或指针进行派发的时候才会调用子类实现的转换函数
struct D;struct B { virtual operator D() = 0;};struct D : B{ operator D() override { cout << "D" << endl; return D(); }};
int main(){ D obj; D obj2 = obj; // 不调用 D::operator D() B* br = new D; D obj3 = *br; // 通过多态调用 D::operator D()}- 用户定义转换函数不能是类的静态成员函数。
类型转换函数和void
我们看下面代码:
#include <iostream>
struct S { operator void() { std::cout << "F"; }};
int main() { S s; (void)s; // 无输出 static_cast<void>(s); // 无输出 s.operator void(); //输出 F}为什么前两个无输出?因为标准说了:
可以定义转换到(可有 cv 限定的)自身类(或它的引用),转换到它自身类的基类(或它的引用),和转换到类型 void 的转换函数,但它无法作为转换序列的一部分执行,除非在某些情况下通过虚派发来执行:
也就是说,用户定义转换函数永远不会被用于转换一个类型到它的自身类,自身类的基类,和void。如果想这么用,必须手动调用。
A conversion function is never used to convert a (possibly cv-qualified) object to the (possibly cv-qualified) same object type (or a reference to it), to a (possibly cv-qualified) base class of that type (or a reference to it), or to cv
void.
来自CppQuiz 和 这篇StackOverflow
显式类型转换和隐式类型转换的定义
## 显式类型转换定义
如果对于某个虚设变量
temp存在良构声明目标类型 temp(表达式 );,那么表达式 可以显式转换到目标类型。
隐式类型转换定义
当且仅当
T2能从表达式e复制初始化,即对于虚设的临时对象t,声明T2 t = e; 良构(能编译)时,称表达式e可隐式转换到T2。注意这与直接初始化(T2 t(e))不同,其中还会额外考虑显式构造函数和转换函数。
隐式转换序列
转换构造函数
上文explicit提到过
类型转换函数
就在上面。
对于需要进行隐式转换的上下文,编译器会生成一个隐式转换序列:
- 零个或一个由标准转换规则组成的标准转换序列,叫做初始标准转换序列
- 零个或一个由用户自定义的转换规则构成的用户定义转换序列
- 零个或一个由标准转换规则组成的标准转换序列,叫做第二标准转换序列
对于隐式转换发生在构造函数的参数上时,第二标准转换序列不存在。
初始标准转换序列:
初始标准转换序列很好理解,在调用用户自定义转换前先把值的类型处理好,比如加上cv限定符:
struct A {};struct B { operator A() const;};
const B b;const A &a = b;初始标准转换序列会把值先转换成适当的形式以供用户转换序列使用,在这里operator A() const希望传进来的this是const B*(this)类型的,而对b直接取地址只能得到B*,正好标准转换规则里有添加底层const的规则,所以适用。
如果值的类型正好,不需要任何预处理,那么初始标准转换序列不会做任何多余的操作。
如果第一步还不能转换出合适的类型,那么就会进入用户定义转换序列。
用户定义转换序列
- 用户定义的转换函数在隐式转换的第二阶段被调用,第二阶段由零个或一个转换构造函数或零个或一个用户定义转换函数构成。
- 如果转换函数和转换构造函数都能用于进行某个用户定义转换
- 如果类型是直接初始化(参考杂记1),那么只会调用转换构造函数
- **如果是复制初始化或者引用绑定,那么转换构造函数和用户定义转换函数会根据重载决议确定使用谁(忽略掉explicit标注的转换函数)。**另外如果转换函数不是
const限定的,那么在两者都是可行函数时优先选择转换函数,比如operator A();这样的,否则会报错有歧义(GCC 10.2上测试显示有歧义的时候会选择转换构造函数,clang++11.0和标准描述一致)。这也是我们复习了几种初始化有什么区别的原因,因为类的构造形式不同结果也可能会不同。
选择好一个规则后就可以进入下一步了。
如果是在构造函数的参数上,那么隐式转换到此就结束了。除此之外我们需要进行第三步。
第二标准转换序列
这是针对用户转换序列处理后的值的类型做一些善后工作。之所以不允许在构造函数的参数上执行这一步是因为防止过度转换后和用户转换规则产生循环。
struct A{ operator int() const;};
A a;bool b = a;在这里a只能转换成int,而为了偷懒我们直接把a隐式转换成bool,问题来了,初始标准转换序列把A*转换成了const A*(作为this,类方法的隐式参数),用户转换序列把const A*转换为了int,int和bool是完全不同的类型,怎么办呢?
这就用上第二标准转换序列了,这里是数值转换,int转成bool。
不过上面只是个例子,请不要这么写,因为在实际代码中会出现问题:
template <typename T>struct SmartPointer { //... T *ptr = nullptr; operator bool() { return ptr != nullptr; }
T& operator*() { return *ptr; }};
auto ptr = get_smart_pointer();if (ptr) { // ptr 是int*的包装,现在我们想取得ptr指向的值 int value = ptr; // ...}上面的代码不会有任何编译错误,然而它将引发严重的运行时错误。
为什么呢?因为如注释所说我们想取得指针指向的值,然而我们忘记解引用了!实际上因为要转换成int,隐式转换序列里是这样的:
- 初始标准转换序列 -----> 当前类型已经满足调用用户转换序列的要求了,什么都不做
- 用户定义转换序列 -----> 和int最接近的有转换关系的类型只有bool了,调用这个
- 第二标准转换序列 -----> 得到了bool,目标的int,正好有规则可用,进行转换
因此你的value只会有两种值,0和1。这就是隐式转换带来的第一个大坑,而上面代码反应出的问题叫做“安全bool(safe bool)”问题。
我们可以用explicit把它踢出转换序列。
template <typename T>struct SmartPointer { //... T *ptr = nullptr; explicit operator bool() { return ptr != nullptr; }};- 注意引用和隐式类型转换的坑。查看下面的引用和指针的区别。
临时对象:
一般来说临时对象有三种情况产生:
-
以值的方式(包括常量引用)给函数传参
-
隐式类型转换
-
函数返回一个对象时
析构函数和构造函数中的异常
- 构造函数中可以抛出异常,但是抛出的异常会导致析构函数无法被调用。因为被视为对象没有成功构造。会存在内存泄漏风险
- 在析构函数中是可以但是是极度极度不推荐抛出异常的。原因在《More Effective C++》中提到两个:
(1)如果析构函数抛出异常,则异常点之后的程序不会执行,如果析构函数在异常点之后执行了某些必要的动作比如释放某些资源,则这些动作不会执行,会造成诸如资源泄漏的问题。
(2)通常异常发生时,c++的异常处理机制在异常的传播过程中会进行栈展开(stack-unwinding),因发生异常而逐步退出复合语句和函数定义的过程,被称为栈展开。在栈展开的过程中就会调用已经在栈构造好的对象的析构函数来释放资源,此时若其他析构函数本身也抛出异常,则前一个异常尚未处理,又有新的异常,会造成程序崩溃。
inline与宏区别?
- inline:
- 编译期进行展开。
- 是函数
- 嵌入到目标代码
- 可以进行安全检查,语句正确等编译功能
- 宏:
- 预处理期进行替换。
- 不是函数
- 只是文本替换
- 不能进行安全检查等。
inline函数与普通函数区别?
当普通函数在被调用时,系统首先跳跃到该函数的入口地址,执行函数体,执行完成后,再返回到函数调用的地方,函数始终只有一份。
而内联函数则不需要进行一个寻址的过程,当执行到内联函数时,此函数展开(很类似宏的使用),如果在 N 处调用了此内联函数,则此函数就会有 N 个代码段的拷贝。空间换时间。