
lockguard和uniquelock
注意一下锁的含义。为什么锁叫互斥量?不要认为锁和资源是挨着的。或者是资源一定和锁连着。
锁,互斥量是独立的。什么意思?假设我们有规定:想要打开抽屉,必须从桌子上拿走令牌。如果没有令牌则不能打开抽屉。所以说资源(抽屉)和锁(互斥量)不一定在一起。资源在抽屉里,锁在桌子上。两者是分离的。我只要确保每个人都可以访问到令牌(锁)和抽屉(资源)即可。
unique_lock功能丰富灵活得多。如果需要实现更复杂的锁策略可以用unique_lock- 如果只需要基本的锁功能,优先使用更严格高效的
lock_guard。 - 注意区分
mutex和lock_guard/unique_lock。后者是前者的RAII包装器。所以如果要锁的话必须这样
mutex lock;unique_lock<mutex> lkc(lock);两种锁的简单概述与策略对比见下表:
| 类模板 | 描述 | 策略 |
|---|---|---|
| std::lock_guard | 严格基于作用域(scope-based)的锁管理类模板,构造时是否加锁是可选的(不加锁时假定当前线程已经获得锁的所有权—使用std::adopt_lock策略),析构时自动释放锁,所有权不可转移,对象生存期内不允许手动加锁和释放锁 | std::adopt_lock |
| std::unique_lock | 更加灵活的锁管理类模板,构造时是否加锁是可选的,在对象析构时如果持有锁会自动释放锁,所有权可以转移。对象生命期内允许手动加锁和释放锁 | std::adopt_lock std::defer_lock std::try_to_lock |
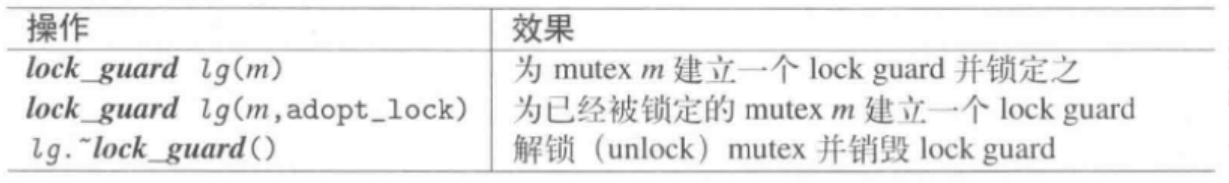
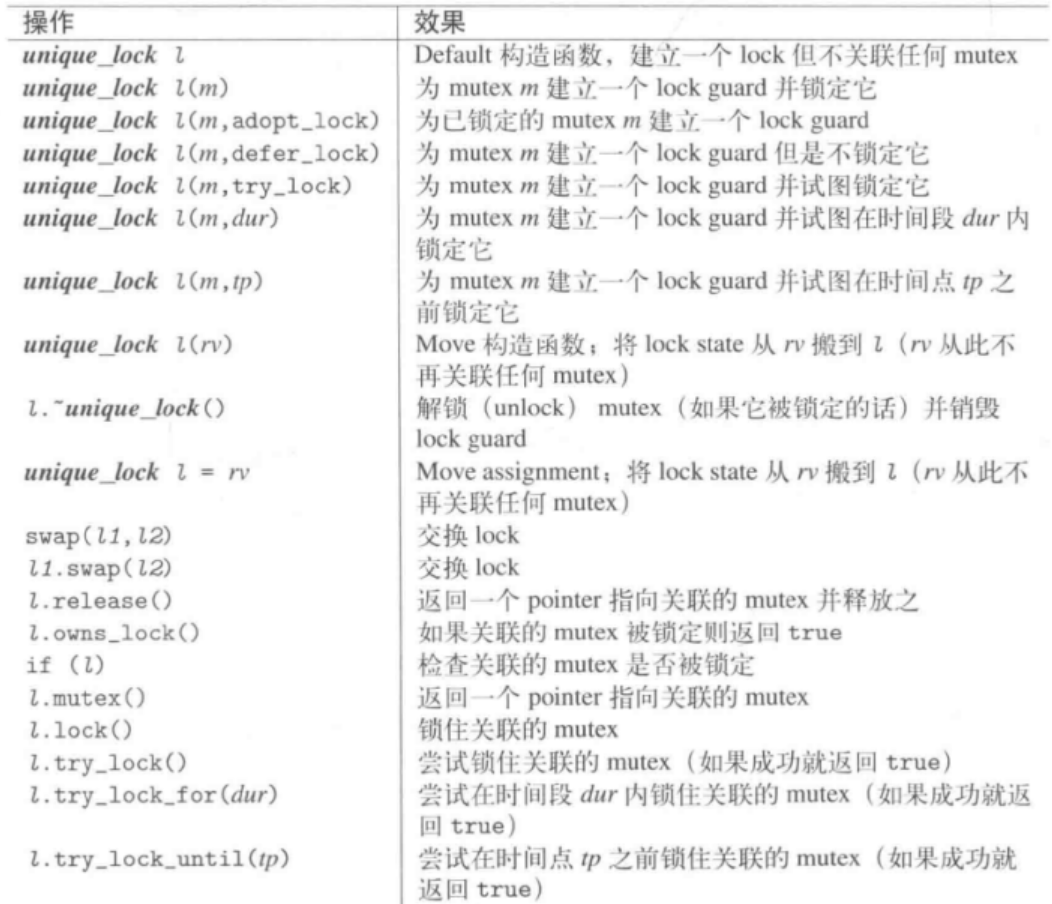
-
lock_guard不能手动解锁。这也是为什么使用条件变量的时候互斥锁一定要使用unique_lock,因为wait函数内部会进行解锁。详细查看项目相关的条件变量。 -
lock_guard不能创建时不锁定,也就是没有defer功能。 -
使用
std::lock对多个unique_lock一起加锁可以避免死锁- 同时,只要传入的多个锁中的一个发生了异常,则所有已锁定的对象都会被解锁。也就是要么全都锁,要么全都不锁。
- 原理其实也是一个包装器。遵循了多线程按照同一个顺序对多个锁进行加锁一定不会死锁 这一个唯一原则。
shared_lock
shared_lock本身和unique_lock的接口差不多.
一般我们是用shared_lock管理共享互斥量. 如shared_mutex. 注意, 非共享互斥量不可以用shared_lock管理
#include <iostream>#include <mutex> //unique_lock#include <shared_mutex> //shared_mutex shared_lock#include <thread>
std::mutex mtx;
class ThreadSaferCounter{private: mutable std::shared_mutex mutex_; // 这个mutable的作用是在下面的const成员函数中可以修改它. 更多查看杂记2 unsigned int value_ = 0;public: ThreadSaferCounter(/* args */) {}; ~ThreadSaferCounter() {};
unsigned int get() const { //读者, 获取共享锁, 使用shared_lock std::shared_lock<std::shared_mutex> lck(mutex_);//等同于执行mutex_.lock_shared(); return value_; //lck 析构, 执行mutex_.unlock_shared(); }
unsigned int increment() { //写者, 获取独占锁, 使用unique_lock std::unique_lock<std::shared_mutex> lck(mutex_);//等同于执行mutex_.lock(); value_++; //lck 析构, 执行mutex_.unlock(); return value_; }
void reset() { //写者, 获取独占锁, 使用unique_lock std::unique_lock<std::shared_mutex> lck(mutex_);//等同于执行mutex_.lock(); value_ = 0; //lck 析构, 执行mutex_.unlock(); }};ThreadSaferCounter counter;void reader(int id){ while (true) { std::this_thread::sleep_for(std::chrono::seconds(1)); std::unique_lock<std::mutex> ulck(mtx);//cout也需要锁去保护, 否则输出乱序 std::cout << "reader #" << id << " get value " << counter.get() << "\n"; }}
void writer(int id){ while (true) { std::this_thread::sleep_for(std::chrono::seconds(1)); std::unique_lock<std::mutex> ulck(mtx);//cout也需要锁去保护, 否则输出乱序 std::cout << "writer #" << id << " write value " << counter.increment() << "\n"; }}
int main(){ std::thread rth[10]; std::thread wth[10]; for(int i=0; i<10; i++){ rth[i] = std::thread(reader, i+1); } for(int i=0; i<10; i++){ wth[i] = std::thread(writer, i+1); }
for(int i=0; i<10; i++){ rth[i].join(); } for(int i=0; i<10; i++){ wth[i].join(); } return 0;}通过实例我们可以得知. 真正的锁本身其实是互斥量. 互斥量本身需要是shared_mutex.
所以:
- 读锁使用
shared_lock锁定shared_mutex - 写锁使用
unique_lock锁定.shared_mutex
互斥锁的底层实现
https://zhiqiang.org/coding/std-mutex-implement.html
- 内存中准备一个表示锁定状态的整数
- 使用CAS操作来尝试修改值(上锁)
- 提供一个函数让互斥锁在被锁定的情况下等待。Linux里面这个操作是
futex系统调用。这会将线程放入队列中,并监视内存中的整数。 - 可能包括防止指令重排的内存屏障
Futex
为什么要有futex
我们已经有了互斥锁和自旋锁。我们也知道了它们的优缺点。自旋锁的主要缺点是在等待时浪费CPU资源。互斥锁的主要缺点是就算无需等待(争抢),也需要进行上下文切换进行系统调用。那么我们为何不将二者的缺点去掉,保留优点呢?所以Futex就来了。
Futex是一种用户态和内核态混合的同步机制。同步的进程间通过mmap共享一段内存,futex变量就位于这段共享的内存中且操作是原子的,当进程尝试进入互斥区或者退出互斥区的时候,先去查看共享内存中的futex变量,如果没有竞争发生,则只修改futex,而不用再执行系统调用,仅当通过访问futex变量告诉进程有竞争发生时,才执行系统调用去完成相应的处理。总结就是:使用一条原子指令,如果上锁成功立即返回。如果上锁失败,执行系统调用进行睡眠。
- 首先,同步的进程间通过
mmap共享一段内存,futex变量就位于这段共享的内存中。且操作是原子的 - 当进程尝试进入互斥区或者退出互斥区的时候,先去查看共享内存中的
futex变量,如果没有竞争发生,则只修改futex,而不 用再执行系统调用了。 - 当通过访问
futex变量告诉进程有竞争发生,则还是得执行系统调用去完成相应的处理(wait或者wake up)。 - 当进程尝试持有锁或者要进入互斥区的时候,对
futex执行”down”操作,即原子性的给futex同步变量减1- 如果同步变量变为0,则没有竞争发生, 进程照常执行。无需进入内核态进行系统调用。
- 如果同步变量是个负数,则意味着有竞争发生,需要调用
futex系统调用的futex_wait操作休眠当前进程。
- 当进程释放锁或者要离开互斥区的时候,对
futex进行”up”操作,即原子性的给futex同步变量加1。- 如果同步变量由0变成1,则没有竞争发生,进程照常执行。无需进入内核态进行系统调用。
- 如果加之前同步变量是负数,则意味着有竞争发生,需要调用
futex系统调用的futex_wake操作唤醒一个或者多个等待进程。
//uaddr指向一个地址,val代表这个地址期待的值,当*uaddr==val时,才会进行waitint futex_wait(int *uaddr, int val);
//唤醒n个在uaddr指向的锁变量上挂起等待的进程int futex_wake(int *uaddr, int n);-
futex_wait是用来协助加锁操作的。线程调用pthread_mutex_lock,如果发现锁的值不是0,就会调用futex_wait,告知内核,线程须要等待在uaddr对应的锁上,请将线程挂起。内核会建立与uaddr地址对应的等待队列。- 为什么需要内核维护等待队列?因为一旦互斥量的持有者线程释放了互斥量,就需要及时通知那些等待在该互斥量上的线程。如果没有等待队列,内核将无法通知到那些正陷入阻塞的线程。
- 如果整个系统有很多这种互斥量,是不是需要为每个
uaddr地址建立一个等待队列呢?事实上不需要。理论上讲,futex只需要在内核之中维护一个队列就够了,当线程释放互斥量时,可能会调用futex_wake,此时会将uaddr传进来,内核会去遍历该队列,查找等待在该uaddr地址上的线程,并将相应的线程唤醒。
-
futex_wake操作是用来实现解锁操作的。glibc就是使用该操作来实现互斥量的解锁函数pthread_mutex_unlock的。当线程执行完临界区代码,解锁时,内核需要通知那些正在等待该锁的线程。这时候就需要发挥futex_wake操作的作用了。futex_wake的第二个参数n,表明需要唤醒几个睡眠的线程。对于互斥量而言,该值总是1,表示唤醒1个线程。当然,也可以唤醒所有正在等待该锁的线程,但是这样做并无好处,因为被唤醒的多个线程会再次竞争,却只能有一个线程抢到锁,这时其他线程不得不再次睡去,徒增了很多开销。
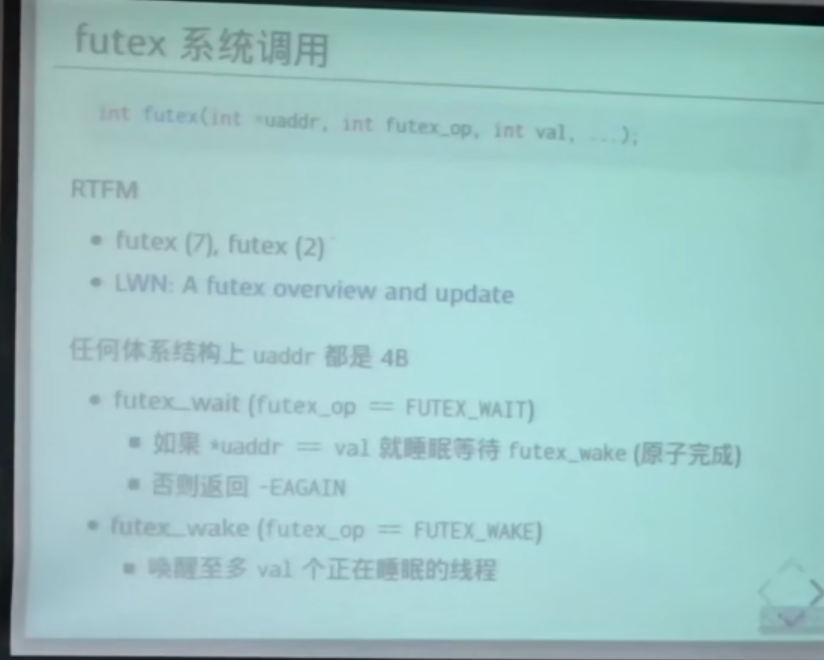
然而,实际上,我们会使用下面这个大的futex系统调用,通过置入选项的方式来决定是调用futex_wait还是futex_wake
long syscall(SYS_futex, uint32_t *uaddr, int futex_op, uint32_t val, const struct timespec *timeout, /* or: uint32_t val2 */ uint32_t *uaddr2, uint32_t val3);futex无论在什么平台都是32位。同时,第二个参数futex_op用来指明到底要等待还是唤醒。
Futex的等待队列
我们说过,futex变量创建于用户空间,在进程或线程间共享,当进程或线程想要进入临界区时,通常会判断futex变量是否满足条件,若满足则成功进入临界区,否则则阻塞在该futex变量上;当进程或线程将要离开临界区时,则会唤醒阻塞在futex变量上的其他进程或线程。在内核中通过struct futex_q结构将一个futex变量与一个挂起的进程(线程)关联起来,其定义以及关键成员的作用如下:
struct futex_q { struct plist_node list; //链表节点 struct task_struct *task; //挂起在该futex变量关联的进程(线程) spinlock_t *lock_ptr; //自旋锁,控制链表访问 union futex_key key; //futex变量地址标识
//下面三个与优先级继承相关,在此不多介绍 struct futex_pi_state *pi_state; struct rt_mutex_waiter *rt_waiter; union futex_key *requeue_pi_key;
u32 bitset; //类似掩码匹配};内核中通过一个全局哈希表来维护所有挂起阻塞在futex变量上的进程(线程),不同的futex变量会根据其地址标识计算出一个hash key并定位到一个bucket上,因此挂起阻塞在同一个futex变量的所有进程(线程)会对应到同一个bucket上,数据结构如下:
//bucketstruct futex_hash_bucket { //当前自旋等待哈希桶的waiter数目 atomic_t waiters;
//自旋锁,用于控制chain的访问, //struct futex_q中lock_ptr,就是引用其所在的bucket的自旋锁 spinlock_t lock;
//优先级链,与传统等待队列不同,futex使用优先级链表来实现等待队列, //是为了实现优先级继承,从而解决优先级翻转问题 struct plist_head chain;} ____cacheline_aligned_in_smp;
//全局哈希表static struct { struct futex_hash_bucket *queues; unsigned long hashsize;} __futex_data __read_mostly __aligned(2*sizeof(long));#define futex_queues (__futex_data.queues)#define futex_hashsize (__futex_data.hashsize)参考来自这里,这里,Linux环境编程 7.7.4 和 南京大学操作系统课程2021P9
futex 的基本思想是竞争态总是很少发生的,只有在竞争态才需要进入内核,否则在用户态即可完成。futex的两个目标是:
- 尽量避免系统调用;(因为需要切换到内核态。比如线程的挂起和唤醒都需要切换至内核态)
- 避免不必要的上下文切换(导致的TLB失效等)。
不同操作系统的futex区别
https://outerproduct.net/futex-dictionary.html
当做扩展阅读看看就行
自旋锁的底层实现
区别就是不挂起,一直使用CAS尝试上锁。
自旋锁和互斥锁的区别
-
自旋锁是一种非阻塞锁,也就是说,如果某线程需要获取自旋锁,但该锁已经被其他线程占用时,该线程不会被挂起,而是在不断的消耗CPU的时间,不停的试图获取自旋锁。不会引起切换
-
互斥量是阻塞锁,当某线程无法获取互斥量时,该线程会被直接挂起,该线程不再消耗CPU时间,当其他线程释放互斥量后,操作系统会激活那个被挂起的线程,让其投入运行。会引起切换
-
两种锁适用于不同场景:
- 如果是多核处理器,如果预计线程等待锁的时间很短,短到比线程两次上下文切换时间要少的情况下,使用自旋锁是划算的。
- 如果是多核处理器,如果预计线程等待锁的时间较长,至少比两次线程上下文切换的时间要长,建议使用互斥量。
- 如果是单核处理器,一般建议不要使用自旋锁。因为,在同一时间只有一个线程是处在运行状态,那如果运行线程发现无法获取锁,只能等待解锁,但因为自身不挂起,所以那个获取到锁的线程没有办法进入运行状态,只能等到运行线程把操作系统分给它的时间片用完,才能有机会被调度。这种情况下使用自旋锁的代价很高。
- 如果加锁的代码经常被调用,但竞争情况很少发生时,应该优先考虑使用自旋锁,自旋锁的开销比较小,互斥量的开销较大
自旋锁的真正使用场景应该是操作系统内核的并发数据结构。
可重入锁和不可重入锁
简单来说我们说过同一个线程对一个锁上锁两次会被死锁。因为第二次进行上锁的时候会尝试拿锁,但是一直拿不到。所以线程会被挂起。除非其他线程帮我们解锁。(查看笔试题整理)
-
可重入锁(reentrant lock):
- 可重入锁简单如字面而言,就是可以重新进入的锁,允许同一进程多次获取同一把锁,是可重复可递归调用的锁,在外层使用锁之后,在内层仍然可以使用,并且不发生死锁(前提是同一个对象或者class),这样的锁就叫做可重入锁,也叫做递归锁。
recursive_mutex
-
不可重入锁(non-reentrant lock):
- 不可重入锁与可重入锁相反,如果当前线程已经获取了该锁,那么再次尝试获取该锁时,就会出现死锁的状况,被阻塞。在这个线程解锁之前,其他线程无法用这个锁再来加锁。
-
可重入锁不与可重入锁的区别:
- 不可重入锁只判断这个锁有没有被锁上,只要被锁上申请锁的线程都会被要求等待。实现起来较为简单。而可重入锁不仅要判断锁有没有被锁上,还会判断锁是谁锁上的,当就是自己锁上的时候,那么他依旧可以再次访问临界资源,并把加锁次数加一。
CAS 的底层实现
汇编指令LOCK CMPXCHG 让CPU锁住cache line。获取该cache line的独占权来针对原子变量进行原子操作。
https://www.cnblogs.com/kendoziyu/p/16571887.html
https://stackoverflow.com/questions/27837731/is-x86-cmpxchg-atomic-if-so-why-does-it-need-lock
CAS 的缺点
-
自旋时间太长
- 如果CAS一直不成功呢?这种情况绝对有可能发生,如果自旋CAS长时间地不成功,则会给CPU带来非常大的开销。
-
只能保证一个共享变量原子操作
- 看了CAS的实现就知道这只能针对一个共享变量,如果是多个共享变量就只能使用锁了,当然如果你有办法把多个变量整成一个变量,利用CAS也不错。例如读写锁中state的高低位。(https://www.cnblogs.com/wait-pigblog/p/9350569.html)
-
ABA问题
- CAS需要检查操作值有没有发生改变,如果没有发生改变则更新。但是存在这样一种情况:**如果一个值原来是A,变成了B,然后又变成了A,那么在CAS检查的时候会发现没有改变,但是实质上它已经发生了改变,只是又回到了原来的值而已,这就是所谓的ABA问题。**对于ABA问题其解决方案是加上版本号,即在每个变量都加上一个版本号,每次改变时加1,即A —> B —> A,变成1A —> 2B —> 3A。
实现一个简单的自旋锁
#include <atomic>
class SpinLock {
public: SpinLock() : flag_(false) {}
void lock() { bool expect = false; //注意,这里就是为什么这个代码不会发生竞争。这里的expect是局部变量 while (!flag_.compare_exchange_weak(expect, true)) { //这里一定要将expect复原,因为如果当前flag是true,expect是false,不相等的话exchange会把expect换成当前flag值也就是换成true。如果不换回去就拉稀了。 expect = false; } }
void unlock() { flag_.store(false); }
private: std::atomic<bool> flag_;};
int main(){ SpinLock myLock; myLock.lock();
//do something
myLock.unlock(); return 0;}我们看一下原理。
- 首先我们初始设定类内的原子变量为false。
- 当我们上锁的时候:
- 第一个线程进来,进行
compare_exchange_weak判断。此时发现当前值和expect值相同。则设定当前值为true。 - 又因为返回值不为
false,不进入while循环。跳出。 - 剩下的线程进来的时候,发现当前值是
true,和expect值不同。则修改期望值(expect)为当前值也就是true。同时返回值是false,进入while循环忙等待。 - 此时进入循环后必须继续将
expect设置为false。因为我们之前把expect修改为true了
- 第一个线程进来,进行
- 直到拿到锁的线程调用
unlock,设置当前值为false。这时候其他线程之一发现,当前值和expect值相同,继续重复第二步
- 注意,我们的
expect是lock函数内的局部变量。意思就是每一个进入到该函数的线程都会有一个自己独有的expect。所以不会发生一个线程修改expect是true之后,在修改回false之前另一个线程进来发现已经是true了直接就拿到了锁的这个情况。
https://www.cnblogs.com/FateTHarlaown/p/9170474.html
更为精简和高性能的自旋锁:
class SpinLock{ public: SpinLock() = default;
void lock(){ while(_flag.test_and_set(std::memory_order_acquire)); } void unlock(){ _flag.clear(std::memory_order_release); }
private: std::atomic_flag _flag = ATOMIC_FLAG_INIT;};- 首先我们把
atomic变量换成了简单的atomic_flag。 - 注意,在
lock函数中,test_and_set的作用是给flag原子赋值为true并返回之前的值。也就是说当有线程抢锁的时候,发现当前的flag已经是true了,就再次设定为true并且返回当前的true值。while循环就是要判断如果返回的是true就一直循环等待。 - 内存序更为合适:我们反复强调了
acquire理解为lock。也就是针对这一行原子操作之后的操作不允许前移。release操作理解为unlock,也就是针对这一行原子操作之前的操作不允许后移。如果使用全序模型则会降低性能。但是这里我们并不阻止合法的指令重排。
我们可以对任何带有lock()和unlock()函数的互斥类使用lock_guard。看一眼源码就知道了。
前向声明
前向声明可以解决两个类互相包含的问题。因为前向声明属于不完整类型,所以有如下限制:
-
可以
- 将成员声明为指向不完整类型的指针或引用
- 声明接受/返回不完整类型的函数或方法
- 定义接受/返回指向不完整类型的指针/引用的函数或方法(但不使用其成员)
-
不可以
- 将其用作基类
- 用它来声明一个成员(使用对象)
- 使用该类型定义函数或方法
- 使用其方法或字段,实际上试图解引用类型不完整的变量
- 这里就是使用这个前向声明类型的指针然后对其解引用使用其类型包含的数据或方法。
-
实际上只需要分文件或者类外编写函数的定义就可以了。也就是实际使用的时候等到类已经被正式定义完毕就可以了。
delete 作用于不完整类型是不合法的
https://en.cppreference.com/w/cpp/language/delete.html
如果被删除的对象在删除时具有不完整的类类型,并且完整的类具有非平凡的析构函数或释放函数,则行为未定义(直到 C++26)程序格式不正确(自 C++26 起)。
模板相关
类模板定义规则
- 注意c++类模板定义方法 类模板没有自动类型推导。所以只要使用了就必须显式指定参数类型。
- 但是类模板可以有默认参数和偏特化
- 类模板中的成员函数只有在调用的时候才会被创建。因为在编译阶段,编译器无法确认模板的参数类型,所以无法创建模板类成员函数
template<typename 模板参数表>class 类名{ // 类定义......};- 注意全特化和偏特化的语法
template<typename T1, typename T2>class test{ T1 data1; T2 data2;};//全特化template<>class test<int, float>{ int data1;};//偏特化template<typename T2>class test<int, T2>{ int data1;};模板调用顺序 规则
- 类模板: 对主版本模板类、全特化类、偏特化类的调用优先级从高到低进行排序是:全特化类>偏特化类>主版本模板类。这样的优先级顺序对性能也是最好的。
- 函数模板: 如果函数模板和普通函数都可以实现,优先调用普通函数 可以使用空模板参数列表来强制调用函数模板 函数模板也可以重载 如果函数版可以产生更好的匹配,则优先调用函数模板.
- 函数模板只能全特化
void test(int a, int b){ cout << "普通函数" << endl;}
template <typename T>void test(T a, T b){ cout << "模板函数" << endl;}
template <typename T>void test(T a, T b, T c){ cout << "重载的模板函数" << endl;}
int main(){ test(1,2); //输出普通函数 test<>(1,2); //使用空模板参数列表 输出模板函数 test(1,2,3); //输出重载的模板函数}模板模板参数
模板的模板参数的经典应用是在某些自定义指定储存容器类型的时候不指定元素类型。
- 最基本的举例
template<template<typename> class container, typename T1, typename T2> // 最基本的举例class test{ container<T1> a1; container<T2> a2;};- 茴字的三种写法, 都可以
template <typename T, template <typename> class Container>template <typename T, template <class> class Container>template <typename T, template <typename> typename Container>- 更好的理解的写法:
template <typename T, template <typename T1> typename Container>- 更多例子参见template_template_parameter_*文件
模板参数按值传递还是引用传递
非类型模板参数
这块之前居然忽略了。必须简单说一下
template<typename T>void func(T obj){ //...}
int main(){ func<int>(5); return 0;}我们都知道模板参数一般都是类型。比如这里,T就是int。是类型。
但是如果我们有时候需要一些特殊情况, 例如想要传点奇怪东西的时候。
template<typename T, int MAXSIZE>void func1(T obj){ vector<T>a; a.reserve(MAXSIZE); cout << a.capacity() << endl; a.push_back(obj); cout << a[0] << endl; //干啥了不解释了 忽略即可}这里的int MAXSIZE就是非类型模板参数。因为他不是类型,而是变量。
使用非类型模板参数是有限制的。通常它们只能是:
- 整型常量或字面值(包含枚举,或可隐式转换的比如
bool)(stringdouble都不可以。前者是类对象,后者是浮点数) - 指向对象/函数/成员变量的指针
- 对象/函数的左值引用
std::nullptr_t
当传递对象的指针或者引用作为模板参数时,对象不能是字符串常量,临时变量或者数据成员以及其他子对象。由于C++17之前,C++每次版本更新都会放宽以上限制,因此还有一些针对不同版本的限制:
- C++11中,对象必须要有外部链接
- C++14中,对象必须是外部链接或者内部链接
所以:传入的s必须是常量。
const int s = 8; //必须是constfunc1<int, s>(5);func2<int, 4>(5); //或者直接传入字面值。搭配类模板偏特化的小例子
template<typename T, bool option>class myclass; //主模板不实现
template<typename T>class myclass<T, true>{ //偏特化1,注意语法。T在这里依旧要写上。 public: void func(){ cout <<"true one" << endl; }};
template<typename T>class myclass<T, false>{ //偏特化2,注意语法。T在这里依旧要写上。 public: void func(){ cout <<"false one" << endl; }};
int main(){ const bool myoption = true; myclass<int, false> obj; //直接使用字面值 obj.func(); myclass<int, myoption> obj1; //或必须用const常量变量。 obj1.func(); return 0;}enable_if
简单看一下原型
template <bool, typename T=void>struct enable_if {};template <typename T>struct enable_if<true, T> { ///< 第一个模板参数为 true using type = T; ///< type 才有定义};意思就是,前面的表达式为真,后面的类型定义才有意义。
一般三种用法:
- 控制函数返回类型
- 校验函数模板参数类型
- 类型偏特化
这里就随便写个控制函数返回类型的例子:
template<int stat> //这里是非模板类型参数。上面提到了。注意一下typename enable_if<stat == 1, bool>::type checkstate(){ cout <<"type is bool" << endl; return true;}template<int stat>typename enable_if<stat == 0, int>::type checkstate(){ cout <<"type is int" << endl; return 5;}
template<bool stat> //bool也可以。隐式转换为整型了,但是必须要常量。typename enable_if<stat == true, int>::type checkstate1(){ cout <<"type is int" << endl; return 5;}
int main(){ const int myobj = 1; //必须是const checkstate<myobj>(); //输出"type is bool" checkstate<0>(); //输出"type is int" return 0;}注意事项:返回类型前必须加typename来告知enable_if::type是个类型。还有就是非模板类型参数的限制。
函数的变长参数模板
- 基本定义
template <typename T, typename... Args>// 如果函数参数列表中一个参数的类型是一个模板参数包,// 则此参数也是一个函数参数包void func(const T& t, const Args&... rest);- C++17之前的写法:因为没有折叠表达式
void print (){//必须要有无参重载,否则会无限递归。也就是最后一次无参无法被调用。//最后一次被解包后,参数包会为空。所以会调用无参函数。}template<typename T, typename... Args>void print (T firstArg, Args... args){ cout << firstArg << endl; //print first argument print(args...); // call print() for remaining arguments}int main(){ print(1, 1000, "b23", 1.123, "HahaahaH", 42); return 0;}- C++17之后的写法:有了折叠表达式
template<typename T> //要有单参打印的重载。不然会无限调用。void print(T t){ cout << t << endl;}
template<typename... Args>void print(Args... args){ (print(args),...); //这里外部一定要加括号。注意语法}
int main(){ print(1, 1000, "b23", 1.123, "HahaahaH", 42); return 0;}- 多种变长参数模板可以同时存在 尽管直观看起来会有二义性
搭配列表初始化
- 函数变长参数模板搭配列表初始化。
- 这个函数会返回一个
T类型的vector,元素是args
- 这个函数会返回一个
template<typename T, typename... Args>vector<T> func(const Args&... args){ return {args...};}int main(){ auto vec = func<int>(1,2,3,4,5,6,7); for(auto& i:vec){ cout << i << endl; }}/*输出:1234567*/类的变长参数模板
- 基本定义:
template<typename... Ts> class Variadic;-
其模板实例化:
-
0个参数的模板类
Variadic<> zero; -
多个参数的模板类
Variadic<int, double, std::string, std::list<int>> sample;
-
模板类对象做为函数参数传入
template<typename T1, typename T2>class test{public: T1 _a; T2 _b; test(T1 a, T2 b) : _a(a), _b(b) {}};
void testprint1(test<int,int>& obj){ //方法1 显式指定传入类型 cout << obj._a << obj._b << endl;}
template<typename T1, typename T2>void testprint2(test<T1, T2>& obj){ //方法2 使用参数模板 cout << obj._a << obj._b << endl;}
template<typename T>void testprint3(T& obj){ //方法3 利用函数模板的自动推导特性 cout << obj._a << obj._b << endl;}
int main(){ test<int,int> b(5,5); testprint1(b); testprint2(b); testprint3(b);}类模板 模板类 的继承 子类调用父类构造函数
- 当有多继承的时候,子类继承的父类必须全部拥有默认无参构造函数。因为创建子类对象时,一定会先调用父类构造函数。如果子类的构造函数没有指明调用父类的有参构造的话,就会调用默认构造。但是一旦类有了一个构造函数,编译器就不会自动生成默认构造函数,导致编译失败。
template<typename T1, typename T2>class test{public: T1 _a; T2 _b;
test(T1 a, T2 b) : _a(a), _b(b) {}
void showitem(){ cout << this->_a << "," << this->_b << endl; }
};
template<typename T1, typename T2, typename T3, typename T4>class test1 : public test<T1, T2>{ //!继承模板父类,子类父类都要是模板类。而且要显式指定父类模板类型。public: // T1 _a; //!如果子类也有自己的_a 和_b变量的话 那就不能调用父类构造函数赋值。 //!想一下,子类自己的东西怎么可能让父类构造函数赋值? //@所以调用父类构造函数赋值其实相当于给子类的父类成分赋值。 // T2 _b; T3 _c; T4 _d; //test1(T3 a, T4 b) : _a(a), _b(b) {} test1(T1 a, T2 b, T3 c, T4 d) : test<T1, T2>(a,b),_c(c),_d(d) //调用父类构造函数赋值 //!记得调用模板类父类构造函数的时候要显式指定数据类型 { //!可以用构造列表也可以普通构造函数 // _c = c; // _d = d; } void showitem(){ cout << this->_a << "," << this->_b << "," << this->_c << "," << this->_d<< endl; }
};
int main(){ test<int,int>* b = new test<int, int>(5,5); b->showitem(); test1<int, int, char, char>* c = new test1<int, int, char, char>(1,2,'a','b'); c->showitem();
//指针和对象都可以 test<int,int> bb(5,5); bb.showitem(); test1<int, int, char, char> cc (1,2,'a','b'); cc.showitem();}普通类的子类调用父类构造函数长这样
class A { public: A(){} A(int a) :m_a(a) {} virtual~A(){} int m_a;};
class B : public A{ public: B(){} B(int x):m_b(x){} B(int no, int x):A(no),m_b(x){} //子类调用父类构造。必须用初始化列表。 ~B(){} int m_b;};
int main(){ B b(5,8); cout << b.m_a << endl;
return 0;}模板类 类模板 成员函数 类外实现
template<typename T1, typename T2>class test{ T1 _a; T2 _b; test(T1 a){} //构造1 test(T1 a, T2 b){} //构造2 void func1(); //无参函数1 void func2(T1 a); //有参函数2};
/*类模板 成员函数 类外实现头部要加模板作用域部分要显式指明数据类型*/template<typename T1, typename T2>test<T1, T2>::test(T1 a) : _a(a){} //构造1 使用初始化列表
template<typename T1, typename T2>test<T1, T2>::test(T1 a, T2 b){ //构造2 _a = a; _b = b;}
template<typename T1, typename T2>void test<T1, T2>::func1(){ //无参函数1 cout <<"func1" << endl;}
template<typename T1, typename T2>void test<T1, T2>::func2(T1 a){ //有参函数2 cout <<"func2" << endl;}万能引用相关
参见杂记。
auto
- auto 变量必须在定义时初始化,这类似于const关键字。
- 定义在一个auto序列的变量必须始终推导成同一类型。例如:
auto a4 = 10, a5 = 20, a6 = 30;//正确auto b4 = 10, b5 = 20.0, b6 = 'a';//错误,没有推导为同一类型- 如果初始化表达式是引用,则去除引用语义。
int a = 10;int &b = a;
auto c = b;//c的类型为int而非int&(去除引用)c = 100;cout << c << endl; //100cout << b << endl; //10cout << a << endl; //10我们看到了即使b是a的引用,我们使用b初始化c的时候依旧使用了值语义。也就是c是一个独立变量。更改c的值不影响a和b
int a = 10;int &b = a;
auto &c = b;//c的类型为int&c = 100;cout << c << endl; //100cout << b << endl; //100cout << a << endl; //100- 如果初始化表达式为const或volatile(或者两者兼有),则除去const/volatile语义。
const int a1 = 10;auto b1= a1; //b1的类型为int而非const int(去除const)const auto c1 = a1;//此时c1的类型为const intb1 = 100;//合法c1 = 100;//非法- 如果auto关键字带上&,则不去除const语意。
const int a2 = 10;auto& b2 = a2;//因为auto带上&,故不去除const,b2类型为const intb2 = 10; //非法- 初始化表达式为数组时,auto关键字推导类型(退化)为指针。
int a3[3] = { 1, 2, 3 };auto b3 = a3;cout << typeid(b3).name() << endl; //int *- 若表达式为数组且auto带上&,则推导类型为数组类型
int a7[3] = { 1, 2, 3 };auto & b7 = a7;cout << typeid(b7).name() << endl; //int[3]- 时刻要注意auto并不是一个真正的类型。
- auto仅仅是一个占位符,它并不是一个真正的类型,不能使用一些以类型为操作数的操作符,如sizeof或者typeid
所以我们才会有auto& , auto&&,const auto,const auto&等等。还可以有auto*,也可以被cv修饰
- 注意在使用增强for循环遍历容器元素时,如果声明为auto则最好变成
const auto&防止修改和拷贝。- 使用增强for循环遍历容器元素时,
auto的类型是容器内元素的类型。所以需要加const或&
- 使用增强for循环遍历容器元素时,
auto&&是万能引用
格外注意:auto&&是万能引用,除了从花括号包围的初始化器列表推导时除外
auto&& z = {1, 2, 3};//这个不是万能引用。(初始化器列表的特殊情形)其他细节参见列表初始化。
C++17 复制省略技术
-
返回值优化(RVO),即通过将返回值所占空间的分配地点从被调用端转移至调用端的手段来避免拷贝操作。返回值优化包括具名返回值优化(NRVO)与无名返回值优化(URVO),两者的区别在于返回值是具名的局部变量还是无名的临时对象。
-
右值拷贝优化,当某一个类类型的临时对象被拷贝赋予同一类型的另一个对象时,通过直接利用该临时对象的方法来避免拷贝操作。
- 在一个变量的等号右侧是 临时变量(prvalue) 的时候,这里会用 direct-initalize,而不是尝试使用 copy/move initialize。对于一些没有拷贝构造或移动构造的对象,如
unique_ptr、atomic,std::array等可以使用等号初始化了。但是前提是右侧是一个临时对象以满足右值拷贝优化。
- 在一个变量的等号右侧是 临时变量(prvalue) 的时候,这里会用 direct-initalize,而不是尝试使用 copy/move initialize。对于一些没有拷贝构造或移动构造的对象,如
所以
auto a = atomic<int>{9}; //c++14 error, C++17 OKatomic<int>s = 4;//c++14 error, C++17 OK注意一个常见误区
std::unique_ptr<int> func(int x){ std::unique_ptr<int> p = std::make_unique<int>(x); return {p};
}
std::unique_ptr<int> func2(int x){ std::unique_ptr<int> p = std::make_unique<int>(x); return p;
}func2可以而func1编译错误的原因是因为编译器试图将 p拷贝到一个新的 std::unique_ptr<int> 中。然而,由于 std::unique_ptr 不允许拷贝,所以编译器会报错,提示尝试使用被删除的拷贝构造函数。而func2是使用了移动构造。所以这里和RVO其实没有关系。当然了,如果可行的话编译器会把它优化为NRVO.
gcc14引入 -Wnrvo 帮助提醒优化返回值
RVO是编译时优化
## 理解RVO语义
进行复制消除时,实现将被省略的复制/移动 (C++11 起)操作的源和目标单纯地当做指代同一对象的两种不同方式,而该对象将在假如不进行优化时两个对象中后被销毁的对象销毁时销毁(但如果被选择的构造函数的形参是对象类型的右值引用,那么该销毁发生于目标对象本应被销毁时) (C++11 起)。
注意这句话:源和目标单纯地当做指代同一对象的两种不同方式
如何理解呢?
myobj func2(bool s){ myobj d {2}; if(s){ return d; } d.val = new int(3); return d;}比如这段代码,myobj只会被构造一次。原因是编译器发现无论进行何种操作,我们返回的都是d,那么此时可以进行复制消除。也就是返回出去的返回值其实和d是同一个实例。有点类似于引用的关系。这种就是NRVO。请注意,在这种情况下,T必须是有可访问的复制或移动构造函数,即使最终没有调用实际的复制或移动构造函数。
myobj func(bool s){ myobj d {2}; if(s){ return d; } else { return myobj{3}; }}这段代码,一定会进行一次构造,而且一定会有一次拷贝或移动。因为d一定会被构造,但是具体是返回d还是一个新的临时对象是完全运行时确定的。编译器无法推测。所以这种情况下,要么是构造+移动,(这里的NRVO是不生效的)要么是构造+构造。(这里的第二次构造临时对象是直接构造在返回值里的。所以RVO是生效的。)
myobj func2(bool s){ if(s){ return myobj{3}; } myobj d {2}; return d;}这段代码变得奇怪了。其实是和上一段代码反过来写。但是这次,如果s是true, 则RVO生效。所以只有一次构造。
这一部分可以看一下这篇文章
stringstream
我们可以使用stringstream方便的在string和其他内置类型之间进行转换。
- 首先要
#include<sstream> - 然后需要有一个
stringstream对象stringstream ss - 我们可以把字符串使用流插入运算符
<<把要转换的字符串插入stringstream对象 - 使用流提取运算符
>>把转换完成的对象提取至对应类型的变量内 - 然后记得把
stringstream对象清空。 - 支持负数自动转换。
vector<int> process(vector<string>& input){ vector<int> ret; stringstream ss; //stringstream对象 for(int i = 0; i < input.size(); i++){ ss << input[i]; //要转换的东西插入对象 int a; ss >> a; //提取至我们想要的对象 ss.clear(); //清空stringstream对象 ret.push_back(a); } return ret;}int main(){ vector<string> s{"1","2","200","-20","-10000"}; vector<int> ret = process(s); for(int i = 0; i < ret.size(); i++){ cout << ret[i] << endl; } return 0;}我们还可以使用stringstream进行默认分割。此处是根据空格,tab和回车换行分割
void split(const string& str){ vector<string> item; stringstream ss(str); //字符串放入stringstream对象 string temp; //储存临时分割对象 while(ss >> temp){ //直到字符耗尽 item.emplace_back(temp); //放入结果数组。 }
for(auto& i:item){ cout << i << endl; }
}我们还可以使用stringstream搭配getline进行自定义分割。
void split(const string& str, const char& splitter){ vector<string> item; stringstream ss(str); string temp; while(getline(ss, temp, splitter)){ item.emplace_back(temp); } for(auto& i:item){ cout << i << endl; }
}std::initializer_list
搭配聚合初始化一起看。
-
initializer_list会在下列情况自动构造:-
用花括号初始化器列表列表初始化一个对象,其中对应构造函数接受一个
std::initializer_list参数- 这句话的意思就是使用
{}初始化对象并且有匹配initializer_list的构造函数
- 这句话的意思就是使用
-
以花括号初始化器列表为赋值的右运算数,或函数调用参数,而对应的赋值运算符/函数接受
std::initializer_list参数。- 这句话的意思就是使用
{}初始化对象并且有匹配initializer_list的函数形参
- 这句话的意思就是使用
-
绑定花括号初始化器列表到
auto,包括在范围 for 循环中-
这句话的意思就是我们说的
auto在遇到一个用花括号初始化的对象的时候始终会认为其是一std::initializer_list -
auto t = {1,2,3,4}; //t会被推导为initializer_listfor(auto x:{1,2,3,4}){ //这里的{1,2,3,4}也是initializer_list//...}
-
-
-
在我们使用大括号进行列表初始化的时候,如果我们有显式的符合对应条件的列表初始化构造函数则会优先匹配。
- 如果我们使用了大括号进行列表初始化,则编译器会强烈的,尽可能的匹配至形参为
initializer_list的构造函数。如果不匹配则会继续查找其他的构造函数。但凡可以匹配至initializer_list,编译器就会使用这个。 - 在构造函数重载决议期间,只要有任何可能,大括号初始化物就会和带有
std: : initializer_ list型别的形参相匹配,即使其他重载版本有着貌似更加匹配的形参表 - !!!!!!这里有个大坑!!!!下面说!!!!
- 如果我们使用了大括号进行列表初始化,则编译器会强烈的,尽可能的匹配至形参为
-
注意列表初始化只能使用相同类型或可以被转换为相同类型的参数。
-
匹配
initializer_list构造函数必须使用{} -
如果有默认构造函数就算有
initializer_list构造函数,但是如果对象构造时入参为空,就算使用了{}也优先匹配默认构造函数。除非没有默认构造函数。- 语言规定,形如
T obj{}这样的情况下,应该执行默认构造。因为空的大括号表示的是没有实参,而不是空的initializer_list - 如果确实想要表达出**空的
initializer_list**的含义,可以使用T obj({}) - 如果没有默认构造函数,则会匹配
initializer_list构造函数。也就是构造对象时就算没有参数要输入也必须加{}
- 语言规定,形如
-
initializer_list构造函数拥有高优先级。但是默认构造函数(default constructor)拥有最高优先级
class myclass{ public: myclass(){ cout <<"default" << endl; };
myclass(int x, int y):val1(x), val2(y){ cout <<"cont0" << endl; } myclass(int x, int y, int z):val1(x), val2(y), val3(z){ cout <<"cont1" << endl; } myclass(int x, int y, int z, const string& s):val1(x), val2(y), val3(z), s_m(s){ cout <<"cont2" << endl; } myclass(std::initializer_list<int>list){ cout <<"initializer_list" << endl; };
myclass(const myclass& rhs){ cout << "copy const" << endl; }
operator int(){ //用户定义转换函数 cout <<"user define conversion" << endl; return 0; }
int val1; int val2; int val3; string s_m = "";};
int main(){ myclass obj0{1,2}; //initializer_list 因为使用了大括号 myclass obj1{1,2,3}; //initializer_list 因为使用了大括号 myclass obj2{1,2,3, "abcd"};//cont2 虽然使用了大括号但是类型不匹配,所以转而匹配普通的符合条件的构造函数。
myclass obj4(1,2); //cont0 因为没有使用大括号 myclass obj5(1,2,3);//cont1 因为没有使用大括号 myclass obj6(1,2,3,"abcd");//cont2 因为没有使用大括号
myclass obj7; //default 注意不能加小括号。那是函数声明。 myclass obj8{}; //default。就算有initializer_list构造函数,但是如果创建对象是无参的也优先匹配默认无参构造函数因为他有最高优先级。除非没有默认无参构造函数。 myclass obj9({}); //initializer_list。因为小括号套了大括号,表达出空的initializer_list意愿。
myclass obj10(obj7); //copy const 无需解释 myclass obj11{obj7}; //大坑。先user define conversion,再initializer_list return 0;}这里就是刚才说的大坑。注意obj10和obj11。匹配至initializer_list的意愿如此强烈,以至于obj11是先使用了用户定义转换函数转换为int,然后匹配至initializer_list构造函数。
- 特别的,如果
initializer_list构造函数被explicit修饰,则也需遵照其explicit禁止隐式类型转换的规则。 - 如果构造函数所有参数都有默认值,这个构造函数就成了默认构造函数。
- 默认构造函数就是要么没有参数,要么所有参数都有默认值。
class obj{ public: explicit obj(int a = 10, int b = 20):val1(a), val2(b){}; //禁止隐式类型转换。 int val1; int val2;};int main(){ obj t1; //可以。有默认构造函数。 obj t2{10,20}; //可以,explicit只能限制拷贝初始化。这里是直接初始化。 obj t3 = {10,20}; //不可以,禁止隐式类型转换。 obj t4 = obj{10,20}; //可以,显式类型转换。 return 0;}- 注意,当一个类中不仅含有普通构造函数,还含有
initializer_list构造函数,那么这个类在使用()或{}初始化的时候会有不同的含义。比如vector。例子:
class myobj{ public: myobj(int x, int y){ inner_vec.resize(x, y); //可能会有更优雅的解决方案。 } myobj(initializer_list<int>my_list){ for(auto& j:my_list){ inner_vec.emplace_back(j); } } vector<int> inner_vec;};
int main(){ myobj ob1(2,3); //两个值为3的元素。 for(auto& i:ob1.inner_vec){ cout <<i << endl; } cout <<"----------" << endl; myobj ob2{1,2,3,4,5,6,7}; //把元素1,2,3,4,5,6,7放入vector for(auto& i:ob2.inner_vec){ cout <<i << endl; } return 0;}原理分析
-
别他妈瞎研究了。魔法就完了。可以看看它的构造函数长啥样你就知道了。推测是当用
{}进行初始化的时候,首先会创建一个array,并将初始化元素存放起来。然后,调用initializer_list的构造函数,用array首元素的迭代器和array的元素个数,进行初始化。(https://blog.csdn.net/xiangbaohui/article/details/103609076)。这是汇编层面了。 -
除此之外,还有如下几个注意点:
-
initializer_list是一个轻量级的容器类型,内部定义了iterator等容器必需的概念。- 其中有3个成员接口:
size()、begin()和end()。遍历时取得的迭代器是只读的,无法修改其中的某一个元素的值;
- 其中有3个成员接口:
-
对于
initializer_list而言,它可以接收任意长度的初始化列表,但要求元素必须是同种类型T(或可转换为T); -
initializer_list会复制初始化传入的元素至底层的数组。这就是(无编译器优化时)额外开销的来源。但是多个复制的std::initializer_list共用底层数组空间。-
上面这句话比较难理解。意思是虽然
std::initializer_list会复制初始化传入的元素,但是复制一个std::initializer_list不会复制其底层对象。只会复制其内部的几个指针而已。 -
再次注意,上面加粗的部分是两句话。
- 1:
std::initializer_list会复制初始化传入的元素。所以它是拷贝进去,然后拷贝出去。开销较大。来自 - 2:复制一个
std::initializer_list不会复制其底层对象。只会复制其内部的几个指针而已 - 所以
std::initializer_list一个严重问题之一是元素不适用于仅移动类型。比如std::unique_ptr。
- 1:
-
底层数组是
const T[N]类型的临时数组,其中每个元素都从原始初始化器列表的对应元素复制初始化(除非窄化转换非法)。底层数组的生存期与任何其他临时对象相同,除了从数组初始化 initializer_list 对象会延长数组的生存期,恰如绑定引用到临时量(有例外,例如对于初始化非静态类成员)。底层数组可以分配在只读内存。 -
因此,通过拷贝构造对象与原对象共享列表中的元素空间。也就是说,
initializer_list的内部并没有内含该array的内容,仅仅是拥有指向array的迭代器。如果对这个容器进行拷贝构造或者拷贝赋值的话,array的内容只有一份,但有两份迭代器指向同一片位置。如果对initializer_list对象copy一个副本,默认是浅拷贝,此时两个对象指向同一个array。这是危险的。
-
-
-
注意
std::initializer_list底层是常量数组const T[N]。所以不能直接修改其存储的元素。返回的引用也是常量引用。迭代器也是常量迭代器。
std::initializer_list<int> func(void){ int a = 1, b = 2; return {a, b}; //a与b是局部变量在func返回后会被释放,但是复制的返回值initializer_list不会创建元素副本。而是和临时对象共享空间。所以 //func返回后会被释放,initializer_list内部会存在空悬引用!危险! //正确的做法可以将返回值改为保存副本的容器,如vector<int>}
//注意下面s1、s2、s3和s4均共享元素空间initializer_list<string> s1 = { "aa", "bb", "cc", "dd" };initializer_list<string> s2 = s1;initializer_list<string> s3(s1);initializer_list<string> s4;s4 = s1;
//注意元素会被复制初始化int a = 200;int b = 300;int c = 400;initializer_list<int> mylist{ a,b,c };a = 800;cout << *mylist.begin() << endl; //200cout << a << endl; //800额外注意initializer_list会导致额外开销。但部分可以被编译器优化。
这东西非常看编译器。不建议深入研究。比如Clang就没第二个move。
vector<myobj> a{myobj(20)};/*const //构建myobj临时对象mv //这个移动是因为vector有一个构造函数接受std::initializer_list。所以外部的{}花括号初始化器beace-init-list会把它当成std::initializer_list。这个move是为了创建这个std::initializer_list。mv //这个移动是为了把我们刚才构建好的std::initializer_list值传递给vector的构造函数。可能因为传入的是右值则此时触发移动构造。copy const //从initializer_list拷贝至容器内。这个是另一个开销。因为std::initializer_list永远复制进来复制出去。所以这个地方不是mv而是copy const。destdestdest*/std::vector<myobj, std::allocator<myobj> > a = std::vector<myobj, std::allocator<myobj> >{std::initializer_list<myobj>{myobj(myobj(myobj(20)))}, std::allocator<myobj>()}; //cpp insight 展开后长成这样。不知道为何有那一大串myobj- 不使用initializer_list,没有额外开销。
myobj obj(20);vector<myobj> a;a.push_back(obj);/*const //构造myobj对象copy const //拷贝构造至容器。destdest*/https://akrzemi1.wordpress.com/2016/07/07/the-cost-of-stdinitializer_list/
指针A给指针B赋值的意思是将指针A指向的地址赋给指针B
int digit = 5;int* a = &digit;int* b = a; //指针a指向的地址赋给指针b 没有新对象产生所以不会调用拷贝构造。int* c = &*a; //等同于将指针a先解引用(*a = 5),得到指针a指向的的值。然后把这个值取地址(&*a)赋值给指针c。
cout << b << endl; //打印b储存的地址。也就是b指向的地址。 也就是变量地址。等同于&digit 和&*bcout << &b << endl; //打印b自己的地址。cout << &*b << endl; //打印b指向的地址的值的地址。等于直接打印指针。cout << &digit << endl; //打印变量地址。等于直接打印指针和&*bcout << *b << endl; //解引用b 打印b指向的地址的值。指针加法
指针直接和数字相加:意思是指针当前指向的地址 + 对应指针类型的大小 * 数字。
举例:
int * p;p = (int*)malloc(100); //分配100字节。cout << p<< endl; //打印p储存的地址。也就是指针指向的地址。是内存首地址。此处输出 0x771410auto y = p + 1; //把p指向的地址偏移4位(因为int是4字节)后赋值给y。printf("%#x",y); //打印y储存的地址。也就是指向的地址。此处输出 0x771414也就是说指针直接和数字相加,可以理解为用指针操作数组。加几就是将指针往后移动几位。具体偏移量也就是对应对象的大小*移动位数。
如果想要指定一个具体的偏移量应该怎么办?
首先,可以使用转型将指针转换为对应类型。然后再加数字。
举例:
obj* p;p = (obj*)malloc(sizeof(int) * 10);cout << p<< endl; //打印p储存的地址。也就是指针指向的地址。是内存首地址。 此处输出 0x771410auto x = (char*)p + 1; //把p指向的地址偏移1位后赋值给x。因为char是1位。printf("%#x\n",x); //打印x储存的地址。也就是指向的地址。此处输出 0x771411auto y = (obj*)p + 1; //把p指向的地址偏移8位后赋值给x。因为obj是指针类型。8位。printf("%#x\n",y); //打印y储存的地址。也就是指向的地址。此处输出 0x771418注意:指针类型转换指的是指针转换为对应类型的指针。
此处不要使用cout
auto x = (char*)p的意思是把指针p转为char*类型的指针。不可以auto x = (char)p。 这样做的意思是直接转换成了char。当然,所有的指针都是8字节。记住,指针类型指的是告诉指针应该读取指针指向的地址之后多大的数据。
怎么理解这个操作呢。我们可以想一下。如果 a是int*类型,也就是int类型指针。意思是指针a指向的数据是int,所以需要以4字节为一段进行读取。也就是一次读取四个字节。那么a+1其实是对地址进行了+4操作。因为指针+1的意思是将指针往后移动一个对象位。也就是指针当前指向的地址 + 对应指针类型的大小(此处为4) * 数量(此处为1)。但是我们如果想要对地址+1的话怎么办?我们可以把指针a转换为char*类型也就是char类型指针。而不是int类型指针。这样相当于告诉编译器,指针a指向的数据是char。所以需要以1字节为一段进行读取。也就是一次读取一个字节。所以此时a+1就是对地址进行了+1操作。也就是指针当前指向的地址 + 对应指针类型的大小(此处为1) * 数量(此处为1)。
移动一个对象位也就是移动的偏移量为对象大小。
int digit = 5;int* a = &digit;cout << a << endl;auto x = (char*)a + 1;printf("%#x\n",x);注意!(char*)a + 1往后移动1位的时候,(char*)a的意思是把指针a看成指向char类型的指针(告诉编译器一段是1)。所以(char*)a + 1不是+2,还是+1。因为指针a指向的地址根本没变。仅仅是看成了char类型的指针后+1
函数入参为指针的时候,指针本身会有浅拷贝
void func(int* a){ cout << &a << endl; //打印指针的地址 cout << a << endl; //打印指针指向的变量的地址}
int main(){ int* ptr = new int(5); cout << &ptr <<endl; //打印指针的地址 cout << ptr << endl; //打印指针指向的变量的地址 func(ptr);}/*输出:0x61fe18 //指针地址0x1b1490 //变量地址0x61fdf0 //指针地址0x1b1490 //变量地址*/- 我们可以看到,指针入参后,指针本身会发生拷贝。会发生指针给指针赋值。也就是新建了一个指针指向了同一个地址,也就是浅拷贝。所以此时会有两个指针指向同一个地址。一个在
func函数内,一个在main里。
函数指针 和 回调函数
- 函数指针
typedef int(*ptr)(int, int); //typedef 定义别名ptr instance = add; //方法一 函数外直接生成示例并赋值。注意这里typedef之后直接把函数赋值过去即可。ptr test1;test1 = add; //这里是错的。函数体外只能进行全局函数和变量的声明,而无法执行语句或调用函数。
int add(int a, int b){ //不需要传入函数指针了。 cout << a+b << endl; return (a+b);}
int main(){ ptr test; //方法二 函数内进行分离声明 test = add; test(5,8);}- 回调函数
int add(int a, int b){ cout << a+b << endl; return (a+b);}
void callback(int(*ptr)(int,int), int a, int b){ //设立callback函数。传入函数指针和参数。 注意这里如果需要有值传出就要设置为返回int ptr(a, b);}
int main(){ callback(add, 5, 8);}- 回调函数 c++风格
void callback(int(*ptr)(int, int), int a, int b){ //回调函数 如果需要返回值就return ptr(a, b);}
class test{ public: static int add(int a, int b){ //需要被执行的函数。注意要static。要么就全局。 cout << a+b << endl; return (a+b); } void registure(){ //注册函数 callback(add, 3, 5); }
};
int main(){ test Test; Test.registure(); return 0;}- 回调函数 c++多态
class basecase{ public: virtual void testmsg() = 0; virtual ~basecase(){}; //虽然这里没什么卵用但是还是要记得虚析构,不然无法执行子类析构};
class case1 : public basecase{ //继承 public: void testmsg() override{ cout << "Case1 coutmsg" << endl; }};
class case2 : public basecase{ //继承 public: void testmsg() override{ cout << "Case2 coutmsg" << endl; }};
int main(){ basecase* test1 = new case1(); basecase* test2 = new case2(); test1->testmsg(); test2->testmsg(); delete test1; //养成良好习惯 delete test2; return 0;}注意c++中的类回调函数必须是静态函数或者是全局函数。
一般来说为了封装性质,我们需要把一个函数放入类内。但是调用类成员函数需要加this,也就是要通过对象调用。但我们不想这样做。于是想舍弃这个this的话就应该设置为static静态函数。静态函数就像一个全局函数一样,也就是带作用域的全局函数。满足我们的需求。
静态函数只能访问静态对象,想访问非静态数据怎么办?
我们可以把回调函数的入参设置为一个类对象的指针或者是一个void*类型的指针。然后通过这个入参来调用。
- 例子1:传入类对象指针
class A{ public: static void callback(A *pThis); //静态函数 void b(){ //非静态函数 cout <<"b" << endl; }};
void A::callback(A *pThis) //入参为类类型指针{ pThis->b(); //静态函数中调用非静态函数}int main(){ A* aptr = new A(); A::callback(aptr); //指针传入回调函数。 delete aptr; return 0;}- 例子2:传入this指针
class A{ public: static void callback(A *pThis); //静态函数 void b(){ //非静态函数 cout <<"b" << endl; } void in_class(){ callback(this); //直接传入this }};
void A::callback(A *pThis){ pThis->b(); //静态函数中调用非静态函数}int main(){ A* aptr = new A(); aptr->in_class(); delete aptr; return 0;}例子3:使用void*类型做为入参后强转。
class A{ public: static void callback(void *pThis); //静态函数 void b(){ //非静态函数 cout <<"b" << endl; } void in_class(){ callback(this); //直接传入this }};
void A::callback(void *pThis){ ((A*)pThis)->b(); //静态函数中调用非静态函数。强转}int main(){ A* aptr = new A(); aptr->in_class(); delete aptr; return 0;}