
C++杂记 - 3
std::bind, std::function 和 std::mem_fn
std::bind 包括但不限于mem_fn的功能,更为通用的解决方案
什么是bind?我们可以把它看作一个通用的函数适配器,它接受一个可调用对象,生成一个新的可调用对象来“适应”原对象的参数列表。
std::bind将可调用对象与其参数一起进行绑定**,绑定后的结果可以使用std::function保存**。std::bind主要有以下两个作用:
- 将可调用对象和其参数绑定成一个仿函数;
- 只绑定部分参数,减少可调用对象传入的参数。
语法:
auto newCallable = bind(callable, arg_list);该形式表达的意思是:当调用newCallable时,会调用callable,并传给它arg_list中的参数。
需要注意的是:arg_list中的参数可能包含形如_n的名字。其中n是一个整数,这些参数是占位符,表示newCallable的参数,它们占据了传递给newCallable的参数的位置。数值n表示生成的可调用对象中参数的位置:_1为newCallable的第一个待填充参数,_2为第二个待填充参数,以此类推。
注意这些占位符在std::placeholders名称空间内。
-
std::bind的返回值是可调用实体,可以直接赋给std::function。
-
bind绑定类非静态成员函数时,第一个参数表示对象的成员函数的指针,第二个参数表示对象的地址,这是因为对象的成员函数需要有this指针。并且编译器不会将对象的成员函数隐式转换成函数指针,需要通过&手动转换(符合成员函数指针的赋值语法)。静态成员函数无需此操作。因为没有this指针。
-
注意传入对象地址也可以传入对象的引用或对象本身。
-
在类内使用该类的成员函数的时候,和类外使用一样。都需要取地址并且传入对象指针。只不过可以使用
this替代。-
这个的常见案例是类内含有
thread的时候,比如这种情况: -
struct test{test():th1(bind(&test::threadfunc, this)){}; //因为是类内使用该类成员函数,所以需要绑定,但是可以使用this替代。~test(){if(th1.joinable()){th1.join();}}private:void threadfunc(){ //成员函数。cout <<"hello world" << endl;}thread th1;};int main(){test mytest;}
-
-
class my_class{ public: int val; my_class(int x):val(x){}
void getval(){ cout << val << endl; } void add(int another){ val = val + another; cout << val << endl; } static void staticfunc(int val){ cout << "static" << val << endl; }};int main(){ my_class obj1(10); auto task2 = bind(&my_class::getval, &obj1); //调用无参函数,this参数预绑定。成员函数指针遵循语法。 auto task3 = bind(&my_class::add, &obj1, placeholders::_1); //调用有参函数,this参数预绑定。 auto task4 = bind(&my_class::add, placeholders::_1, placeholders::_2); //调用有参函数,this参数使用占位形式。 auto task5 = bind(&my_class::staticfunc, placeholders::_1); //静态成员函数没有this指针。无需传入。 task2(); task3(3); task4(&obj1, 3); //this使用占位形式,需要调用时传入。 task5(3); return 0;}- 默认情况下,bind的那些不是占位符的参数会被拷贝或移动(以值传递)到bind返回的可调用对象中。如果需要使用引用传递,必须使用
ref
void mypred(int a, int b, vector<int>& c){ 尽管这里函数头使用了引用,但是bind在预绑定的时候(也就是非placeholder参数)默认会拷贝一份原参数进行传入,也就是默认是值传递。所以这里的容器c其实是一个局部变量。 if(a < b){ cout <<"yes" << endl; c.push_back(a);
}}
int main(){ vector<int> test = {1}; vector<int> final; final.reserve(10); for_each(test.begin(), test.end(), bind(mypred, placeholders::_1, 3, ref(final))); 所以这里我们如果要使用引用来传递final,则必须要使用ref函数来获取其引用。 for(auto i = final.begin(); i != final.end(); i++){ cout << *i << endl; } return 0;}使用std::bind搭配priority_queue 和 vector的自定义排序。
请参考STL-1笔记
慎用std::bind, 如果可能的话使用lambda
https://lefticus.gitbooks.io/cpp-best-practices/content/08-Considering_Performance.html
https://stackoverflow.com/questions/49246242/efficiency-of-stdbind-vs-lambda
mem_fn 成员函数适配器 把成员函数转为函数对象,使用对象指针或对象(引用)进行绑定
个人实验得出的结论:mem_fn是bind的子集。
注意mem_fn不能调用类静态成员函数。因为没有this指针。
mem_fn就是强制给你把类对象塞进去。
mem_fn无法接受额外参数。也就是无法使用placeholder
mem_fn的核心功能是把类成员函数转换成不需要类成员就可以调用的形式。就是把this指针绑定到类成员函数的隐藏this参数上。但是调用的时候依旧需要传入一个对象地址。。就很废物。
比较:
class my_class{ public: int val; my_class(int x):val(x){}
void getval(){ cout << val << endl; } void add(int another){ val = val + another; cout << val << endl; } static void staticfunc(int val){ cout << "static" << val << endl; }};int main(){ my_class obj1(10);
auto task1 = mem_fn(&my_class::getval); task1(&obj1); //把对象地址传入
auto task2 = mem_fn(&my_class::add); task2(&obj1, 5);
//auto task3 = mem_fn(&my_class::staticfunc); 错误!静态成员函数不行。
auto task1_1 = bind(&my_class::getval, placeholders::_1); //bind就得多写个参数 task1_1(&obj1);
auto task1_2 = bind(&my_class::getval, &obj1); task1_2();
return 0;}std::placeholders
我们提到了,我们使用bind的时候,placeholder是待填充参数。什么叫待填充?这是一种具象解释。其实bind相当于生成了一个新的可调用对象,拥有两个参数。但是结合原本的可调用对象来看,我们有三个参数。所以站在原本的可调用对象角度来看,这原来的可调用对象中多出来的一个参数相当于已填充参数。剩下的两个参数相当于待填充。
语法和例子:
void testfunc(int x, int y, int z){ cout << x << endl; cout << y << endl; cout << z << endl;}int main(){
auto callable1 = bind(testfunc, placeholders::_1, placeholders::_2, 5); callable1(8,80); //输出8 80 5 auto callable2 = bind(testfunc, placeholders::_2, placeholders::_1, 5); callable2(8,80); //输出80 8 5
auto callable3 = bind(testfunc, placeholders::_1, 5, placeholders::_2); callable3(8,80); //输出8 5 80 auto callable4 = bind(testfunc, placeholders::_1, 5, placeholders::_3); //错误。新的调用对象只有两个参数。这里3超了。并placeholders且必须按序。不可跨越。不能没有2的时候直接使用3,尽管可能待填充参数一共有3个。 callable4(8,80);
auto callable5 = bind(testfunc, placeholders::_1, 5, placeholders::_1); //极端情况。占位符可以重复。 callable5(8); //输出8 5 8}注意
placeholder编号必须按序。此处按序指的是不能没有2的时候直接使用3- 并且编号不能大于待填充参数的数量。
参考资料:https://elloop.github.io/c++/2015-12-15/learning-using-stl-12-std-bind
std::function
大家都用过函数指针。具体就不赘述了。稍微回忆一下函数指针的语法:
void(*another_a_ptr_ptr)(void) = (void(*)(void))*(long long*)(*a_ptr);void(*another_a_ptr_ptr)(void); 这个函数指针的类型是void(*)(void)成员函数指针的用法和声明在杂记2。
std::function是一个多态可调用对象包装器,是一个类模板,可以容纳除所有可调用对象(类成员函数和指针需要bind一下),它可以用统一的方式处理函数、函数对象、函数指针,lambda并允许保存和延迟它们的执行。基本上任何有函数调用运算符重载operator()的对象都可以被function包装。
注意,std::function支持多态。
一个例子让你知道function怎么用:
int myfunc(int a){ cout << a << endl; return a;}
int myfunc1(const int& a){ cout << a << endl; return a;}
int myfunc2(int&& a){ cout << a << endl; return a;}
int main(){ function<int(int)> func = myfunc; func(4);
function<int(const int&)> func1 = myfunc1; func1(4);
function<int(int&&)> func2 = myfunc2; func1(4);
return 0;}说白了就是类型是你的函数返回值类型+参数类型。
因为std::function可以保存lambda。所以当函数签名的参数是std::function对象的时候,可以直接传入一个类型匹配的lambda对象。有隐式类型转换
我们前面提到过 bind的返回值是可调用实体,可以直接赋给std::function
function<void(void)> task1_2 = bind(&my_class::getval, &obj1);task1_2();
function<void(int)> task2 = bind(&my_class::add, &obj1, placeholders::_1);task2(5);有一个问题是,这里必须要显式把对象地址直接塞进去,不能把对象地址用占位符。因为参数对不上了。(个人实验)
故而,std::function的作用可以归结于:
- std::function对C++中各种可调用实体(普通函数、Lambda表达式、函数指针、以及其它函数对象等)的封装,形成一个新的可调用的std::function对象,简化调用;
- std::function对象是对C++中现有的可调用实体的一种类型安全的包裹(如:函数指针这类可调用实体,是类型不安全的)。
慎用std::function 性能极差
虚函数的开销是常规函数的5倍,std::function是6倍以上。
原因是std::function的底层还是使用虚函数,进行多态调用。因为使用了类型擦除。同时,std::function是通用的,并且它不知道包装的可调用对象多大(比如lambda就是动态大小的,我们在lambda一节中提到了lambda的大小取决于捕获参数的数量和方式)。但是可调用对象必须要被std::function所保存,这样才能在std::function对象被移动或复制的时候正确的移动或复制。它的内部有一个缓冲区。如果可调用对象足够小,则不需要新开内存。所以当可调用对象大于某个阈值的时候,它需要使用动态内存分配来存储。同时,有几种方法可能避免。比如使用std::ref包装参数,或者在使用lambda函数初始化std::function对象时,对应的lambda可以使用引用捕获参数避免lambda的大小膨胀。
https://wizmann.tk/cpp-type-erasure-and-std-function.html
https://stackoverflow.com/questions/5057382/what-is-the-performance-overhead-of-stdfunction
https://stackoverflow.com/questions/18453145/how-is-stdfunction-implemented
https://blog.demofox.org/2015/02/25/avoiding-the-performance-hazzards-of-stdfunction/
关于std::function和多态
std::function既然叫做多态函数包装器,那么就可以正确处理多态。
class father{ public: father()= default;
virtual void func(){ cout <<"father" << endl; }};
class child:public father{ public: child() = default; void func(){ cout << "child" << endl; }};int main(){
father* fptr = new child; function<void(void)> funcobj = bind(&father::func, fptr); funcobj(); //输出child return 0;}关于源码解析
脸都看绿了。
https://blog.csdn.net/zdy0_2004/article/details/50652934
https://blog.csdn.net/weixin_43798887/article/details/116571325
在函数中传递std::function对象,搭配bind并考虑使用placeholders。
为了方便起见。此处仅使用全局函数为例。
void test(int a, int b, const string& c){ cout << a << b << c << endl;}
void funcinput(function<void(int, int, const string&)> in_func){//注意函数入参签名 in_func(1,2,"abc");}
void another_funcinput(function<void(int, const string&)> in_func){ //注意函数入参签名 in_func(2,"abc");}int main(){ funcinput(bind(&test, placeholders::_1, placeholders::_2, placeholders::_3)); //输出12abc another_funcinput(bind(&test, 1, placeholders::_1, placeholders::_2));//输出ab123 return 0;
}我们打算将std::function对象传入函数。
注意在搭配bind使用的时候。注意function的类型。[下方例子全部忽略第一个实际参数(为函数地址)]。function的类型为函数返回类型+除预先绑定的参数以外的全部参数类型(所有placeholders代表的类型)。
- 在
bind(&test, placeholders::_1, placeholders::_2, placeholders::_3)的时候,由于三个参数全部为placeholders,所以此时function的类型为目标函数的返回值类型+全部参数类型。为function<void(int, int, const string&)>。 - 在
(bind(&test, 1, placeholders::_1, placeholders::_2)的时候,由于第一个参数为预绑定,只有两个placeholders,所以此时function的类型为目标函数的返回值类型+除第一个外,也就是剩余的参数类型。为function<void(int, const string&)>
一个稍微复杂的包裹类练习。使用了模板和bind
我们这一段代码的目的是想简单模拟一下unique_ptr调用自定义删除器的过程。
class myInt{ public: int val1; myInt() = default; //要点1 myInt(int x):val1(x){} void operator()(int a){ //要点2 cout << a <<endl; cout <<"called" << endl; }
};void global_func(int x){ cout << x << endl; cout <<"global" << endl;}template<typename T1, typename T2>class anotherone{ public: T1 callable; //要点3 T2 value; anotherone() = default; anotherone(T2 val):value(val){} //要点4 anotherone(T1 func, T2 val): callable(func), value(val){} //要点5 void operator()(){ callable(value); }};int main(){ myInt tests; //要点6 auto objbind = bind(&myInt::operator(), &tests, placeholders::_1); //要点7 typedef decltype(objbind) mytype; //要点8 anotherone<mytype, int> myobj2(objbind, 200); //要点9 T1是bind类型 anotherone<myInt, int> myobj(234); //要点10 T1 是 myInt类型 myobj2(); myobj();
anotherone<void(*)(int), int> myobj3(global_func, 345); myobj3(); return 0;}- 要点1
myInt必须提供默认构造。原因是我们的anotherone在不接受函数对象做为可调用对象的时候,会利用第一个模板参数的类型构建一个 第一个模板参数类型的对象。也就是myInt对象。如果没有默认构造则会失败 - 要点2
operator()没有固定实现。返回值可以依靠不同需求做决定 - 要点3等同于要点1。在不接受函数对象做为可调用对象的时候,这个东西是第一个模板参数的类型的对象。然后我们会调用这个对象的
operator()来进行调用。如果是一个可调用对象,则利用这个可调用对象进行调用。比如bind和function或函数指针。 - 要点4是为了匹配不提供调用对象只提供类型的情况
- 要点5是为了匹配提供调用对象的情况
- 要点6和要点7是bind成员函数的时候必须传入一个对象地址做为this指针
- 要点8是因为我们必须要显式指明类型,所以要有一个decltype辅助我们判断类型。
- 要点9和要点10就是实际模拟传入一个可调用对象或不传入可调用对象,只通过类型进行调用。
lambda, bind和function的简单准则
在性能关键点,一定要避免使用std::function或函数指针调用函数。尽可能避免使用bind和lambda。如果一定要使用,优先选择lambda,其次是bind,然后是函数指针,最后才是std::function。
https://stackoverflow.com/questions/49246242/efficiency-of-stdbind-vs-lambda
std::call_once 和 std::once_flag
原型:
template< class Callable, class... Args >void call_once( std::once_flag& flag, Callable&& f, Args&&... args );通过call_in_once执行的可调用对象可以保证在多线程的状态下仅被(一个线程)执行一次
once_flag my_flag1; //这个flag是一次性使用的。必须要全局。而且如果有两个东西需要call_once就要两个flagonce_flag my_flag2;void func1(){ cout <<"func1" << endl;}
void func2(int s){ cout <<"func2" << s << endl;}void thread_exe(){ //once_flag my_flag1; //错误 放在这里就是线程函数的局部变量。这样每个线程就会有自己的flag //once_flag my_flag2; call_once(my_flag1, func1); call_once(my_flag2, func2, 1);}
int main(){ thread mythread1(thread_exe); thread mythread2(thread_exe); mythread1.join(); mythread2.join();
return 0;}注意事项:
once_flag对象对于所有线程来说应该是全局变量(或等同于全局变量的形式)。因为once_flag对象只能被使用一次。如果是局部变量,则放在这里就是线程函数的局部变量。这样每个线程就会有自己的once_flag对象,就无法起作用。- 因为每一个
once_flag对象是一次性的。所以如果有两个东西需要call_once就要两个once_flag对象 - 当
flag没有标记为done,所有线程都会阻塞在once_flag这里,此时:- 如果某个
Callable抛出异常,则call_once会选择下一个等候的线程重新执行call_once动作。 - 如果成功执行了
Callable,解除所有等候线程的阻塞并给flag标记为done。
- 如果某个
参考:https://blog.csdn.net/qq_31175231/article/details/77916028
异步API。std::future, std::promise, std::packaged_task, std::async
想要进行多线程编程,这四个看起来高级的API是必不可少的。我们来看一看这一套异步编程套组里的四个组件到底有什么关系,他们是干什么的。
参考资料:https://segmentfault.com/a/1190000039201271
https://murphypei.github.io/blog/2019/04/cpp-concurrent-4
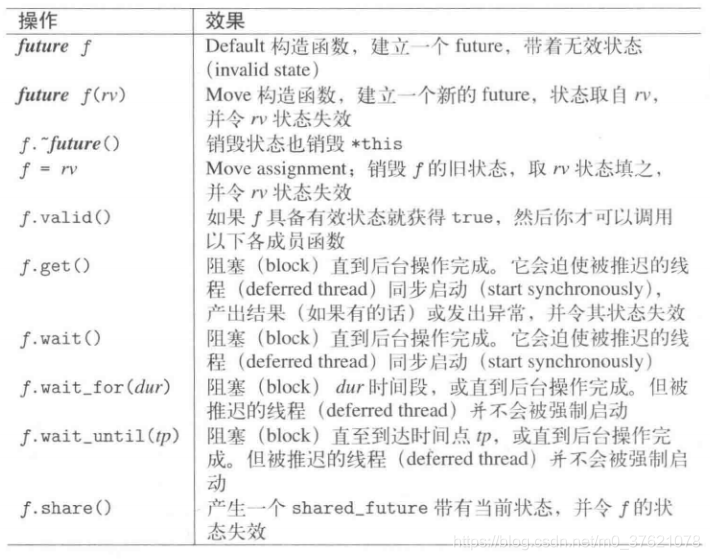
std::future / std::shared_future
< future >头文件功能允许对特定提供者设置的值进行异步访问,可能在不同的线程中。
这些提供程序(要么是promise 对象,要么是packaged_task对象,或者是对异步的调用async)与future对象共享共享状态:提供者使共享状态就绪的点与future对象访问共享状态的点同步。
上面这段话翻译过来就是我们可以理解为future是一个时间胶囊, 一个对象**。这个对象的提供程序(如promise)里面储存了我们希望以后拿到的东西。然后我们用future来和提供程序连接起来,一旦共享状态转变为就绪,就可以拿到提供程序里面的东西。**
- 所以说,future对象提供了一种让我们访问异步操作的结果的机制。
我们看一下future的正式定义和具体细节。
- future 是一个对象,可以从某个提供对象或函数中检索值,如果在不同线程中,则可以正确同步此访问。
- future的模板参数类型是其异步操作结果的类型。
- 它提供了一种访问异步操作结果的机制。从字面意思上看它表示未来,这个意思就非常贴切,因为它不是立即获取结果但是可以在某个时候以同步的方式来获取结果。我们可以通过查询
future的状态来获取异步操作的结果。future_status有三种状态:- **
deferred:**异步操作还未开始。共享状态包含一个延迟函数,因此只有在明确请求时才会计算结果。(主要用于async函数的std::launch::deferred参数。) (共享状态持有的函数正在延迟运行,结果将仅在显式请求时计算) - **
ready:**异步操作已经完成(共享状态就绪) timeout:异步操作超时。在指定的超时持续时间过去之前,共享状态尚未准备好。(共享状态在经过指定的等待时间内仍未就绪)
- **
- “有效” future 对象,只能通过调用以下函数之一来构造:
asyncpromise::get_futurepackaged_task::get_future
- 默认构造的 future 对象是无效的(除非移动(move)分配一个有效的 future)。
- 在有效的 future 上调用
future::get会阻塞线程,直到提供程序准备好共享状态(通过设置值或异常)。这样,两个线程可以通过一个线程同步,等待另一个线程设置值。get()调用会改变其共享状态,不再可用,也就是说get()只能被调用一次,多次调用会触发异常。如果想要在多个线程中多次获取产出值需要使用shared_future。
- 共享状态的生存期至少要持续到与之关联的最后一个对象释放它或销毁它为止。因此,如果与 future 相关联,共享状态可以在最初获得它的对象(如果有的话)之后继续存在。
什么叫共享状态? — 整理自EMC++ 条款38
我们先来思考一下。我们知道了,我们可以通过promise,packaged_task拿到一个future对象。future对象是一个句柄,用于让我们访问异步操作的结果。在我们的直观想象中,可能调用方和被调用方的关系是这个样子:
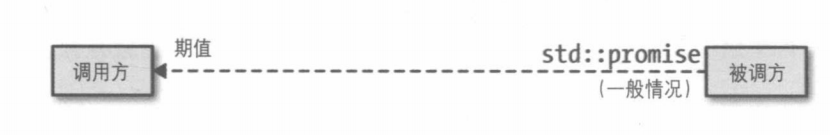
- 这时候有了第一个问题。被调用方的结果储存在哪比较好?在调用方使用
get之前,可能这个异步操作已经执行完毕。同时,我们只能给promise设定值,而不能从promise中获取值。因此结果不会储存在被调用方的promise对象中。 - 同时,这个结果也不能存在调用方的
future对象中。因为我们可能通过future对象创建其他的shared_future对象。而shared_future对象可能会有多个。那么这么多对应同一个结果中的future对象中,哪一个应该包含结果呢?
所以future和结果应该储存在两个位置。这个位置被称之为共享状态。共享状态通常使用堆上的对象来表示,但是其型别、接口和实现标准皆未指定。标准库作者可以自由地用他们喜好的方法去实现共享状态。
所以说,调用方和被调用方的关系是这个样子:
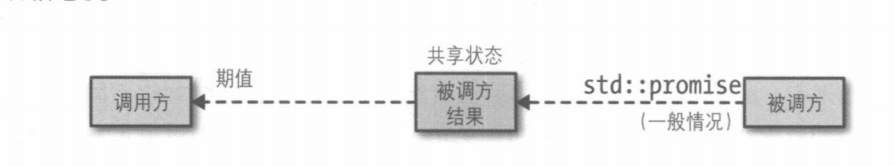
共享状态是有引用计数的。future,~packaged_task和promise对象的析构函数对其负责。所以在一些情况下,future对象的析构函数会由于共享状态的原因被阻塞。请查看async部分。同时部分资料来自这里
- 但是注意,只有
future对象的析构会阻塞,其他的不会。因为剩下两个对象的析构函数是抛弃(abandon)共享状态。而future对象的析构是释放(release)共享状态。
关于到底什么是共享状态,这个答案不太好。https://stackoverflow.com/questions/62241240/how-to-comprehend-stdfuture-shared-state
future::valid()
检查有效的共享状态
- 返回 future 对象当前是否与共享状态关联。
- 对于默认构造的 future 对象,此函数返回 false (除非将有效的 future 分配给移动对象)。
- future 只能由某些提供函数(如,
async,promise::get_future或packaged_task::get_future)使用有效的共享状态进行初始化。 - 一旦使用 future::get 检索了共享状态的值,则调用此函数返回 false (除非移动分配了一个新的 future).
返回值
- 如果对象与共享状态关联,则为 ture。
- 否则为假。
特别注意。返回值为true不代表此时共享状态已经就绪。只能表明对象与共享状态关联。
future::wait
阻塞并等待共享状态就绪(结果可用)
future::get
可以理解为包含了wait的操作。因为他调用了wait。
阻塞并等待共享状态就绪(结果可用),返回存储在共享状态中的值(或引发其异常)
- 当共享状态就绪时,返回存储在共享状态中的值(或引发其异常)。
- 如果共享状态尚未准备好(即提供程序尚未设置其值或异常),则该函数将阻塞调用线程直到准备就绪。在此前,调用了get的函数不会返回。
- 共享状态就绪后,该函数将取消阻塞并返回(或引发异常)以释放其共享状态。这时 future 对象不再有效:对于每个 future 的共享状态,此成员函数最多应被调用一次。
- 提供者准备好共享状态和返回此函数之间是同步的。
shared_future
std::shared_future 与 std::future 类似,但是 std::shared_future 可以拷贝、多个 std::shared_future 可以共享某个共享状态的最终结果(即共享状态的某个值或者异常)。shared_future 可以通过某个 std::future 对象隐式转换(参见 std::shared_future 的构造函数),或者通过 std::future::share() 显示转换,无论哪种转换,被转换的那个 std::future 对象都会变为 not-valid。std::shared_future 的成员函数和 std::future 大部分相同,这个地方就不一一展开了,需要的请查阅官方文档。
我们可以看到,想要创建一个有效的future对象必须依靠剩下的三个API。我们就来进一步看看剩下的几块内容。
std::promise
promise是剩下三个当中最为“原始,底层“的API。
promise 本质是一个类似我们打印输出中占位符的东西,你可以理解它就是一个等待数据装填的坑,它是一个“承诺”,承诺未来会有相应的数据(模板实现)。因为这是一个“承诺”,所以创建的时候是没有东西的,所以我们需要知道这个异步操作什么时候能有东西,好实现“承诺”,所以 promise 可以通过调用 get_future() 返回一个 future 对象,让你去了解这个承诺是否完成了。因此,promise 是存放异步操作产出值的坑,而 future 是从其中获取异步操作结果,二者都是模板类型。
这里理解为我们的future对象是一个接口,建立起与promise对象的联系。我们使用promise对象来进行异步操作,所以能看到我们并不需要把future对象传入线程。但是我们会通过future对象去获知这个异步操作的结果是否就绪,也就是promise对象是否已经包含了我们期望的结果。然后我们可以通过future来获取结果。通过搭配future和promise,我们可以安全的进行线程间通信,不需要显式同步
promise和future就是一个异步操作的两个端点。我们把结果储存在promise,然后通过future提取。
promise是一个对象,由future对象(可能在另一个线程中)检索,并提供一个同步点。- 通过调用成员
get_future,可以将该共享状态与future对象关联。 调用之后,两个对象共享相同的共享状态:promise对象是异步提供程序,应在某个时候为共享状态设置一个值。set_valuefuture对象是一个异步返回对象,可以检索共享状态的值,并在必要时等待其准备就绪。- 理解为我们通过
promise的get_future来创建我们的future对象。之后通过future对象(来检索)获得一个共享状态(结果)。 - 注意 每个
std::promise对象只应当使用一次。
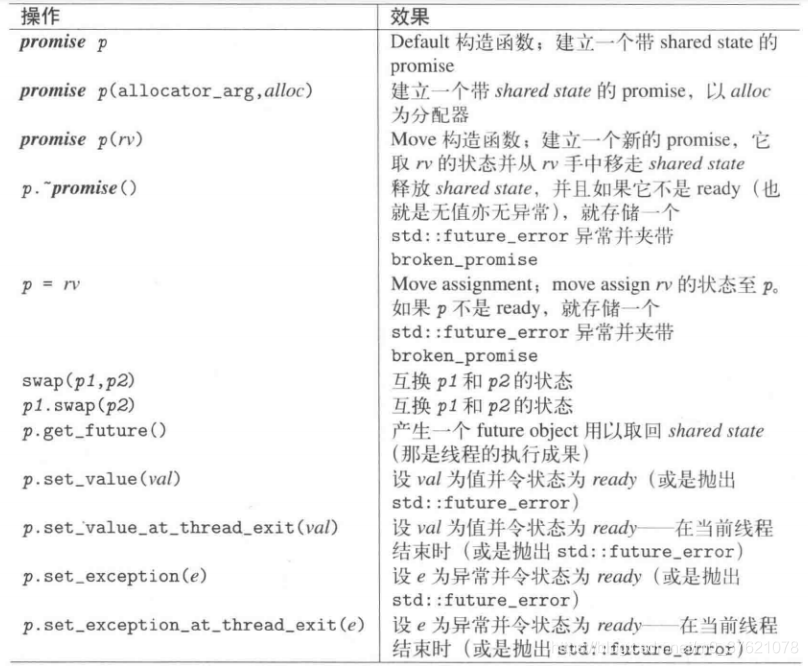
promise::set_value
- 以原子方式将值存储到共享状态(就是把promise对象储存的值设置好),并且改变该状态变为就绪状态。(设置共享状态)
- 如果与同一共享状态关联的future对象当前正在等待对
future::get的调用,则它将取消阻塞并返回val。- 因为future的get/wait会阻塞等待共享状态被设置完毕。
看看简单代码例子:
//使用promise进行异步void accumulate2(std::vector<int>::iterator first, //注意不太需要返回值了。因为异步返回的值被储存在了promise对象中 std::vector<int>::iterator last, std::promise<int> accumulate_promise) //函数头要有promise对象定义。{ int sum = std::accumulate(first, last, 0); accumulate_promise.set_value(sum); // 将结果存入,并让共享状态变为就绪以提醒future //如果不set_value,那么调用了future::get/wait的线程将一直被阻塞。}
int main(){ // 演示用 promise<int> 在线程间传递结果。 std::vector<int> numbers = { 1, 2, 3, 4, 5, 6 }; std::promise<int> accumulate_promise; //声明promise对象 std::future<int> accumulate_future(accumulate_promise.get_future()); //通过promise对象的get_future来初始化(获取)future对象
std::thread work_thread(accumulate2, numbers.begin(), numbers.end(), std::move(accumulate_promise)); //启动线程。设置好执行函数和传入参数。注意必须要把promise对象一并传入(移入) //!这里也可以用ref。但是我们accumulate2的函数头要了个值。promise又禁用了拷贝构造所以这里目前只可以move。如果accumulate2函数头改为&就可以用ref // !可以用ref但是不推荐。因为如果你不转移所有权,万一你多个线程并发访问了promise,可能会有问题, !而且这也不符合设计,一般来说只应该让一个线程持有promise //accumulate_future.wait(); //等待结果 这个可以去掉,直接用get就可以
std::cout << "result=" << accumulate_future.get() << '\n'; //get阻塞住等待共享对象变为ready。然后获取结果。 work_thread.join(); //阻塞等待线程执行完成
getchar(); return 0;}std::packaged_task
packaged_task比promise高级一点。直观来看就是参数少一点,操作少一点。稍后我们会有一个简单的对比。
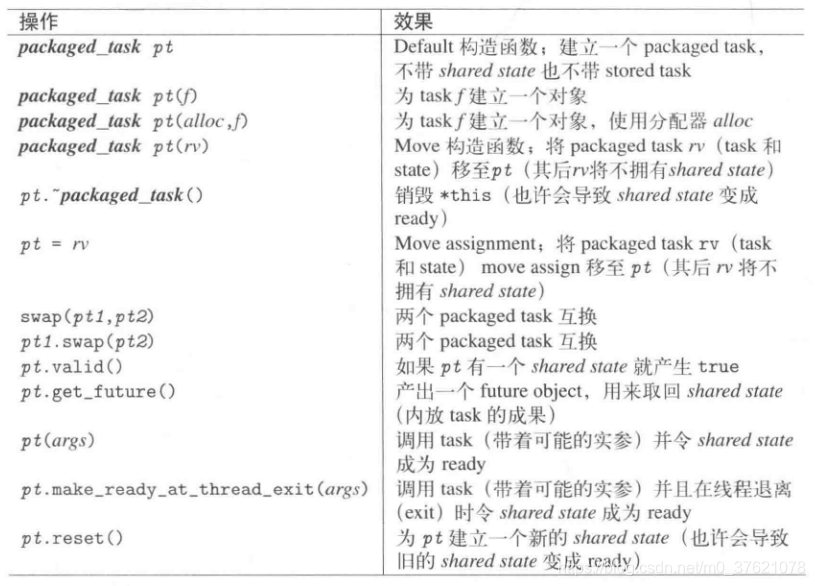
packaged_task 是对一个任务的抽象,我们可以给其传递一个函数来完成其构造。相较于 promise,它应该算是更高层次的一个抽象,同样地,我们可以将任务投递给任何线程去完成,然后通过 packaged_task::get_future() 方法获取的 future 对象来获取任务完成后的产出值。总结来说,packaged_task 是连数据操作(比如set_value)都封装进去了的 promise。packaged_task 也是一个类模板,模板参数为函数签名,也就是传递函数的类型。
template <class T> packaged_task; // undefinedtemplate <class Ret, class... Args> class packaged_task<Ret(Args...)>;- std::packaged_task包装可调用对象,并允许异步检索其结果。(可调用对象是重点)
- 类似于 std::function, 但是会自动将其结果传输到 future 对象。
- 对象内部包含两个元素:
- 存储的任务是一些可调用对象(例如,函数指针,成员或函数对象的指针),其调用签名应采用 Args… 中类型的参数,并返回 Ret 类型的值。
- 共享状态,该状态能够存储调用存储的任务(类型为 Ret)的结果,并且可以通过 future 来异步访问。
- 通过调用成员 get_future 将共享状态与 future 对象关联。调用之后,两个对象共享相同的共享状态:
- packaged_task 对象是异步提供程序,通过调用存储的任务,可以在某个时刻将共享状态设置为就绪。
- future 对象是一个异步返回对象,可以检索共享状态的值,并在必要时等待其准备就绪。
看看代码实例,做一下比较:
//? 使用packaged_task进行异步int accumulate(std::vector<int>::iterator first, std::vector<int>::iterator last) //注意函数头,我们没有像promise那样需要传入promise对象。{ int sum = std::accumulate(first, last, 0); return sum; //所以也不需要promise的set_value}
int main(){ // 演示用 packaged_task 在线程间传递结果。 std::vector<int> numbers = { 1, 2, 3, 4, 5, 6 }; std::packaged_task<int(std::vector<int>::iterator,std::vector<int>::iterator)> accumulate_task(accumulate); //创建packaged_task对象。注意这里有区别,下面详说。 std::future<int> accumulate_future = accumulate_task.get_future(); //通过packaged_task对象的get_future来创建future对象 std::thread work_thread(std::move(accumulate_task), numbers.begin(), numbers.end()); //启动线程。注意这里有区别了。 /* @ 使用move的主要原因还有一个就是按值传递函数参数会调用拷贝构造。packaged_task禁用了拷贝构造,要么传引用要么换成右值引用转移所有权。 */ //accumulate_future.wait(); //等待结果 可以和下面的get合并 std::cout << "result=" << accumulate_future.get() << '\n'; work_thread.join(); //阻塞等待线程执行完成
getchar(); return 0;}我们来说一说几点具体区别
-
我们提到了,
packaged_task包装的是可调用对象。但是promise仅仅是一个包装着异步执行结果的对象。所以:packaged_task对象的模板类型是函数签名,因为他包装了可调用对象。- 所以线程执行的时候只需要移入
packaged_task对象即可,无需传入函数本身。因为已经被包装了。 - 所以包装的函数无需额外参数,函数内无需额外动作。
- 因为
promise会储存异步任务的结果,所以函数的返回值可以去掉。
-
其实理解了上面那一点,就理解了
packaged_task和promise的区别。可以简单理解为promise是一个包装了执行结果的对象。而packaged_task是一个包装了整个任务的对象,它不仅包装任务执行结果,而且包装任务本身。 -
注意它的模板头参数
template <class _Ret, class... _ArgTypes>class packaged_task<_Ret(_ArgTypes...)>这样做的目的是让它的类型看起来更像函数。
std::async
async是最高级的一个API,代码简单,比较高层。它其实是封装了thread 和 packged_task的功能,使异步执行一个任务更为方便
async是函数模板,不是类模板。
unspecified policy (1)template <class Fn, class... Args> future<typename result_of<Fn(Args...)>::type> async (Fn&& fn, Args&&... args);
specific policy (2)template <class Fn, class... Args> future<typename result_of<Fn(Args...)>::type> async (launch policy, Fn&& fn, Args&&... args);- 异步调用函数在某个时刻调用
fn(以args作为参数),返回时无需等待fn执行完成。(都说了是异步) - 可以通过返回的 future 对象(通过调用其成员
future::get)来访问fn返回的值。 - 第二个版本 (2) 允许调用者选择特定的启动策略,而第一个版本 (1) 使用自动选择,就好像调用 (2) 并将
launch::aysnc | launch::deferred作为策略。 - 该函数在共享状态下临时存储使用的线程处理程序。一旦完成 fn 的执行,共享状态将包含 fn 返回的值并准备就绪。
| launch::async | 启动一个新的线程以调用 fn (就像使用 fn 和 args 作为参数构造线程对象,并访问返回的 future 的共享状态将其联接)std::thread(std::forward<F>(f), std::forward<Args>(args)...) |
|---|---|
| launch::deferred | 意味着函数可能只会在std::async返回的future对象调用get或wait时执行。(函数在future对象调用了get或wait的时候才会开始执行)。**不会产出新的线程。该任务会在调用线程中执行。**当调用get或wait时,函数会同步执行,即调用者会阻塞直到函数运行结束。如果get或wait没有被调用,函数就绝对不会执行。 |
| launch::async | launch::deferred | 该功能自动(在某个时候)选择策略。这取决于系统和库的实现,他们通常会针对系统中当前的并发可用性进行优化 |
看一下细节
//? 使用async进行异步
int accumulate3(std::vector<int>::iterator first, std::vector<int>::iterator last){ std::cout <<"async begin" << std::endl; int sum = std::accumulate(first, last, 0); std::cout <<"async end" << std::endl; return sum;}
int main(){ std::cout <<"main begin" << std::endl; std::vector<int> numbers = { 1, 2, 3, 4, 5, 6 }; std::future<int> accumulate_future = std::async(std::launch::async, accumulate3, numbers.begin(), numbers.end()); //ver1 std::future<int> accumulate_future = std::async(std::launch::deferred, accumulate3, numbers.begin(), numbers.end()); //ver2 Sleep(50); //睡眠五秒 std::cout << "result=" << accumulate_future.get() << '\n'; std::cout <<"main end" << std::endl; return 0;}ver1 输出:main beginasync beginasync endresult=21main end
ver2 输出:main beginresult=async beginasync end21main end调用方式和thread很像,没什么区别。没有花里胡哨的东西。但是注意下细节。
- 在async模式中,一旦开始了调用,则会立刻创建子线程开始任务执行。所以我们看到尽管主线程睡眠了一下,但是并不影响异步线程的执行。所以async begin, async end和result=21是可以打印的。因为get的时候任务已经完成(或者是阻塞至任务完成)。
- 在deferred模式中,只有get/wait调用的时候任务才开始执行。所以result=先打印出来,然后直到调用get函数的时候,才开始执行任务,任务执行完毕后结果才能拿到,所以会先打印result=, 然后在调用线程(此处是主线程)中执行函数,拿到结果后打印21。
- 传参的时候如果需要使用只支持移动的参数比如unique_ptr,则必须使用move显式移动。
unique_ptr<int> testfunc(unique_ptr<int> ptr){ *ptr = *ptr + 1; return ptr;}
int main(){ unique_ptr<int> myptr = make_unique<int> (5); future<unique_ptr<int>> my_future = async(std::launch::async, testfunc, move(myptr)); //显示使用move转移所有权。 cout << *(my_future.get()) << endl; return 0;}- 如果async函数的返回值没有一个东西接住他(显式获取返回值),因为async会创建临时的future对象, 所以这个临时对象的析构函数会阻塞住调用线程直至异步线程执行完毕。因为我们不能让异步线程返回值的时候,这个临时对象已经被销毁了。
例子:
unique_ptr<int> testfunc(unique_ptr<int> ptr){ *ptr = *ptr + 1; sleep(5); //睡眠五秒 return ptr;}
int main(){ unique_ptr<int> myptr = make_unique<int> (5); cout << "running" << endl; async(std::launch::async, testfunc, move(myptr)); //卡在这里5秒。因为没有获取返回值。直到任务完成后赋值给临时future对象之后才能执行future临时对象的析构。 cout <<"blocked" << endl; return 0;}这段代码执行的时候,调用线程会由于异步线程没有执行完毕,而且因为没有获取返回值,所以卡在async这行。直到异步线程执行完毕后赋值给临时future对象之后才能执行future临时对象的析构。才会继续输出blocked。
- 如果async函数的返回值有
future对象接住他(显式获取返回值),而且没有对future对象用使用get来阻塞主线程,因为满足下面的条件,所以主线程依旧会等待异步线程结束。因为该future对象的析构函数被阻塞了- 注意:此条件仅限于如下条件为真:
future对象以std::async的调用创建,且共享状态仍未就绪,且this是到共享状态的最后引用。- 最后面那个条件原文是:this was the last reference to the shared state. 我的理解其实是:这个
future对象是async调用创建的那个对象的最后的引用。- 也就是如果当前的
future对象此时是async调用创建的那个future对象,唯一与其有关联的实例。
- 也就是如果当前的
- 最后面那个条件原文是:this was the last reference to the shared state. 我的理解其实是:这个
- 注意:此条件仅限于如下条件为真:
int accumulate3(std::vector<int>::iterator first, std::vector<int>::iterator last){ std::cout <<"async begin" << std::endl; int sum = std::accumulate(first, last, 0); sleep(5); //异步线程睡眠5秒 std::cout <<"async end" << std::endl; return sum;}
int exe(){ std::cout <<"exe begin" << std::endl; std::vector<int> numbers = { 1, 2, 3, 4, 5, 6 }; std::future<int> accumulate_future = std::async(std::launch::async, accumulate3, numbers.begin(), numbers.end()); //通过async调用创建的future对象,且共享状态仍未就绪,且除了这个future对象以外,没有其他的对共享状态的引用。所以会阻塞。 //std::cout << "result=" << accumulate_future.get() << '\n'; 没有对`future`对象用使用`get`来阻塞主线程 std::cout <<"exe end" << std::endl; return 200;}
int main(){ int a = exe(); cout << a << endl; return 0;}/*输出:exe beginexe endasync begin(睡眠五秒...)async end200*/我们可以看到,启用了异步线程,并且有future对象做为返回值,所以没有阻碍临时对象的析构。同时我们没有对future对象用使用get来阻塞主线程。但是虽然exe end被打印,但是因为满足上面的条件,所以该future对象的析构函数被阻塞了,这个调用线程依旧会被阻塞。所以这个函数的执行没有结束,所以main函数内的函数调用不会返回。所以调用线程依旧会等待异步线程结束而结束。
- 这种阻塞行为可以理解为该future临时对象的析构函数是对底层异步执行任务的线程实施了一次隐式的
join—emc++ 条款38- 在future的析构函数不被阻塞时(不满足上述条件的时候),可以理解为对底层线程实施了一次隐式的
detach。
- 在future的析构函数不被阻塞时(不满足上述条件的时候),可以理解为对底层线程实施了一次隐式的
future, packaged_tast, promise三者的关系
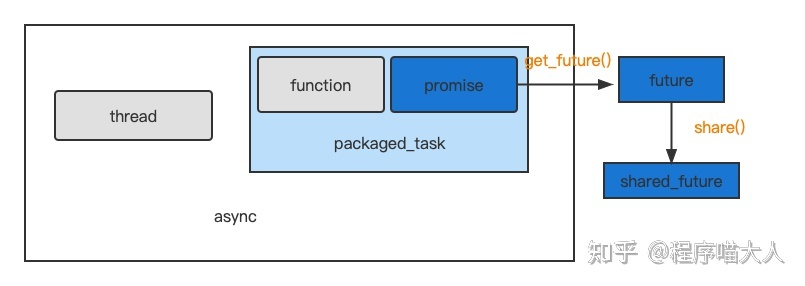
std::future用于访问异步操作的结果,而std::promise和std::packaged_task包住了future,它们内部都有一个future,promise包装的是一个值,packaged_task包装的是一个函数(异步操作本身),当需要获取线程中的某个值,可以使用std::promise,当需要获取线程函数返回值,可以使用std::packaged_task。
这三个东西和async都是互相搭配使用的。具体在哪个线程阻塞,哪个线程获取,哪个先哪个后,包括是传引用还是move都是依照情况而定的。
- packaged_task ≈ promise + function
- async ≈ thread + packaged_task
- 通过promise的get_future()可拿到future
- 通过future的share()可拿到shared_future
杂项
- std::future提供访问异步操作结果的机制。std::future 只能与指定事件相关联,而 std::shared_future 就能关联多个事件。future对象本身并不提供同步访问(需要使用get/wait)。future的get()函数的设计包含移动语义,即只能调用一次,第二次调用时会报异常。shared_future的get()函数的设计包含复制语义,可以多次调用。std::shared_future对象可以通过std::future对象隐式转换,也可以通过显示调用std::future::share显示转换,在这两种情况下,原std::future对象都将变得无效。
- 当不着急让任务结果时,可以使用 std::async 启动一个异步任务。std::async 会返回一个 std::future 对象。get()等价与先调用wait()再调用get()。 std::launch::defered 表明函数调用延迟到wait()或get()函数调用时才执行,std::launch::async 表明函数必须在其所在的独立线程上执行。
- std::packaged_task<> 会将future与函数或可调用对象进行绑定。当 std::packaged_task 作为函数调用时,实参将由函数调用操作符传递至底层函数,并且返回值作为异步结果存储在 std::future 中。
- std::promise/std::future 对提供一种机制:future可以阻塞等待线程,提供数据的线程可以使用promise对相关值进行设置,并将future的状态置为“就绪”。
- 任何情况下,当future的状态还不是“就绪”时,调用 std::promise 或 std::packaged_task 的析构函数,将会存储一个与 std::future_errc::broken_promise 错误状态相关的 std::future_error 异常。
- 当调用抛出一个异常时,这个异常就会存储到future中,之后调用get()会抛出已存储的异常。
- std::current_exception() 来检索抛出的异常,可用 std::copy_exception() 作为替代方案, std::copy_exception() 会直接存储新的异常而不抛出。
- 因为 std::future 是只移动的,所以其所有权可以在不同的实例中互相传递,但只有一个实例可以获得特定的同步结果,而 std::shared_future 实例是可拷贝的,所以多个对象可以引用同一关联期望值的结果。
- 当多线程 在没有额外同步的情况下,访问一个独立的 std::future 对象时,就会有数据竞争和未定义的 行为。这是因为: std::future 模型独享同步结果的所有权,并且通过调用get()函数,一次性 的获取数据,这就让并发访问变的毫无意义——只有一个线程可以获取结果值,因为在第一 次调用get()后,就没有值可以再获取了。
- 在每一个 std::shared_future 的独立对象上成员函数调用返回的结果还是不同步的,所以为 了在多个线程访问一个独立对象时,避免数据竞争,可以使用两种方式:
- 锁
- 每一个线程有自己的shared_future对象,然后都通过自己的这个shared_future对象来获取结果。
async future搭配数组进行多线程accumulate的小例子
struct custom_acc{ int operator()(int a, future<int>& b){ //使用自定义累加。注意第一个参数是int。因为是把第二个参数作用域第一个参数上 //其次,这里future不要忘记指定模板参数。 //第三,这里future对象不可设置为const。因为get参数会更改future的内部状态。所以get不是const函数。const对象不能调用非const函数 return a + b.get();//使用get取出计算结果。 }};
int acc_calc(std::vector<int>::iterator begin_iter, std::vector<int>::iterator end_iter){ return std::accumulate(begin_iter, end_iter,0); //这里老规矩。和async解析一样。任务函数。}
int main(){ vector<int>my_vec(2000, 3); //要计算的数组 vector<future<int>> my_futures; //装有future对象的数组 int curpos = 0; for(int i = 0; i < 10; i++){ my_futures.emplace_back(std::async(std::launch::async, acc_calc, my_vec.begin()+curpos, my_vec.begin()+curpos+200)); //这里我们在future对象数组内原地构造一个async对象。async对象传入启动方式,任务函数,和函数参数。 curpos+=200; } int ret = accumulate(my_futures.begin(), my_futures.end(), 0, custom_acc()); //这里我们逐个取出future对象数组并使用我们自定义的方法进行累加。 cout << ret << endl; return 0;}atomic
无锁编程不一定会让程序更快,甚至会有副作用。它并不具有加速行为。
无锁编程不保证性能,不保证程序更快。
证明一个无锁代码的正确性非常难,如果必须使用无锁,最好使用库而不要自己搓轮子。
基本上如果架构没有太大问题,整个系统的瓶颈不会出现在某个锁上,换句话说,出现因为锁的性能瓶颈时大都是因为架构的问题,很多时候根本没必要上lock-free,一般的同步手段完全可以满足我们的需求。但是因为这样我们就可以不了解这个问题吗?我想作为一个IT行业未来的从业者不应该这样想,我们应该很清楚我们的代码经过了哪些变化,指令重排有时会对代码造成影响。
打算使用无锁编程提升性能之前,先检查其他部分,比如算法。
std::atomic_flag
std::atomic_flag 是原子布尔类型。不同于所有 std::atomic 的特化,它保证是免锁的。不同于 std::atomic<bool> , std::atomic_flag 不提供加载或存储操作。
std::atomic_flag是最简单的原子类型,这个类型的对象可以在两个状态间切换:
-
设置
-
清除
默认构造函数
构造一个新std::atomic_flag对象,不过未指明状态。这里未指定默认构造出来的std::atomic_flag实例是clear状态,还是set状态(c++20后默认构造函数初始化的状态为clear)。因为对象存储过程是静态的,所以初始化必须是静态的。std::atomic_flag 必须使用ATOMIC_FLAG_INIT进行初始化,这样构造出来的实例状态为clear。另外,atomic_flag不能被拷贝,也不能 move
std::atomic_flag::test_and_set
原子地更改 std::atomic_flag的状态为设置( true )并返回它先前保有的值。
std::atomic_flag::clear
原子地更改 std::atomic_flag的状态为清除( false )。
std::atomic_flag::wait/notify_one/notify_all
C++20内容
std::atomic
std::atomic模板的每个实例化和专门化都定义了一个原子类型。如果一个线程在另一个线程读取它时写入一个原子对象,那么行为就会被明确定义(参见关于数据竞争的详细信息的内存模型)。此外,对原子对象的访问可以建立线程间的同步,并按照std::memoryorder指定非原子性的内存访问。
-
std::atomic可以用任何简单的可复制的t实例化。同时std::atomic是不可复制的,不可移动的。 -
注意初始化方式只能使用直接初始化。因为拷贝赋值和拷贝构造被禁用且不提供移动构造和移动赋值。这个初始化方式非原子。
- c++17后可以使用拷贝初始化。强制使用了复制省略技术。前提是右侧必须是prvalue临时对象
atomic不可以使用聚合初始化(aggregate initialization)
atomic<int> a = 5; //c++14错误, c++17 OKatomic<int> a(5); -
特化成员函数操作,操作符重载加减之类的不讲了。
-
注意原子操作没有乘法和除法
-
注意带有赋值操作符的时候不能保证整条语句的原子性。
atomic<int> a(5); a = a + 5; //只保证读取a和a+5并且赋值分别是原子的。也就是原子读 + 原子写。不能保证原子读+写。//也就是此时在原子操作:把A读出来 和原子操作:把A+5然后写回A 之间,任何指令都可以插入。//可能存在把A读出来,然后其他操作把A修改为100000,然后A被修改为A+5然后写回。这样的情况。-
c++20前,浮点类型不支持自增操作。
-
主
std::atomic模板可用任何满足可复制构造 (CopyConstructible) 及可复制赋值 (CopyAssignable) 的可平凡复制 (TriviallyCopyable) 类型T特化。若下列任何值为false则程序为非良构:-
std::is_trivially_copyable
::value -
std::is_copy_constructible
::value -
std::is_move_constructible
::value -
std::is_copy_assignable
::value -
std::is_move_assignable
::value
-
-
针对原子对象的操作并不一定全是“原子”的。也就是不一定保证无锁。需要看内存是否对齐了。可以使用
is_lock_free()进行判断针对该原子对象的操作是否是无锁的。详细查看这个视频
std::atomic::store
void store( T desired, std::memory_order order = std::memory_order_seq_cst ) noexcept;原子地以 val 替换当前值。按照 order 的值影响内存。order 必须是 std::memory_order_relaxed 、 std::memory_order_release 或 std::memory_order_seq_cst 之一。否则行为未定义。
atomic<T> x;x.store(y); //次操作在含以上等同于x = y;std::atomic::load
T load( std::memory_order order = std::memory_order_seq_cst ) const noexcept;原子地加载并返回原子变量的当前值。按照 order 的值影响内存。
order 必须是 std::memory_order_relaxed、 std::memory_order_consume 、 std::memory_order_acquire 或 std::memory_order_seq_cst 之一。否则行为未定义。
atomic<T> x;T y = x.load(); //此操作在含义上等同于 T y = x;std::atomic::operator=
等于store() 注意用法。
atomic<int> a;a = 3;这个等号不是拷贝赋值的那个等号。
std::atomic::operator T
等于load()
std::atomic::exchange
T exchange( T desired, std::memory_order order = std::memory_order_seq_cst )原子地以 desired 替换底层值。操作为读-修改-写操作。根据 order 的值影响内存。
返回调用前原子对象的值。
atomic<T> x;T z = x.exchange(y); //此操作在含义上等同 z = x; x = y;std::atomic::compare_exchange_weak/strong
上面的exchange只是原子交换。但是这个就是著名的CAS
bool compare_exchange_weak( T& expected, T desired, std::memory_order success, std::memory_order failure ) noexcept;bool compare_exchange_strong( T& expected, T desired, std::memory_order success, std::memory_order failure ) noexcept;-
原子地比较
*this和expected的对象表示,而若它们逐位相等,则以desired替换前者(进行读修改写操作)。否则,将*this中的实际值加载进expected(进行加载操作)- 若成功更改底层原子值则返回
true,否则为false。
- 若成功更改底层原子值则返回
-
归纳一下这个函数的使用要点:
- 当前值与期望值**(expect)相等时,修改当前值为设定值(desired)**,返回
true - 当前值与期望值**(expect)不等时,将期望值(expect)**修改为当前值,返回
false- 这一行非常关键。如果当前值和期望值不相等,会修改期望值而不是修改当前值。所以下面我们实现简单的自旋锁的时候必须要搭配
while,而且while内需要把值改回去。
- 这一行非常关键。如果当前值和期望值不相等,会修改期望值而不是修改当前值。所以下面我们实现简单的自旋锁的时候必须要搭配
- 这个函数可能在满足
true的情况下仍然返回false,所以只能在循环里使用,否则可以使用它的strong版本- weak版和strong版的区别:
- weak版本的CAS允许偶然出乎意料的返回(比如在当前值和期待值一样的时候却返回了false),不过在一些循环算法中,这是可以接受的。通常它比起strong有更高的性能。
- 如果此事偶然发生,可以对期望值(expect)进行检查。期望值应该不会改变。
- 用人话说就是
compare_exchange_weak有可能在当前值与expected相等时仍然不执行交换并返回false;compare_exchange_strong则不会有这个问题. weak 版本能让编译器在一些平台下生成一些更优的代码, 在 x86 下是没区别的.
- weak版和strong版的区别:
- 当前值与期望值**(expect)相等时,修改当前值为设定值(desired)**,返回
atomic<T> x;bool success = x.compare_exchange_weak(y, z);//此操作含义为://如果x == y, 则让 x = z 并且返回true//如果x != y, 则让 y = x 并且返回false有没有注意到为啥这个函数有俩memory_order?
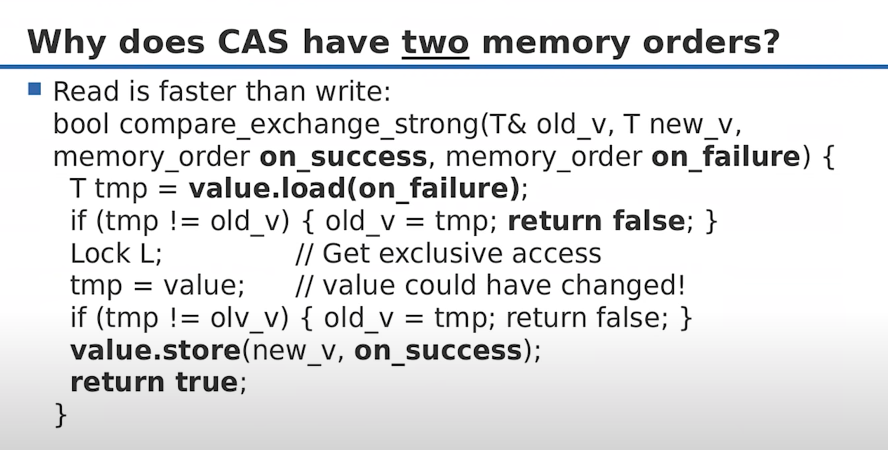
为了支持指定两个内存顺序: 成功时的内存顺序和失败时的内存顺序. 一个用于读取一个用于写入
在 x86 下 compare_exchange_* 会被编译成一条 cmpxchgl 指令, 因此操作是原子且无锁的.
https://blog.csdn.net/feikudai8460/article/details/107035480
额外说一下fetch系列操作。这里就说一下fetch_add
指针特化的fetch_add在下面。这里针对普通类型。
T fetch_add( T arg, std::memory_order order = std::memory_order_seq_cst ) noexcept;- 原子地以值和
arg的算术加法结果替换当前值。运算是读修改写操作。按照order的值影响内存。 - 其实就是
+= - 但是返回值是原值!!!!!!
atomic<int> x(200);int z = x.fetch_add(20); //z = x; x += y。cout << z << endl; //z是x修改前的值。200cout << x.load() << endl; //x是220std::atomic<T*>特化
- 针对指针类型的特化,代表指针指向的对象不是原子的。而是代表这个指针本身是原子的。
- 同样不可拷贝构造和拷贝赋值。
- 但是他可以通过合适的指针类型(不一定非得是原子的)进行构造和赋值。
针对指针特化类型的特殊操作
特化的函数这里主要简单介绍fetch_add, fetch_sub, operator++, operator--
自增自减没啥好说的。这里就举个fetch_add的例子
-
fetch_add-
T* fetch_add( std::ptrdiff_t arg,std::memory_order order = std::memory_order_seq_cst ) noexcept;
-
原子地以值和
arg的算术加法结果替换当前值。运算是读修改写操作。按照order的值影响内存。 -
其实就是
+=操作。注意这个加法是指针加法。
-
std::atomic::wait/notify_one/notify_all
C++20内容
atomic 支持操作总结
| 操作 | atomic_flag | atomic<bool> | atomic<T*> | atomic<integral_type> | atomic<other_type> |
|---|---|---|---|---|---|
| test_and_set | ✓ | ||||
| clear | ✓ | ||||
| is_lock_free | ✓ | ✓ | ✓ | ✓ | |
| load | ✓ | ✓ | ✓ | ✓ | |
| store | ✓ | ✓ | ✓ | ✓ | |
| exchange | ✓ | ✓ | ✓ | ✓ | |
| compare_exchange_weak/strong | ✓ | ✓ | ✓ | ✓ | |
| fetch_add, += | ✓ | ✓ | |||
| fetch_sub, -= | ✓ | ✓ | |||
| fetch_or, |= | ✓ | ||||
| fetch_and, &= | ✓ | ||||
| fetch_xor, ^= | ✓ | ||||
| ++,— | ✓ | ✓ |
- 关于用户定义类型,有非常严格要求。建议去官方文档看。