
std::optional (C++17)
可选返回值的一个类型。要么有值要么没值。就是一个和bool一起打包的包装器
一个大概示例
template <typename T>class optional{ bool _initialized; std::aligned_storage_t<sizeof(T), alignof(T)> _storage;public:// operations};初始化及简单实用示例
//初始化为空std::optional<int> emptyInt;std::optional<double> emptyDouble = std::nullopt;//直接用有效值初始化std::optional<int> intOpt{10};std::optional intOptDeduced{10.0}; // auto deduced//使用make_optionalauto doubleOpt = std::make_optional(10.0);auto complexOpt = std::make_optional<std::complex<double>>(3.0, 4.0);//使用in_place 后文会提到std::optional<std::complex<double>> complexOpt{std::in_place, 3.0, 4.0};std::optional<std::vector<int>> vectorOpt{std::in_place, {1, 2, 3}};//使用其它optional对象构造auto optCopied = vectorOpt;简单使用
std::optional<int> find_index(const std::vector<int>& data, int value) { auto iter = std::find(data.begin(), data.end(), value); if (iter != data.end()) { return std::distance(data.begin(), iter); } return std::nullopt; // 注意这个 也可以直接返回{} // std::nullopt 是 std::nullopt_t 类型的常量,用于指示 optional 不含值。}int main() { vector<int> myvec{1, 2, 3, 4, 5}; auto s = find_index(myvec, 3); auto ss = find_index(myvec, 6); if (s) { // 判断是否有值方法1 cout << s.value() << endl; // 获取值方法1 cout << *s << endl; // 获取值方法2 } if (s.has_value()) { // 判断是否有值方法2 cout << s.value() << endl; cout << *s << endl; }}optional 对象在下列条件下含值:
- 对象被以
T类型的值或另一含值 的optional初始化/赋值。
对象在下列条件下不含值:
- 对象被默认初始化。
- 对象被以 std::nullopt_t 类型的值或不含值 的
optional对象初始化/赋值。 - 调用了成员函数 reset()。
部分成员函数
- emplace()
- 原位构造
- 如果之前已含值,则先销毁再构造
- 原位构造
- reset()
- 销毁值。
- swap()
- 交换值
- 如果交换一个空值,则销毁原有值
比较大小
对于定义了<,>,==操作符的类型,保存他们的optional对象也可以比较大小。如optional<int>之间比较大小和直接比较int数值的大小是一样的。比较特殊的是std::nullopt,在比较大小时,它总小于存储有效值的optional对象。
std::optional<int> int1(1);std::optional<int> int2(10);std::optional<int> int3;
std::cout << std::boolalpha;std::cout << (int1 < int2) << std::endl; // truestd::cout << (int2 > int1) << std::endl; // truestd::cout << (int3 == std::nullopt) << std::endl; // truestd::cout << (int3 < int1) << std::endl; // true为什么需要make_optional 和std::in_place
首先我们需要注意一点:
class myclass { public: myclass() : mInt(100) {}
int mInt;};class myclass2 { public: myclass2(int x, int y) : mInt(x+y) { cout << "constructor" << endl; } myclass2(const myclass2& x) : mInt(x.mInt) { cout << "copy constructor" << endl; } myclass2(myclass2&& x) : mInt(x.mInt) { cout << "move constructor" << endl; } int mInt;};class myclass3 { public: myclass3(int x) : mInt(x) { cout << "constructor" << endl; } myclass3(const myclass3& x) : mInt(x.mInt) { cout << "copy constructor" << endl; } myclass3(myclass3&& x) : mInt(x.mInt) { cout << "move constructor" << endl; } int mInt;};int main() { std::optional<myclass> sample; std::optional<myclass> sample2{};
cout << boolalpha; cout << sample.has_value() << endl; // false cout << sample2.has_value() << endl;// false}注意,在这个情况下,这两种方法得到的结果都只是空的optional对象,而不是包含默认构造值的对象。
所以此时, 我们可以这么写:
std::optional<myclass> sample3{myclass()};这种方法是可以工作的,我们将得到包含默认myclass对象的optional对象。但是在上面的代码中,将先构造出一个myclass的临时对象,然后临时对象被移入optional存储的对象中,带来了额外的开销。在这种情况下,我们就可以使用std::in_place_t / std::make_optional来“原地”构造optional底层存储的对象。
std::optional<myclass> sample4{std::in_place};cout << sample4.has_value() << endl; // truecout << sample4->mInt << endl; // 100std::optional<myclass> sample5(std::make_optional<myclass>());cout << sample5.has_value() << endl;// truecout << sample5->mInt << endl; // 100我们再继续看例子,
std::optional<myclass2> sample6{std::in_place, 1,3}; //1 OKstd::optional<myclass2> sample7{1, 3}; //2 不OKstd::optional<myclass2> sample8{{1, 3}}; //3 OK 但是有拷贝
std::optional<myclass3> sample9{std::in_place, 1}; //4 OKstd::optional<myclass3> sample10{1}; //5 OK| 构造函数 | 编号 | 版本起 |
|---|---|---|
| constexpr optional() noexcept; constexpr optional( std::nullopt_t]) noexcept; | (1) | (C++17 起) |
| constexpr optional( const optional& other ); | (2) | (C++17 起) |
| constexpr optional( optional&& other ) noexcept(/* 见下文 */); | (3) | (C++17 起) |
| (4) | ||
| template < class U > optional( const optional& other ); | (C++17 起) (C++20 前) (条件性 explicit) | |
| template < class U > constexpr optional( const optional& other ); | (C++20 起) (条件性 explicit) | |
| (5) | ||
| template < class U > optional( optional&& other ); | (C++17 起) (C++20 前) (条件性 explicit) | |
| template < class U > constexpr optional( optional&& other ); | (C++20 起) (条件性 explicit) | |
| template< class… Args > constexpr explicit optional( std::in_place_t, Args&&… args ); | (6) | (C++17 起) |
| template< class U, class… Args > constexpr explicit optional( std::in_place_t, std::initializer_list ilist, Args&&… args ); | (7) | (C++17 起) |
| template < class U = T > constexpr optional( U&& value ); | (8) | (C++17 起) (条件性 explicit) |
第一个可以的原因是使用了std::in_place标签,匹配到了第6个构造函数
第二个不可以的原因是std::optional没有一个支持不带标签的同时是多参数的构造函数。
第三个可以的原因是因为额外加了花括号初始化,先初始化成myclass2对象然后拷贝,匹配的是第8个构造函数
第四个可以的原因是使用了标签。匹配到了第六个构造函数
第五个可以的原因是因为是单参数,所以匹配到了第八个构造函数。
所以, 针对不可拷贝或移动的对象,就必须使用in_place了
总结
核心来讲,有三个作用:
- 区分到底是用
optional<T>的默认构造函数还是T的默认构造函数。 - 允许原地构造需要多个入参的对象。
- 让不可拷贝或移动的对象也可以使用
optional
std::inplace在 std::any , std::variant等中亦有同样作用
所以如下代码
std::optional<myobj> maybe(bool n){ if(n){ return std::nullopt; } // return myobj(10); // 一次构造+一次移动+一次析构 性能差 return std::optional<myobj>(10); //直接转发给optional,多参可以make_optional/in_place 性能好
}第二种写法性能更好。来自这里
关于为什么需要nullopt
https://stackoverflow.com/questions/62933403/why-do-we-need-stdnullopt
部分参考:
如何往optional里面放入不可构造、不可移动、不可拷贝的对象?
https://devblogs.microsoft.com/oldnewthing/20241115-00/?p=110527
https://github.com/wanghenshui/cppweeklynews/blob/dev/posts/173.md
有点复杂但又不那么复杂。
optional移出元素需要注意的点
假设我有这种代码:
myobj do_something() { std::optional<myobj> opt{2}; cout << "--" << endl; return *opt; // 和opt.value()一样。不过现在会拷贝}myobj do_something2() { std::optional<myobj> opt{2}; cout << "--" << endl; return std::move(opt.value());}do_something会拷贝。假设myobj很大,又有不必要开销。我们自然会想要do_something2的方法,利用移动。但是我们到底应该移动什么?移动optional里面的value还是移动optional本身?
假设这种情况:
void dummy(myobj obj) { cout << "dummy" << endl; }void do_something3(bool input) { std::optional<myobj> opt{2}; if (input) { dummy(std::move(opt.value())); // opt.value,也就是myobj本身是垃圾值了 } cout << boolalpha << opt.has_value() << endl; // opt含值 // 过了很久,插入一堆其他逻辑 if (input) { dummy(std::move(opt.value())); // 出问题了,move了两次 }}我们这时候移动的是optional包裹的值。请注意。第一次移动后,optional包裹的值可能是垃圾无效值。但是optional本身是含值的,所以我们就算判断has_value也无法解决这个问题。所以我们真正要做的应该是move这个optional本身。然后move后进行reset。
std::any
any就是一个包装任意类型的包装器
std::any的libstdc++和msvc的内部实现细节差异挺大的。但是换汤不换药。
std::tuple的实现解析
https://mcyoung.xyz/2022/07/13/tuples-the-hard-way/
tuple 的 make_tuple 和 构造函数的一个细微区别
关于make_tuple可以查看EFF_STL章节
int a{1};float b{2.3};double c{3.2};std::string d {"abc"};auto t = std::tuple{a, b, c, d}; //c++17后可以不指定类模板参数auto t2 = std::make_tuple(a, b, c, d);上面的代码就是在基本情况下使用构造函数和makr_tuple的基本语法。我们来看下较为复杂的情况
template <typename T>void func(T a) { cout << __PRETTY_FUNCTION__ << endl;}
int main() { int a{1}; float b{2.3}; double c{3.2}; std::string d{"hello"}; auto t = std::tuple{std::ref(a), std::ref(b), std::cref(c), std::cref(d)}; //c++17后可以不指定类模板参数 auto t2 = std::make_tuple(std::ref(a), std::ref(b), std::cref(c), std::cref(d)); func(t); func(t2);}/*void func(T) [with T = std::tuple<std::reference_wrapper<int>, std::reference_wrapper<float>, std::reference_wrapper<const double>, std::reference_wrapper<const std::__cxx11::basic_string<char, std::char_traits<char>, std::allocator<char> > > >]void func(T) [with T = std::tuple<int&, float&, const double&, const std::__cxx11::basic_string<char, std::char_traits<char>, std::allocator<char> >&>]*/我们注意到,使用普通的构造函数时,tuple里 std::ref/cref的类型没有变化。也就是每一个元素都是std::reference_wrapper类型。
但是在使用make_tuple的时候,tuple里的元素类型被脱去了,也就是”退化”成了对应底层类型的引用或const引用类型。我们可以看下源代码
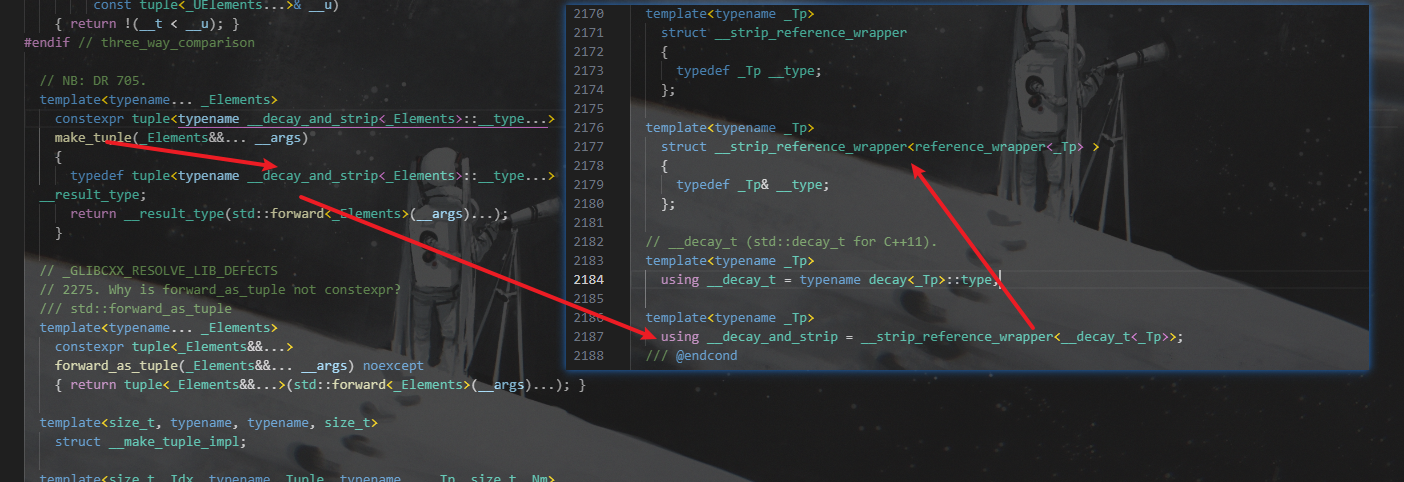
我们可以看到,make_tuple会对参数的reference_wrapper类型进行脱去。
资料来自这篇文章的 Errors in object lifetime: tuples that shoot at your feet 章节
C++中如何避免page fault来降低延迟
协程
让enum class支持位运算
让枚举支持位运算组合,就像传统c的用法那样,但是枚举类是强类型,转换很不方便,怎么办?实现operator |
比如
#include <type_traits>
// Define a templatized struct to contain a bool constexpr that controls// when the operators get generated.template <typename E>struct FEnableBitmaskOperators { static constexpr bool enable = false;};
// This operator is only defined in the candidate set for a given type if the// std::enable_if_t below evaluates to true, otherwise it is dropped.template <typename E>typename std::enable_if_t<FEnableBitmaskOperators<E>::enable, E> operator|( E Lhs, E Rhs) { return static_cast<E>(static_cast<std::underlying_type_t<E>>(Lhs) | static_cast<std::underlying_type_t<E>>(Rhs));}// Rest of the operators...
With the following usage:
enum class ERenderPass : uint8_t { ...};// Specialize the struct to enable the operators for our enum.template <>struct FEnableBitmaskOperators<ERenderPass> { static constexpr bool enable = true;};
// Works!ERenderPass Primary = ERenderPass::Geometry | ERenderPass::Lighting;实际上valkan cpp就是这么干的
template <typename BitType, typename std::enable_if<FlagTraits<BitType>::isBitmask, bool>::type = true>VULKAN_HPP_INLINE VULKAN_HPP_CONSTEXPR Flags<BitType> operator|( BitType lhs, BitType rhs ) VULKAN_HPP_NOEXCEPT { return Flags<BitType>( lhs ) | rhs;}ranges 和 view
把ranges理解为一段区间的抽象。比如容器的两个迭代器范围内。所以vector、list都可以被称为range。因为它满足range的要求。
ranges的end一般叫sentinel哨位。原因是它的类型不一定必须和begin迭代器类型一致。因为sentinel不一定是迭代器。
range自带的算法一般是立即求值的。但是view不同。view(范围适配器)是惰性求值的。我们可以把view理解为惰性求值的规则管线。在迭代实际发生时才会进行计算。view是一种特殊的、轻量级的range。
|可以组成管线的原因是重载了operator |
| 特性 | range | view |
|---|---|---|
| 是否是概念 | ✅ 是 | ✅ 是 |
| 是否可以遍历 | ✅ 可以 | ✅ 可以 |
| 是否拥有数据 | 可能有 | ❌ 通常没有(或只是引用) |
| 是否惰性计算 | ❌ 一般是立即 | ✅ 是惰性的 |
| 是否轻量级 | 不一定 | ✅ 是 |
| 能否组合管道 | ❌(要借助 ranges) | ✅ 完美支持管道 . |
- 所有的 view 是 range
- 但不是所有的 range 是 view
- view 是你能用
|管道连接的东西(懒惰组合) - range 更像是 “你能遍历的容器或结构”的大集合
LLVM的dense map解析
https://zhuanlan.zhihu.com/p/669307116
讲的非常好
C++ ABI的真正理解
ASIO 的使用技巧
https://mmoemulator.com/p/going-super-sonic-with-asio/#skippable-preamble
GCC的代码模型
https://eli.thegreenplace.net/2012/01/03/understanding-the-x64-code-models
CMAKE杂记
普通库就是编译+链接,对象库只编译不链接,接口库不编译不链接。
接口库的作用:
当您在 CMake 中创建一个 INTERFACE 库并为其设置一些属性(如编译器选项、定义或包含目录),然后其他目标链接到这个 INTERFACE 库时,这些属性就会自动应用到链接到它的所有目标。
在您提到的情况中,假设有一个 some_header.hpp 被多个 .cpp 文件包含,在 CMake 中使用 INTERFACE 库可以确保每次编译这些 .cpp 文件时都使用相同的编译器选项。这种方式简化了管理编译选项的复杂性,因为您只需要在一个地方指定这些选项,而它们就会自动应用到所有依赖的目标上。
下面是一个具体示例:
Step 1: 创建一个 INTERFACE 库,并设置属性。
add_library(some_interface_lib INTERFACE)target_include_directories(some_interface_lib INTERFACE ${CMAKE_CURRENT_SOURCE_DIR}/include)target_compile_definitions(some_interface_lib INTERFACE SOME_DEFINE=1)Step 2: 确保你的目标链接到这个 INTERFACE 库。
add_executable(some_executable main.cpp)target_link_libraries(some_executable PRIVATE some_interface_lib)
add_library(some_other_lib some_other_source.cpp)target_link_libraries(some_other_lib PUBLIC some_interface_lib)在上面的例子中,无论是 some_executable 还是 some_other_lib,任何时候它们的编译单元包含了 some_header.hpp,都会自动应用 some_interface_lib 的属性,即添加了 ${CMAKE_CURRENT_SOURCE_DIR}/include 到包含路径,以及定义了预处理器宏 SOME_DEFINE=1。
通过这种方式,CMake 保证了构建系统的一致性和易于维护,同时避免了在多个地方重复相同的编译配置。
接口库示例
add_library(test_interface INTERFACE) // 创建一个名为 test_interface 的接口库// 这里没有指定源文件,因为接口库不生成二进制文件;它只用来携带相关的编译器和链接器选项。target_include_directories(test_interface INTERFACE ${CMAKE_CURRENT_LIST_DIR}/include) // 为test_interface 添加包含目录// 这使得任何链接到 test_interface 的目标都会在编译时包含 ${CMAKE_CURRENT_LIST_DIR}/include 目录。// 比如如果某一个其他的目标使用target_link_libraries命令来链接test_interface, 那么这个目标也会包含${CMAKE_CURRENT_LIST_DIR}/include 目录这就是为什么header-only非常适合使用interface库。因为header-only没有源文件,自然不会有目标文件。当我的某个目标是一个header-only的库的时候,设置为接口库就相当于让每一个包含了这个header-only的库都自动使用同一份目录和编译选项(如有)
其他参考文章
memset 不可用于显式清除内存数据
若
memset所修改的对象在其生存期的剩余部分不再被访问,则此函数可以被优化掉(在如同规则下)(例如 gcc 漏洞 8537)。为此,此函数不能用于擦洗内存(例如以零填充存储密码的数组)。对
memset_explicit和memset_s禁止此优化:保证进行内存写。
这个bug来自PPSSPP代码报告这里的N18
void sha1_hmac( unsigned char *key, int keylen, unsigned char *input, int ilen, unsigned char output[20] ){ sha1_context ctx;
sha1_hmac_starts( &ctx, key, keylen ); sha1_hmac_update( &ctx, input, ilen ); sha1_hmac_finish( &ctx, output );
memset( &ctx, 0, sizeof( sha1_context ) ); // <<!}因为memset 存在Dead Store Elimination,所以这个memset可能会被优化掉,导致内存数据并没有被清除
std::launder
什么是launder
launder和const、编译器的常量传播之间的神秘关系 查看Const and optimizations一节
#include <new>#include <iostream>
struct A { int x = 1; };struct B { int y = 42; };
int main() { alignas(B) char buffer[sizeof(B)]; //必须和B对齐不然炸了 A* a = new (buffer) A; std::cout << a->x << "\n";
// 用 placement new 在同一块内存构造另一个类型 B* b = new (buffer) B;
// 直接访问 b->y 是 **未定义行为**! // 因为优化器认为这块内存“本来是 A”,没有新对象被构造 std::cout << std::launder(b)->y << "\n"; // 正确做法}这个东西的核心就是刷新编译器的“类型视角”:告诉它这里是新构造出来的对象,也就是强制编译器 重新加载指针指向对象;可以查看标准文档的 17.6.5[ptr.launder]
range based for loop的临时范围初始化器的雷
查看这里和这里。弄清楚何时会导致引用绑定的临时对象失效。以及在这里的Errors in object lifetime: lifetime extension章节看一下临时对象的生命周期被临时范围初始化器错误的延长
以及这里的Errors in object lifetime: a fly in the syntactic sugar (range-based for)一章看范围for循环的生命周期问题。
其实说白了核心是一点:
总而言之,临时量的生存期不能以进一步“传递”来延续:从绑定了该临时量的引用或数据成员初始化的第二引用不影响临时量的生存期。
范围初始化器可以抽象看成是这样的形式:
/*属性(可选) for ( 初始化语句(可选) 项声明 : 范围初始化器 ) 语句*/{ auto&& /* range */ = 范围初始化器; for (auto /* begin */ = /* 首表达式 */, /* end */ = /* 尾表达式 */; /* begin */ != /* end */; ++/* begin */){ 项声明 = */* begin */; 语句 }}假设我们有这种代码:
struct Point { int x; int y;};
struct Shape {public: using VertexList = std::vector<Point>; explicit Shape(VertexList v) : vertexes(std::move(v)) {}
const VertexList& Vertexes() const { // 1 返回const& return vertexes; }
VertexList vertexes;};
Shape MakeShape() { return Shape { Shape::VertexList{ {1,0}, {0,1}, {0,0}, {1,1} } };}
int main() { for (auto v : MakeShape().Vertexes()) { // 2 注意这种范围初始化器初始方式 std::cout << v.x << " " << v.y << "\n"; } std::cout << " " << std::endl; for (auto v : MakeShape().vertexes) { // 3 注意这种范围初始化器初始方式 std::cout << v.x << " " << v.y << "\n"; }}/*7363 0-1948417267 -11259363790 01 1
1 00 10 01 1*/我们注意到方法2输出垃圾值。方法3是OK的 这就是雷点。
我们已经知道了,临时量的生存期不能以进一步“传递”来延续:从绑定了该临时量的引用或数据成员初始化的第二引用不影响临时量的生存期。我们手动“扩展一下”这个范围循环
auto&& /* range */ = MakeShape().Vertexes(); // 方法2auto&& /* range */ = MakeShape().vertexes; // 方法3我们已经发现端倪。方法2的Vertexes()函数调用返回的临时对象已经绑定到了函数返回值的const &虽然后续被绑定到了auto&& 但是无法被二次延长。方法3当中没有方法2那种函数返回值从中作梗,所以正确的被auto&&延长了生命周期。
如何避免这个雷
- 记得对任何const类型的函数进行rvalue限定的重载
- 针对范围for循环的范围初始化器,一定仅使用变量本身或者它的成员变量。
- C++20后使用新语法
- 如果有机会,使用
std::ranges::for_each
浮点数的各种判断是否为0
算术运算溢出相关的未定义行为
C++中,f(x) 有多少种可能?
https://biowpn.github.io/bioweapon/2024/11/12/what-does-f-x-mean.html 强烈建议看一下
Proxy库
ECS模式的数据结构设计
#include <vector>#include <cassert>
template<typename T>class DenseSparseArray {public: // 插入元素(假设 entity 是唯一标识) void insert(uint32_t entity, const T& value) { if (entity >= sparse.size()) { sparse.resize(entity + 1, -1); // -1 表示无效索引 }
if (sparse[entity] == -1) { sparse[entity] = dense.size(); dense.push_back({entity, value}); } }
// 删除元素 void erase(uint32_t entity) { if (contains(entity)) { size_t dense_idx = sparse[entity]; auto& last = dense.back();
// 将要删除的元素与最后一个元素交换 std::swap(dense[dense_idx], last); sparse[last.entity] = dense_idx;
dense.pop_back(); sparse[entity] = -1; } }
// 访问元素 T& operator[](uint32_t entity) { assert(contains(entity)); return dense[sparse[entity]].value; }
// 判断是否存在 bool contains(uint32_t entity) const { return entity < sparse.size() && sparse[entity] != -1; }
// 迭代器支持 auto begin() { return dense.begin(); } auto end() { return dense.end(); }
private: struct Element { uint32_t entity; T value; };
std::vector<int> sparse; // 稀疏数组(存储索引) std::vector<Element> dense; // 密集数组(实际数据)};
enseSparseArray<int> arr;
arr.insert(100, 42); // 插入 entity=100arr.insert(200, 77); // 插入 entity=200
std::cout << arr[100]; // 输出 42
arr.erase(100); // 删除 entity=100
for (auto& elem : arr) { // 遍历所有有效元素 std::cout << elem.entity << ": " << elem.value << "\n";}匿名联合体
在folly中,有这样一段代码
template <typename T>class ResultHolder { protected: ResultHolder() {} ~ResultHolder() {} // Using a separate base class allows us to control the placement of result_, // making sure that it's in the same cache line as the vtable pointer and the // callback_ (assuming it's small enough). union { Try<T> result_; };};这个类里面的union叫做匿名联合体。为啥要把result用union包一下?目的是防止T类型没有默认构造函数导致编译错误。因为匿名联合体内的成员不会被默认初始化。
https://zh.cppreference.com/w/cpp/language/default_initialization
在默认初始化章节中提到了。
包括标准库文档的11.9.3[class.base.init]节:
- otherwise, if the entity is an anonymous union or a variant member (11.5.2), no initialization is performed;
同时。如果一个类包含了一个匿名联合体,则这个匿名联合体不会被初始化
https://zh.cppreference.com/w/cpp/language/constructor
在开始执行组成构造函数体的复合语句之前,所有直接基类、虚基类和非静态数据成员的初始化均已结束。这些对象的非默认初始化只能在成员初始化器列表指定。对于不能默认初始化的基类,和不能以默认初始化或以其默认成员初始化器(如果有)(C++11 起)初始化的非静态数据成员,例如引用和 const 限定的类型的成员,必须指定成员初始化器。(注意,类模板实例化的非静态数据成员的默认成员初始化器,当成员类型或初始化器待决时可能是无效的。)(C++11 起)对没有成员初始化器或默认成员初始化器(C++11 起)的匿名联合体或变体成员不进行初始化。
一定要区分联合体和匿名联合体
template <typename T>class ResultHolder {public: union { T result_; }; // 匿名联合体 union s{ T result_; } // 联合体 但是这里只有声明没有定义 s s_; //定义 但是报错。因为不是匿名联合体依旧会被尝试初始化};我们可以看一个简化版的最小实现
#include <iostream>#include <new> // for placement new
struct A { int x; A() = delete; // 禁止默认构造 A(int v) : x(v) { std::cout << "A(" << v << ") constructed\n"; } ~A() { std::cout << "A destroyed\n"; }};
// folly 风格的 ResultHoldertemplate <typename T>class ResultHolder {public: ResultHolder() {} // 允许默认构造,但不会初始化 result_ ~ResultHolder() { // 不能换成 // result_.~T(); // 因为我们不能确保T被构造过。生命周期管理需要对称,T是手动构造就必须手动析构。 } // 允许默认析构,但需要手动析构 result_
// 使用 匿名union 避免默认构造,同时不提供额外的默认构造函数 union { T result_; }; // T result_; // 如果用这种就会报错};
int main() { // 由于 result_ 没有默认构造,需要手动构造 ResultHolder<A> holder; new (&holder.result_) A(42); // 使用 placement new 构造 A std::cout << "A.x = " << holder.result_.x << "\n";
// 手动调用析构,否则会产生未定义行为 holder.result_.~A();
return 0;}thread local 线程存储期的性能瓶颈
https://yosefk.com/blog/cxx-thread-local-storage-performance.html 这篇文章详细介绍了TLS (thread local storage)对象的性能瓶颈。说白了:
tls对象在有类/构造函数维护 + fpic共享库需要额外调用__tls_get_addr 成为性能瓶颈
优化指南
- TLS对象尽可能合并
- 不要为TLS写构造函数
- 为频繁访问的对象使用__attribute__((visibility(“hidden”)))
- 为关键变量使用__attribute__((tls_model(“initial-exec”)))
- 如果不是共享库,不要使用fpic (静态库链接到二进制,可以去掉)
- 考虑使用编译器加速 比如-mtls-dialect=gnu2
- 使用pthread key分配+自定义pthread_getspecifc绕过
设计几种迭代器
个人理解里面有几种还是很有意思的。比如:
无限序列迭代器,适用于生成一些数字
#include <iostream>#include <iterator>
class fibonacci_iterator { long long a = 0, b = 1;
public: using iterator_category = std::input_iterator_tag; using value_type = long long; using difference_type = std::ptrdiff_t; using pointer = const long long*; using reference = const long long&;
fibonacci_iterator& operator++() { // 注意这里写的是前置自增 long long temp = a; a = b; b += temp; return *this; }
long long operator*() const { return a; }
// Always true for infinite sequences bool operator!=(const fibonacci_iterator&) const { return true; }};
int main() { auto it = fibonacci_iterator(); for (int i = 0; i < 10; ++i, ++it) { // 前置自增 std::cout << *it << " "; }}类似于transform作用的迭代器适配器
#include <iostream>#include <vector>#include <iterator>#include <algorithm>
template <typename Iter, typename Func>class transform_iterator { Iter it; Func func;
public: using iterator_category = std::input_iterator_tag; using value_type = typename std::result_of<Func( typename std::iterator_traits<Iter>::value_type)>::type; // 萃取一下函数调用的返回类型 using difference_type = std::ptrdiff_t; using pointer = value_type*; using reference = value_type;
transform_iterator(Iter iter, Func f) : it(iter), func(f) {}
transform_iterator& operator++() { // 还是,前置自增 ++it; return *this; } reference operator*() const { // 注意 这重载的是解引用操作符。不是乘法。乘法是二元,解引用是一元。 // 这里的目的是搭配一些STL库的算法。比如copy是解引用赋值。 // 返回reference类型的原因是解引用操作符希望返回一个引用,这样才能被赋值。 return func(*it); } bool operator!=(const transform_iterator& other) const { return it != other.it; }};
int main() { std::vector<int> numbers = {1, 2, 3, 4, 5}; std::vector<int> squares{}; auto square = [](int x) { return x * x; }; auto begin = transform_iterator(numbers.begin(), square); auto end = transform_iterator(numbers.end(), square);
std::copy(begin, end, std::back_inserter( squares)); // 用back inserter往里面插。因为一开始没初始化,所以直接给迭代器 for (auto i : squares) { std::cout << i << std::endl; }}就地过滤迭代器 in-place filter
#include <iostream>#include <vector>
class filtering_iterator { using vec_it = std::vector<int>::iterator; // 简化实现。实际上应该使用模板参数 vec_it current, end; int threshold;
public: filtering_iterator(vec_it begin, vec_it end, int th) : current(begin), end(end), threshold(th) { advance(); }
filtering_iterator& operator++() { current = current == end ? end : current + 1; // 如果是end就返回end,不然就+1 advance(); return *this; }
int operator*() const { return *current; }
bool operator!=(const filtering_iterator& other) const { return current != other.current; }
private: void advance() { while (current != end && *current < threshold) { current = current + 1; // 跳过小于阈值的元素 // 这里用 != 而不是 <是因为只有随机迭代器支持关系性比较 // 另外只能+1,不然迭代器失效就炸了。如果要+n的话需要再套一个while } }};
int main() { std::vector<int> data = {1, 5, 2, 8, 3, 10, 4}; int threshold = 9;
std::cout << "Filtered values: "; for (filtering_iterator it(data.begin(), data.end(), threshold); it != filtering_iterator(data.end(), data.end(), threshold); ++it) { // 注意一点,我们用迭代器一般都是在for循环语句内现场创建,而不是在外面创建再传进去 std::cout << *it << " "; }}