
杂项
类成员函数不可以既是虚函数又是模板函数 12.1.1
- 首先简单来说,虚函数是动态多态。模板属于静态多态。这里不能动静结合。
- 其次,我们知道了函数模板在编译的时候会看哪些地方调用了。根据T的不同,每一份T都会导致实例化出一份T类型的函数。这就导致了会有多个入参类型不同的成员函数。但是我们又知道虚函数的虚函数表必须预先确定。而此时父类看不到子类的模板虚函数到底有几个版本,难不成都写一遍?
- 另一个原因是如果我们有模板虚函数,那么编译器为了确定类的虚函数表的大小,就必须要知道我们一共为该成员模板函数实例化了多少个不同版本的虚函数。显然编译器需要查找所有的代码文件,才能够知道到底有几个虚函数,这对于多文件的项目来说,代价是非常高的。
- 也就是说,如果这样做的话,虚函数表的确定时间就需要从编译器推迟到链接期。因为编译期指的是我不需要看具体实现。我只要发现你是
virtual我就可以把你放到表内。如果支持模板虚函数,那么就需要链接的时候把每一个实现都扫一遍然后再整理后放入虚函数表。
为什么类模板有偏特化没有重载,但是函数模板没有偏特化有重载?
问题也是答案。因为类模板没有重载所以有偏特化。因为函数模板有重载所以没有偏特化。
关于偏序 (partial order)
偏序适用于函数模板。也适用于类模板或变量模板。
我们提到过,当可行函数集中所有的函数都是函数模板的时候,这时候要选择最特殊的那一个。
比如
template <typename T>void func(T a){ //主模板 cout <<"main" << endl;}template <typename T>void func(T* a){ //重载模板 cout << "overload" << endl;}int main(){ int* p; func(p); //输出overload}//注意,调用的时候,如果调用第一个,因为传入的是int*,所以第一个里面的T会被推导为int*//如果调用第二个,因为传入的是int*, 而里面又已经有了个*所以T就只被推导为int。为什么我们认为下面的比上面的更特殊?我们用到了偏序的具体步骤
- 先选择两个函数模板,
T1和T2 - 用假设的唯一类型
X取代模板T1的参数 - 用被
X取代后的T1的参数列表,带入T2,看T2是否是一个有效的模板。忽略所有的隐式转换。 - 反过来,先用
X取代T2的参数,再把T2的参数列表带入T1,看看T1是否有效。 - 如果一个模板的参数比如
T1对于另外一个模板T2是有效的,但是反之不成立,那么就说这个模板T1不比T2更特例化。也就是可能T2比T1更特例化。如果这两个模板的参数都可以相互代替,就说它们具有相同的特例性,这样会引起编译器混淆。
所以我们有总结:
- 对于一个模板,特定类型的参数比一般类型的参数,更具有特例性
- 带有
T*的模板比T的模板具有特例性。因为一个假设的类型X*也可以被认为是T类型的, 相反一个有效的T类型参数,可能不是X*类型的。 const T比T更特例化,道理同上。const T*比const T更特例化,理由也是一样的。
https://www.youtube.com/watch?v=NIDEjY5ywqU
https://blog.csdn.net/weixin_30294295/article/details/94781059
关于不要显式全特化函数和函数全特化的问题
假如我们有下面的代码:
template<typename T> // (1) - 主模板string getTypeName(T){ return "unknown";}
template<typename T> // (2) - 重载自 (1) 的主模板。 针对指针类型的模板重载string getTypeName(T*){ return "pointer";}
template<> // (3) - (2) 的显式全特化。针对int指针类型的显式全特化string getTypeName(int*){ return "int pointer";}
// getTypeName2
template<typename T> // (4) - 主模板string getTypeName2(T){ return "unknown";}
template<> // (5) - (4) 的显式全特化。 针对int指针类型的显式全特化string getTypeName2(int*){ return "int pointer";}template<typename T> // (6) - 重载自 (4) 的主模板。 针对指针类型的模板重载string getTypeName2(T*){ return "pointer";}
int main(){
cout << '\n'; int* p; cout << "getTypeName(p): " << getTypeName(p) << '\n'; //输出getTypeName(p): int pointer cout << "getTypeName2(p): " << getTypeName2(p) << '\n'; //输出getTypeName2(p): pointer cout << '\n';
}这段代码中,我们有意的把针对指针的模板重载和全特化调换了顺序写成了两个不同的函数。
我们看到了。分别输出getTypeName(p): int pointer 和 输出getTypeName2(p): pointer 。
但是这不对啊?看getTypeName,为什么使用了全特化版本而不是模板重载?我们不是说了全特化版本不参与重载决议吗?
我们要理解到底决议的是谁。要看匹配顺序。
-
针对第一个
getTypeName函数调用,过程是这样的:-
在一开始,重载解析会考虑 (1) 和 (2)。第三个全特化版本此时不参与重载决议。
-
template<typename T> std::string getTypeName(T);- (1) - 主模板
-
template<typename T> std::string getTypeName(T*);- (2) - 重载自 (1) 的主模板
-
template<> std::string getTypeName(int*);- (3) - (2) 的显式全特化
-
-
显式全特化版本此时不参与,所以(2) 更合适,因此第一阶段选择 (2)。
-
但是随后看到了(3),我们发现针对我们合成出来的
T为int类型的函数也就是(2),还有一个似乎可以比较一下。而且此时两个函数都是模板函数。并且其中一个是主模板合成出的。所以这时候(3)被加入到了重载决议中,开启偏序部分。 -
此时通过偏序,(3)此时被认为是(2)的显式全特化。和(2)相比,(3)的类型更为特化,所以此时选择了(3)。所以编译器不会从(2)合成一个,而是选取一个已经存在的(3)。这里看一下上面偏序推导和下面的“关于为什么说函数模板不是…”
-
-
但是针对第二个
getTypeName2函数调用,过程是这样的:- 在一开始,重载解析会考虑 (4) 和 (6)。
template<typename T> std::string getTypeName2(T);- (4) - 主模板
template<> std::string getTypeName2(int*);- (5) - (4) 的显式全特化
template<typename T> std::string getTypeName2(T*);- (6) - 重载自 (4) 的主模板
- 显式全特化版本此时不参与,所以(6) 更合适,因此选择 (6)。
- 然而此时**(5) 被认为是 (4) 的显式全特化而不是(6)的显式全特化**。而且因为 (4) 没有被选中,所以重载解析也不会考虑(5)。最后选择(6)。
- 为什么?此时**(5) 被认为是 (4) 的全特化而不是(6)的显式全特化**。因为在进行到(5)的时候,编译器唯一能看到的只有(4)而没有(6)。[也就是在(5)眼里,只有(4)在作用域内。(6)此时还没有被看见。因为显式全特化的(5)没有名字,这时候必须依附于一个主模板。所以说(5)只能看见(4)所以认为(5)是(4)的显式全特化]
- 在一开始,重载解析会考虑 (4) 和 (6)。
所以我们在这里可以看出来模板特化的混乱程度。所以尽可能不要特化模板函数,而是采用普通函数。也就是不要对函数模板进行特化,而要使用非泛型函数。
所以我们在这里把(3)和(5)函数头的全特化指示template<>删掉,则一切工作正常。都会输出int pointer。因为普通函数总是优先于模板函数。
https://zhuanlan.zhihu.com/p/561977606
- 也就是说,如果在很多个函数模板中挑选,编译器会首先选中一个基础模板。然后针对这个模板再一轮搜索来查看是否有更加匹配的。
为了好玩,再看个像狗一样的例子
template<typename T> // (7) - 主模板string getTypeName3(T){ return "unknown";}
template<> // (8) - (7) 的显式全特化。 针对int指针类型的显式全特化string getTypeName3(int*){ return "int pointer";}template<typename T> // (9) - 重载自 (7) 的主模板。 针对指针类型的模板重载string getTypeName3(T*){ return "pointer";}template<> // (10) - (9) 的显式全特化。 针对int指针类型的显式全特化string getTypeName3(int*){ return "another int pointer";}int main(){
cout << '\n'; int* p; int a = 0; cout << "getTypeName3(p): " << getTypeName3(p) << endl; //输出another int pointer cout << "getTypeName3(a): " << getTypeName3(a) << endl; //输出 unknown // cout << '\n';
}- 就是由于上面的原因。(8)被认为是(7)的显式全特化。因为当时它只能看到,依附于(7)。而(10)被认为是(9)的显式全特化。因为(10)可以看到(9)。而且因为(8)是(7)的显式全特化,我们不考虑(7)所以也不考虑(8)。考虑(9)然后通过偏序发现(10)比9更特殊。最后选择了(10)
什么时候要显式全特化而不是重载?
一个是std::swap。
另外一个是阻止某些隐式转换。比如:
template <class T>void testf(T); //注意,这里没有定义!!template <>void testf(int) { //一些内容}int main(){ testf(3);//可以 testf(3.3); //不行 return 0;}当只有void foo(int)时,以浮点类型调用会发生隐式转换,这可以通过特化来阻止。正常调用int没问题,但是如果入参是float,会匹配到主模板。但是主模板没有定义,自然出现问题。
关于重载决议 (overload resolution)
https://mp.weixin.qq.com/s/lbPdLfusUqiO-I59PcXrCQ
这个cppcon关于重载解析的视频非常好。
-
如果函数只有返回值不同,无法重载。
- 因为普通函数返回值不算做函数签名。因为返回值是否使用是可选的。
-
如果函数只有形参的默认值不同,无法重载。
-
因为形参默认值不算作函数签名。
-
还有一种情况。就是多个函数有相同数量的不带默认值的参数
-
int f();int f(int x = 123);
-
这种也会二义性。因为在选择可行函数集的时候:
-
If the candidate function has more than
Mparameters and theM+1’st parameter and all parameters that follow have default arguments, it is viable. For the rest of overload resolution, the parameter list is truncated atM.M = 调用时实际提供的实参数量
如果候选函数的形参比 M 多,但从第 M+1 个形参开始,所有形参都有默认值,那么这个函数依然是可行函数(viable function)。
在后续的重载决议中,编译器会临时把这个函数的参数表截断到前 M 个形参,然后再和其他候选函数进行优劣比较。
这个时候第二个函数给截断了,所以比较的时候这两个函数都可以是0参数。
-
-
-
如果函数的区别只有一个是
static一个不是,无法重载。
重载决议只看声明,不看定义。
所以如果声明中包含一些计算或判断,比如萃取,decltype之类,它依旧会计算。
- 在一个函数调用的备选方案中包含函数模板时,编译器首先要决定应该将什么样的模板参数用于各种模板方案,然后用这些参数替换函数模板的参数列表以及返回类型,最后评估替换后的函数模板和这个调用的匹配情况(就像常规函数一样)
- 也就是类型推导发生在重载决议前。
第一步 确定候选函数集
-
确定候选集: 在重载函数集中,根据作用域和函数名,来选择同名同域的重载函数
-
候选函数集特点:
-
该集合中的函数的声明,在该调用点可见
- 也就是,和被调函数在同一作用域下
-
该集合中的函数,与被调函数同名
- 也就是,重载函数的函数名都一致
-
第二步 选出可行函数集
-
在确定了候选函数集之后,根据被调函数的参数列表,选择出对应的可行函数集
- 参数列表信息 = 参数个数 + 参数类型
-
可行函数集特点:
- 每个实参的类型要与对应的形参类型相同,或者是能够转换成形参的类型
- c++支持隐式类型转换!
- 参数个数与被调函数个数匹配
- 参数类型可以隐式转换,但是参数个数相同是最低标准
- 每个实参的类型要与对应的形参类型相同,或者是能够转换成形参的类型
在这个过程中会逐个移除无效的候选函数。无效的候选函数被称为not viable。如果没有找到可行函数集,则编译器将报告无法匹配函数的错误。在这一过程中,仅检查参数个数是否匹配。具体能否转换以满足条件在下一步。
第三步 寻找最佳匹配 Ranking阶段和tie-breaker阶段
- 从可行函数集合中选出所有与本次调用最匹配的函数(注意,并不一定是完全一致的函数)
- 编译器将依次检查可行函数集中的每一个函数
- 依次检查每一个函数的形参,与被调函数的实参
- 寻找到最匹配的那个可行函数。
- 匹配成功条件
- 如果可行函数集合中只有一个函数并且可以匹配,成功调用。
- 如果可行函数集合中有多个函数可能匹配,进入tie breaker阶段:
- 该可行函数每个实参的匹配都不劣于其他可行函数需要的匹配
- 该可行函数至少有一个实参的匹配优于其他可行函数提供的匹配
- 有且只有一个可行函数满足上述两个原则
- 注意: 有且只有一个可行函数满足,如果有多个可行函数同时满足,就会造成函数调用的二义性
https://blog.csdn.net/jiewaikexue/article/details/120089550
https://blog.csdn.net/qq_53558968/article/details/122757998
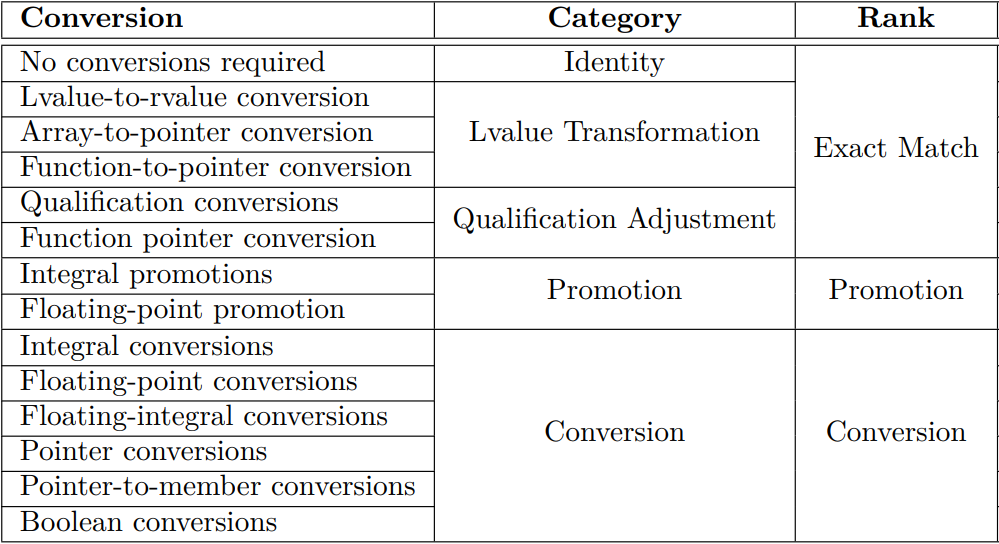
- 上图是重载中的决胜局tie-breaker的匹配表。它们的匹配优先级也是自上往下的,即Exact Match比Promotion更好,Promotion比Conversion更好,可以理解为完全匹配、次级匹配和低级匹配。
- 关于lvalue-to-rvalue转换,看这里
-
我的理解是,涉及到临时对象的都符合左值到右值转换。比如函数值传递,值返回。-
因为编译器期望的是值,而不是内存位置,要从内存位置中把值提取出来,就会发生 lvalue to rvalue conversion
int a = b;=右边期望的就是值,最终b还是会有 lvalue to rvalue conversion。不把b的值取出来,那就不叫赋值了。注意,class type的情况下并不是lvalue to rvalue conversion。因为类对象的
a = b调用的是a.operator=()----来自群讨论
-
-
- 关于Promotion中的 Integral promotion整数提升,有如下几种情况
- 核心意思是,任何小于
int的都可以提升为int。- 任何其余的都叫转换。比如
int到long。这不是提升,是转换。
- 任何其余的都叫转换。比如
short提升为intunsigned short,unsigned char提升为unsigned int或intbool提升为intchar提升为int或unsigned int- 还有一些其他例子
- 核心意思是,任何小于
- 关于Promotion中的 Floating-point promotion 浮点提升,只有一种情况
float提升为double
- 关于Conversion中的Integral Conversion 整数转换,核心意思是任何整数类型都可以互相转换。如果该转换列在“整数类型提升”下,那么它是提升而非转换。
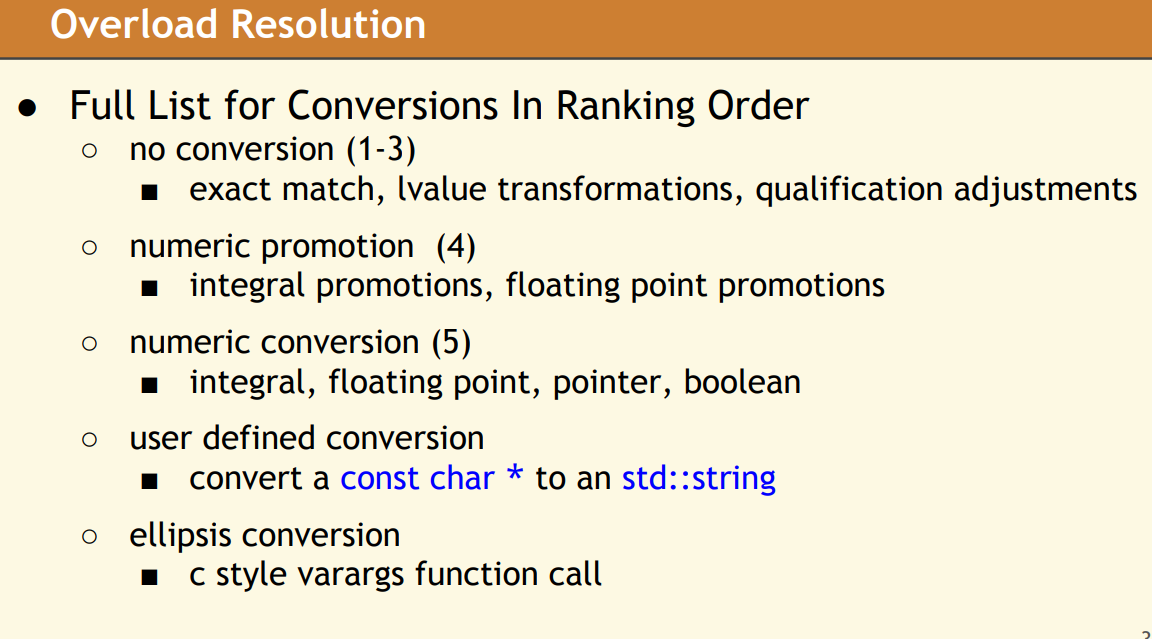
在这张图中,我们看到了上面表格里面的五种转换的对应级别。
但是上面表格只到numeric conversion为止。但是在其下面还有两种:用户定义转换和省略号转换
-
用户定义转换比任何标准转换的级别都要低。
- 用户定义转换的定义是:从 任意类型 隐式转换至 任意类型
- 比如从
const char*到string - 这一步多是调用构造函数或用户定义转换函数。我们提到过的functional-style cast
-
省略号转换是最低级别的。也就是最后最后才考虑。所以经常被用作fallback。
Ranking是查找所有的匹配函数。如果有多个匹配,则进入tie-breaker阶段找到最匹配的,或者是,隐式转换次数(步数)最少的一个。
我们看一个例子
// Avoid doThing_A(double, int, int) { } // overload 1void doThing_A(int, double, double) { } // overload 2int main() { doThing_A(4, 5, 6); // which overload is called?}// Bvoid doThing_B(int, int, double) { } // overload 3void doThing_B(int, double, double) { } // overload 4int main() { doThing_B(4, 5, 6); // which overload is called?}-
A 编译器会报错,二义性。B是3。为什么?
-
针对A,编译器考虑的是:针对重载1,传入的第一个参数不能完美匹配。这时候第一个函数已经输了。然后考虑重载2,传入的第二个参数也不能完美匹配,所以重载2也输了一次。同时这两个函数在同一个级别上。都需要conversion,且没有一个tie breaker可以解决这个问题. 因为此时的两个候选函数的参数的隐式转换中没有哪一个是优于另一个的. 这时候产生了二义性。这种属于double lose
-
针对B,编译器考虑的是:针对重载1和2,传入的第一个参数都可以完美匹配。针对第二个参数,只有第一个重载可以完美匹配。这个时候开始比较第三个参数。二者一致。由于重载1比重载2多赢了一次,进入tie breaker阶段然后选择了重载1。因为我们提到过:
-
该可行函数每个实参的匹配都不劣于其他可行函数需要的匹配
-
该可行函数至少有一个实参的匹配 优于其他可行函数提供的匹配、
-
有且只有一个可行函数满足上述两个原则
-
再看一个例子
void doThing_D(int &) { } // overload 1void doThing_D(int) { } // overload 2int main() { int x = 42; doThing_D(x); // which overload is called?}- 为什么二义性?
- 它们都是完美匹配。因为绑定参数到引用不被认为是一种转换。这就是我们经常犯的错误。如果函数有一个值传递和一个左值引用传递,两个版本,则一定会二义性。这种属于double win
人话分析一下就是double win和double lose都不行, 也不能二者各赢一次各输一次。这样就会二义性。必须要有一个比另一个赢得多。
如何解决重载决议中的二义性?
- 增加或移除一些重载
- 给构造函数增加
explicit修饰符以避免隐式类型转换(杂记2) - 函数模板可以使用SFINAE
- 实例化无效的函数模板直接会被丢弃,不会放入重载集。
- 在函数调用前使用显式类型转换。
- 比如使用C或C++风格cast
- 使用构造函数
有时候编译器选择的最佳函数并不是我们所期望的。这个时候的解决办法之一是想办法让其有二义性,然后编译器就会给你一大堆很他妈长的重载决议错误。给你一个candidate列表。
什么时候使用重载,什么时候使用模板?
- 如果针对某一个特定类型,需要有特定的实现,这个时候使用重载。
- 比如
string的构造函数
- 比如
- 如果针对所有类型都有相同的实现,这个时候使用模板。
- 比如
std::sort。
- 比如
极力避免同时使用函数重载和函数模板。
关于为什么说函数模板不是函数。函数模板在其被实例化的时候会合成一个特化的函数
假设我们有如下函数模板:
template<typename T>void func(T const&);
func(42); // void func<> (int const&);func('a'); // void func<> (char const&);我们在两次函数调用的时候,编译器会使用函数模板帮助我们合成注释里面的函数实例。
- 在实例化过程中,可能会发生当前要实例化的东西已经存在或发生过等效调用。所以如果存在适当的预先的全特化版本,那么那个全特化版本会被编译。(这里就是上面的“关于不要全特化…”部分的例子的原因)
- 也就是有全特化版本了,调用的时候就不再合成,而是直接使用全特化版本。
- 如果没有已经存在的全特化版本,那么编译器此时必须实例化这个全特化版本。编译器会从主模板当中复制它的定义(definition),然后进行适当替换。这就是我们说为什么显式全特化只是一个替换的定义,而不是一个替换的声明。
- 我们想象一下,由于显式全特化的函数模板不参与重载解析。除非重载决议选择最佳匹配的主函数模板后,才检验它的特化以查看最佳匹配者。所以就是假设现在编译器合成出了一个
T是int的函数声明。我们此时有一个显式全特化了int的函数。这时候会考虑显式全特化的那个。所以他会把全特化版本的函数实例化。然后把合成的函数声明给全特化的这个函数拼接到一起。这就是为什么全特化函数没有独立名字。因为它的声明是编译器合成的,定义是我们自己写的。这两个不能分开,自然全特化版本也没有需要独立名字的意义。
限定名、非限定名
限定名(qualified name),故名思义,是限定了命名空间的名称。看下面这段代码,cout和endl就是限定名:
#include <iostream>
int main() { std::cout << "Hello world!" << std::endl;}cout和endl前面都有std::,它限定了std这个命名空间,因此称其为限定名。
如果在上面这段代码中,前面用using std::cout;或者using namespace std;,然后使用时只用cout和endl,它们的前面不再有空间限定std::,所以此时的cout和endl就叫做非限定名(unqualified name)。
依赖名、非依赖名
依赖名(dependent name)是指依赖于模板参数的名称,而非依赖名(non-dependent name)则相反,指不依赖于模板参数的名称。看下面这段代码:
template <class T>class MyClass { int i; vector<int> vi; vector<int>::iterator vitr;
T t; vector<T> vt; vector<T>::iterator viter;};因为是内置类型,所以类中前三个定义的类型在声明这个模板类时就已知。然而对于接下来的三行定义,只有在模板实例化时才能知道它们的类型,因为它们都依赖于模板参数T。因此,T, vector<T>和vector<T>::iterator称为依赖名。前三个定义叫做非依赖名。
更为复杂一点,如果用了typedef T U; U u;,虽然T没再出现,但是U仍然是依赖名。由此可见,不管是直接还是间接,只要依赖于模板参数,该名称就是依赖名。
typedef 和作用域解析运算符:: 和 嵌套类
我们很难把class和namespace联系起来,但是这两个在抽象层次上其实是一个概念。
作用域解析运算符::的作用就是制定某一个范围。但是一旦用在了嵌套类或者类内的typedef,我们就很难理解这层含义。
我们都知道直接访问类静态成员必须使用作用域解析运算符::
但是我们如果要通过作用域解析运算符访问非静态成员,可以吗?当然可以。只不过需要通过对象访问。
举个例子:
class test{ public: class testinner{ //嵌套类 public: int _val; testinner(){} testinner(int x):_val(x){} }; test(){} typedef int testdef;
int s;};
int main(){ test::testinner tt1 = test::testinner(5); //OK test::testinner tt2; //OK 访问嵌套类 test::testdef tt3 = 5; //OK 访问typedef。 test::s = 5; //不行。直接访问的成员必须是静态成员。 test t; t.test::s = 5; //OK 通过对象访问,但是还是脱裤子放屁加了作用域解析运算符。
return 0;}这里我们可以理解为我们需要访问的typedef和嵌套类在test类的命名空间下。我们必须要告知编译器这东西在哪,所以需要通过作用域解析运算符去访问。
至于typedef和嵌套类是否是一个类的成员,我没有查到确切的说法。如果说他们不是成员吧,但是有成员的属性。要是说是成员吧,我们也可以直接访问。但是也有人说嵌套类的static是隐式的。也有人把嵌套类当做一个namespace 来看待。所以我的理解是不要把嵌套类和typedef看做类成员。假设他们可以直接调用即可。
如果嵌套类没有在外部类中实例化,则实例化外部类的时候不会实例化嵌套类内容。
最后说一下必须显式使用typename的情况。
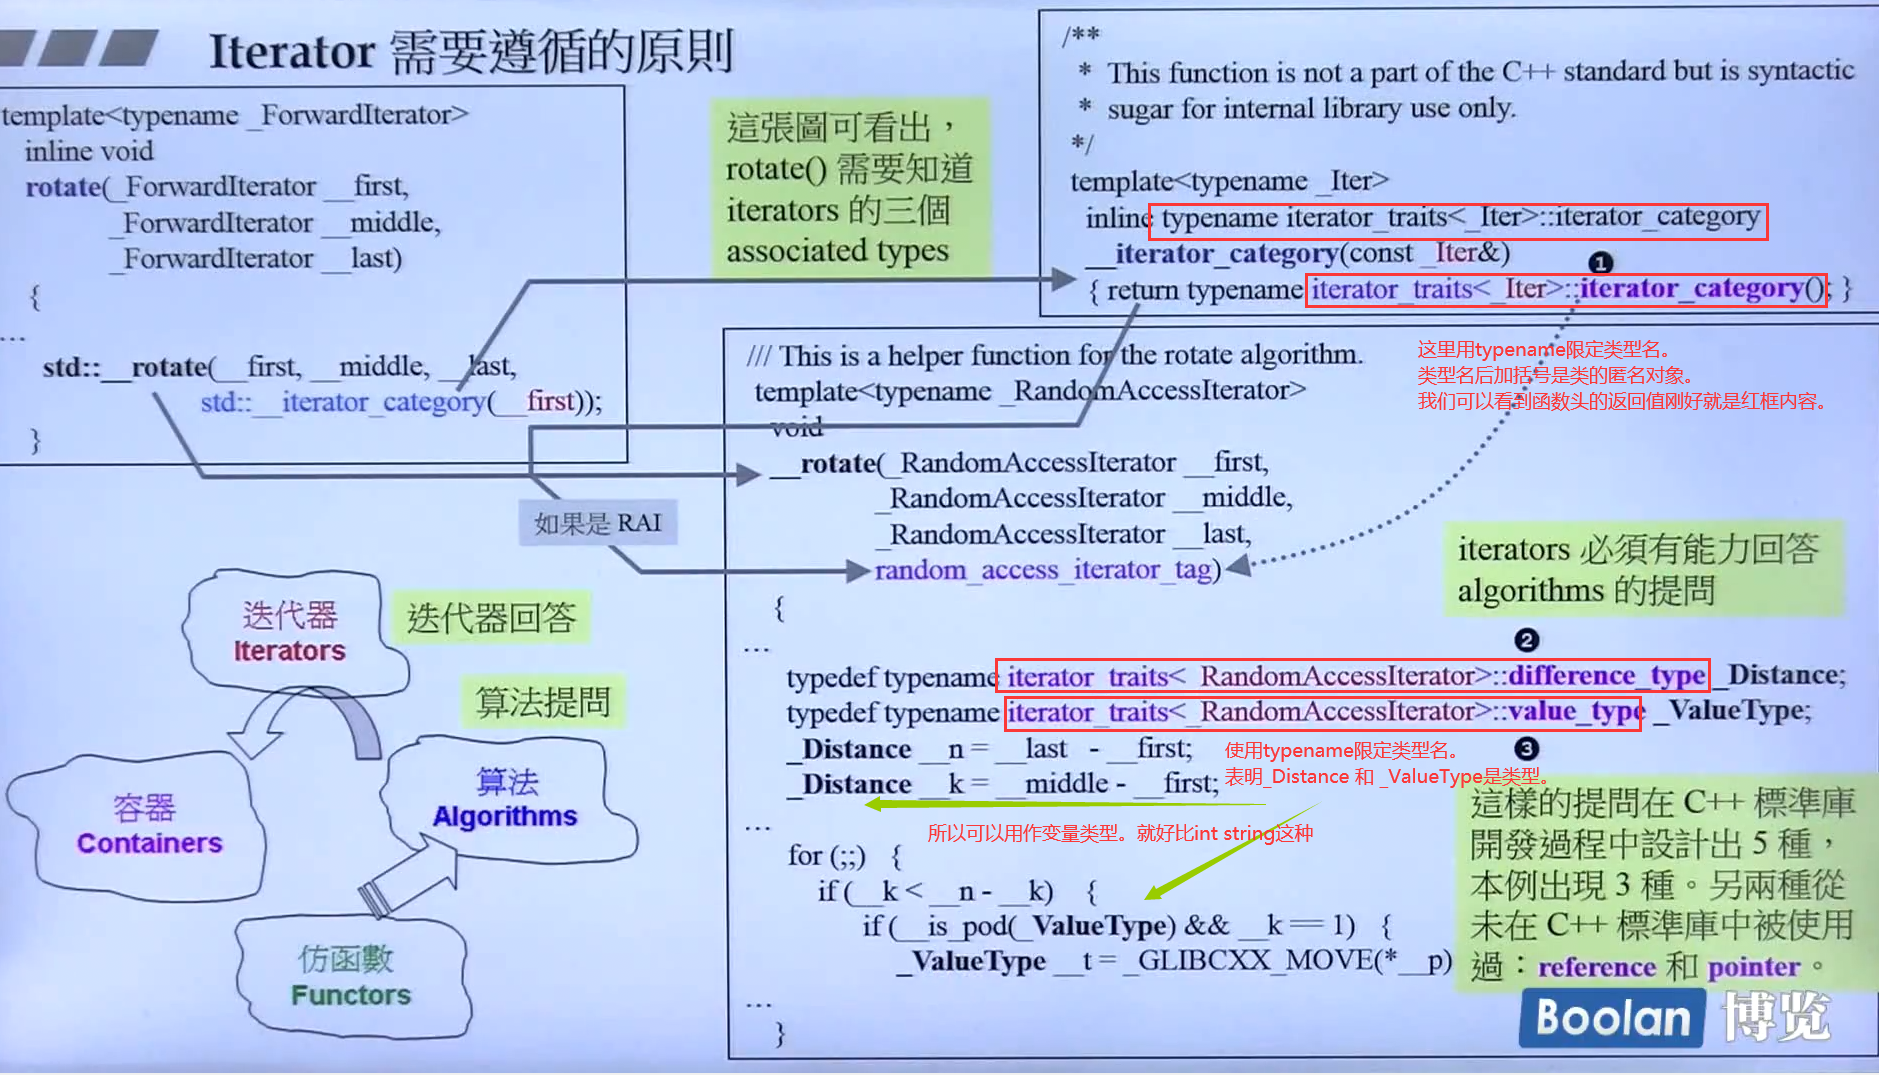
来几个例子:
class test{ public: struct obj{ int _sb; }; obj s; int _val; test(){} test(int x):_val(x){} test(int x, int y){ _val = x; s._sb = y; }};template<typename T>void func(){ test t(5,8); typename T::obj* ptr = &t.s; //这里我们的意思是有一个指针ptr指向了T类里面的obj类型的对象。翻译成人话也就是ptr是一个T::obj类型的指针。但是如果有一个T类里面的obj是一个变量,如static int obj = 8 //那么这就变成了变量乘法。会有歧义。所以使用typedef显式告知编译器 T::obj不是一个变量,而是一个类型。 cout << ptr->_sb << endl;}可能还不够?再来:
typedef iterator_traits<T>::value_type value_type_anothername;//这句话的意思是value_type_anothername是在模板类iterator_traits中的 变量 value_type的别名。
//所以如果有value_type_anothername name = "foward_iterator";//这样是不行的。因为value_type_anothername是一个变量不是类型。//所以我们需要加typedef告知编译器这个是类型
typedef typename iterator_traits<T>::value_type value_type_anothername;//这句话的意思是value_type_anothername是iterator_traits<T>::value_type这个 类型 的别名。
//所以这样可以有value_type_anothername name = "foward_iterator";//因为value_type_anothername 是个类型。就好比int string这种。还不够?再来:
这是我们前文的例子。但是为什么这里不需要加typedef呢?
class test{ public: typedef int inputtype;};
int main(){ test::inputtype x = 4; //这句话等于告诉你 test类下面的inputtype这个东西是int}先送上大佬文章一篇:https://feihu.me/blog/2014/the-origin-and-usage-of-typename/
由于test已经是一个完整的定义,因此编译期它的类型就可以确定下来,也就是说test::inputtype这些名称对于编译器来说也是已知的。
可是,如果是像T::inputtype这样呢?T是模板中的类型参数,它只有等到模板实例化时才会知道是哪种类型,更不用说内部的inputtype。通过前面类作用域一节的介绍,我们可以知道,T::inputtype实际上可以是以下三种中的任何一种类型:
-
静态数据成员
-
静态成员函数
-
嵌套类型
-
typename的作用,简单理解就是强制告诉编译器namespace::objname这个东西是一个类型名而不是变量名。
所以在模板类中,如果想要告知编译器一个使用了::作用域解析运算符的东西是类型,而不是变量,就需要加typename
-
如果直接把这个东西当做一个类型来进行变量的声明,那就不需要搭配
typedef -
如果需要把这个东西当做一个类型来赋予一个别名,那就需要加
typedef
所以,像这样就必须要加:
class test{ public: test(){} typedef int inputtype;};
template<typename T>class test1{ public: test1(){}; typedef typename T::inputtype inputtype; //注意这里,T::inputtype是个类型。比如test::inputtype 就是 int类型};In a declaration or a definition of a template, including alias template, a name that is not a member of the current instantiation and is dependent on a template parameter is not considered to be a type unless the keyword typename is used or unless it was already established as a type name, e.g. with a typedef declaration or by being used to name a base class.
在模板(包括别名模版)的声明或定义中,不是当前实例化的成员且取决于某个模板形参的名字不会被认为是类型,除非使用关键词 typename 或它已经被设立为类型名(例如用 typedef 声明或通过用作基类名)。
特殊成员函数能否是函数模板
- 拷贝构造,拷贝赋值,移动构造,移动赋值。这四个成员函数模板不会被当成真正的特殊成员函数。如果只声明模板,编译器依旧会合成默认的。然后调用默认的。
- 构造函数是个例外。
假设我们有这个类:
class C{ public: template<typename T> C(const T&){ cout <<"called" << endl; }};int main(){ C obj1(10); //called C obj2(obj1); //啥也没有}我们第一反应是啥:这个函数看起来非常像拷贝构造对吧。但是它不是。它是个构造函数模板。
拷贝构造有严格定义:
类
T的拷贝构造函数是首个形参是 T&、const T&、volatile T& 或 const volatile T&,而且要么没有其他形参,要么剩余形参均有默认值的非模板构造函数。这里形参必须是引用,如果按照值传递就会有悖论。比如为了调用复制构造函数,必须复制一下。为了复制,必须调用复制构造函数…
我们这个函数他明显形参类型不是C。所以他不会被当做拷贝构造函数。
-
所以自然而然,符合我们上面说的。我们第一个符合这个构造函数特征。然后类型会被推导。然后
C obj1(10);会被正常调用。 -
然而第二个需要调用拷贝构造的时候,我们等于没有提供,我们此时使用的是编译器合成的。自然啥也没打印。
-
然而构造函数模板不可显式指定模板参数类型。因为显式模板实参列表跟在函数模板名之后,并且因为转换成员函数模板和构造函数成员函数模板是在不使用函数名的情况下调用的,所以没有办法为这些函数模板提供显式模板实参列表。
注意,C obj1(10);这个东西不是调用构造函数。而是直接初始化。我们称之为调用构造函数是因为直接初始化就是在找构造函数。
https://www.cnblogs.com/silentNight/p/5545643.html
https://stackoverflow.com/questions/3960849/c-template-constructor
构造函数模板的延伸
我们有如下代码:
struct foo { foo() = default; // 去掉会无法编译。 // 我们有用户定义的构造函数, 所以编译器不会隐式生成默认构造函数。所以去掉会无法编译。 template<typename T> foo(){ cout <<"ctor" << endl; }};首先, 构造函数可以是模板. 但是此处这个构造函数模板永远无法被调用, 原因是:
-
此处编译器永远无法推导出
T的类型. 因为此时T不在推导上下文中(废话你都没有用到它)。同时也不存在为构造函数显式指定模板实参的方法,因为它们不会通过函数名调用.
所以说: 这个函数模板从未被”调用”过. 调用需要加引号的原因是, 因为其实不是没有调用, 而是不存在这个函数. 因为这个函数模板没有被实例化. 所以从符号角度来讲压根没有这个函数.
如何“显式”指定构造函数模板的模板参数?使用std::in_place_type_t
参考自Raymond Chen的这篇文章,和这篇后续文章 简而言之就是多一个参数。
struct foo { foo() = default; template<typename T1, typename... Args> foo(int a, Args&&... args) { cout <<"ctor foo" << endl; T1(std::forward<Args>(args)...); }};foo f1<int>(1); 这样做肯定不行。但我们可以使用类似于标签分派的方法,把一个东西扔到入参里面让他推导出T1的类型。直接扔到入参内肯定不雅。所以标准库有一个std::in_place_type_t (这玩意和它的兄弟们都是tag类型。比如std::inplace 可以看看杂记5和EFF STL笔记)。
言归正传,我们稍加修改下代码如这样
struct myclass{ myclass(int a, int b){ cout << "ctor myclass" << endl; cout << a << " " << b << endl; };};struct foo { foo() = default; template<typename T1, typename... Args> foo(int a, std::in_place_type_t<T1>, Args&&... args) { cout <<"ctor foo" << endl; T1(std::forward<Args>(args)...); }};int main() { foo f1(1, std::in_place_type_t<int>{}); foo f2(2, std::in_place_type_t<myclass>{}, 2, 3);}这样做就可以看到没有任何问题了。
函数模板参数推导表格和测试函数
测试函数:
template <typename T>void f(const T& param) { std::puts(__PRETTY_FUNCTION__);}
int main() { int p = 2; f(p);}已知A(实参类型)和P(形参类型)推T(T的类型)
P的类型可能是T,const T, T&, const T&, T&&, const T&&
template<typename T>void f(P param){ //...}int main(){ f(A); return 0;}| P | A | T |
|---|---|---|
| T | int | int |
| T | int* | int* |
| T | int& | int |
| T | const int | int |
| T | const int * | const int * |
| T | int * const | int * |
| T | const int & | int |
| T | const int * const | const int * |
| T | char [2] | char * |
| T | const char [12] | const char * |
| T | void (int) | void (*)(int) |
| const T | int | int |
| const T | int * | int * |
| const T | int & | int |
| const T | const int | int |
| const T | const int * | const int * |
| const T | const int & | int |
| const T | const int * const | const int * |
| const T | char [2] | char * |
| const T | const char [12] | const char * |
| const T | void (int) | void (*)(int) |
| T& | int | int |
| T& | int * | int * |
| T& | int & | int |
| T& | const int | const int |
| T& | const int * | const int * |
| T& | const int & | const int |
| T& | const int * const | const int * const |
| T& | char [2] | char [2] |
| T& | const char [12] | const char [12] |
| T& | void (int) | void (int) |
| T&& | int | int & |
| T&& | int * | int *& |
| T&& | int & | int & |
| T&& | const int | const int & |
| T&& | const int * | const int *& |
| T&& | const int & | const int & |
| T&& | const int * const | const int * const & |
| T&& | char [2] | char (&)[2] |
| T&& | const char [12] | const char (&)[12] |
| T&& | void (int) | void (&)(int) |
| T&& | int && | int |
| const T& | int && | int |
https://www.cnblogs.com/5iedu/p/11183878.html
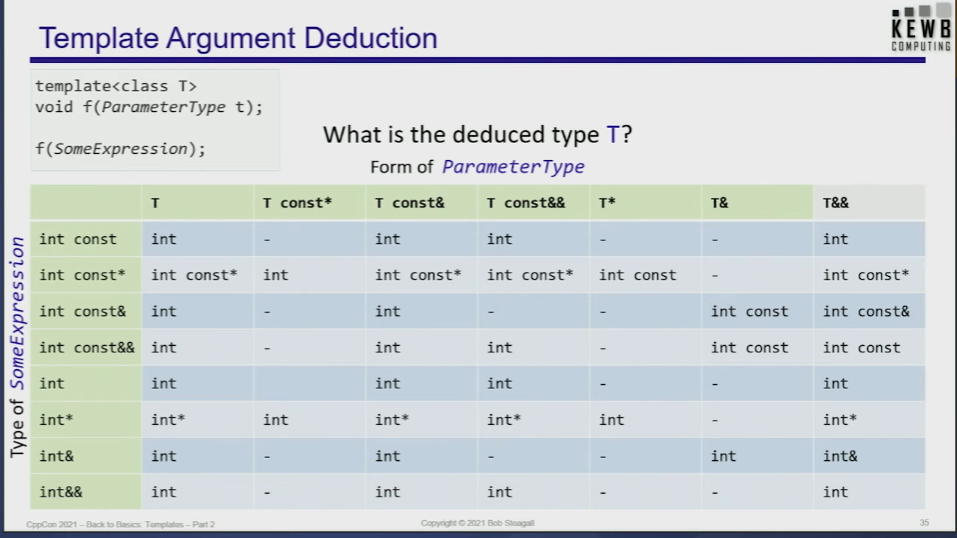
正确区分函数类型和函数指针类型在模板中的使用
template<typename T1>class func{ public: T1* callable; //这里必须是T1* func(T1 outter):callable(outter){}; template<typename ...Args> void call(Args&& ...args){ callable(forward<Args>(args)...); } void test(){ std::puts(__PRETTY_FUNCTION__); }};template<typename T1>class test;template<typename T1, typename... T2>class test<T1(T2...)>{//实参匹配 public: template<typename Func, typename ...Args> void construct(Func ptr, Args&& ...args){ func<T1(T2...)> obj(ptr); obj.call(forward<Args>(args)...); obj.test(); }
};int testsor(float b, int c){ cout << b << endl; cout << c << endl; cout <<"success" << endl; return 1;}int main(){ test<int(float, int)> obj; obj.construct(testsor, 2.5f, 234); return 0;}为啥上面的部分必须是T1*呢?
因为T1(T2...)会被推导为函数类型而非函数指针类型。也就是传入func的模板参数时,func的T1会被推导为int(float, int)。
在杂记3中,我们区分了函数类型和函数指针类型。函数类型不可以声明变量。所以此时必须额外增加一个*让其转换为指针类型。
https://stackoverflow.com/questions/17446220/c-function-types
什么是元函数
首先,这个词并不是官方定义的名词。元函数表面看起来非常高雅,但其实就是一个只在编译器进行计算的函数。它和普通的函数(运行期函数)具有截然不同的行为。这个函数不仅仅局限于函数,拥有同样作用的类依旧可以叫做元函数。我们其实可以认为元函数实现了类型萃取的功能。
一个并不官方的元函数定义:
-
输入(即参数)与输出(即返回值)均只包含两种类型:
- 类型(名)
- 比如我们的类型萃取中的类型定义,在某个函数或者类内实施一个
typedef/using
- 比如我们的类型萃取中的类型定义,在某个函数或者类内实施一个
- 整形常量
- 比如我们固化某一个类型的某一个值为特定的值。
- 类型(名)
-
可以返回一个或多个值,但不能没有返回值。
-
此处返回值是广义的。比如下面的
type就算做返回值。 -
template <bool B, class L, class R>struct IF{typedef R type;};
-
-
没有副作用:元函数在计算过程中既不能改变参数的值,也不具备“向控制台输入输出”之类的附加功能。
- 元函数其实更多的作用是提供一种注册登记 或 映射的作用。
https://stackoverflow.com/questions/32471222/c-are-trait-and-meta-function-synonymous
完美转发的失败场景----effective modern c++ 条款30
什么叫完美转发失败了?
假设我们有源函数f和其包装的转发函数wrapperf
如果下面两个函数调用导致的操作不同,则称之为失败。
f(expression);wrapperf(expression);一般来说完美转发会在下面的两个条件中任何一个成立的时候失败:
- 编译器无法为一个或多个
wrapperf的形参推导出型别结果。在此情况下,代码无法编译通过。- 也就是模板参数推导失败。
- 编译器为一个或多个
wrapperf的形参推导出了错误的型别结果 。这里所谓错误的,既可以指wrapperf根据型别推导结果的实例化无法通过编译,也可以指以wrapperf推导而得的型别调用与直接以传递给wrapperf的实参调用行为不一致。这种分裂行为的源泉之一 ,可能在于f是个重载函数的名字,然后,依据不正确的推导型别,wrapperf里调用到的f重载版本,就与直接调用f的版本有异。- 也就是模板参数推导结果是错误的。
情况之一:花括号初始化器(大括号初始化物)
假设我们有如下函数:
void f(const vector<int>& t){ //目标函数 cout <<"called" << endl;}
template<typename... T>void wrapperf(T&&... args){ //转发函数 f(forward<T>(args)...);}
int main(){ f({1,2,3,4,5}); // OK wrapperf({1,2,3,4,5}); // 不行 return 0;}为啥第一个行,第二个不行?
我们知道,编译器会进行函数的入参和形参比较,进行隐式类型转换,尽最大努力成功调用函数。
-
第一个行的原因是编译器进行了隐式类型转换。编译器会把
{1,2,3,4,5}隐式转换成vector。 -
第二个不行的原因是如果有转发函数,则没有隐式类型转换。这时候是通过类型推导的方式来获取入参的类型。但是花括号初始化器是不推导语境。注意这里是花括号初始化器而非
std::initializer_list-
形参 P,其实参 A 是花括号初始化器列表,但 P 非 std::initializer_list、到它的引用(可以有 cv 限定),或者 (C++17 起)到数组的引用
-
解决方案:
我们在聚合初始化中提到了:auto 变量在以花括号初始化器完成初始化时,型别推导可以成功。这样的变量会被视为 std::initializer_list 类型对象。这样一来就没问题了。因为vector有一个接受 std::initializer_list 对象的构造函数。
void f(const vector<int>& t){ //目标函数 cout <<"called" << endl;}
template<typename... T>void wrapperf(T&&... args){ //转发函数 f(forward<T>(args)...);}
int main(){ auto param = {1,2,3,4,5}; f(param); // OK wrapperf(param); // OK return 0;}情况之二:把0或NULL当做空指针
NULL就是0。杂记3中提到了:
而到了C++中,则变成了
#define NULL 0
所以这个情况模板推导会把它推导为int而不是目标类型的空指针。为了避免这个问题可以使用nullptr
情况之三:仅有声明的整型static const成员变量
涉及到常量替换。而且较为依靠编译器和链接器。不做介绍
情况之四:重载的函数和模板名字
假设我们有下面代码:
void f(int(*pf)(int)){ //目标函数 pf(100);}
template<typename... T>void wrapperf(T&&... args){ //转发函数 f(forward<T>(args)...);}
int testfunc(int a){ cout <<"testfunc" << endl; return 10;}int testfunc(int a, int b){ cout <<"testfunc overload" << endl; return 20;}
int main(){ f(testfunc); // OK wrapperf(testfunc); //不行 return 0;}-
第一个可以的原因是,编译器能知道我们具体传入的函数到底是哪个版本。因为此处不涉及到类型推导。而是重载决议。
-
第二个不可以的原因是,这也是不推导语境。
testfunc没有类型信息。也就是入参为函数的时候且有多个候选函数的时候,是不推导语境。-
形参
P,其实参A是一个函数,没有函数或有多个函数与P匹配的重载集,或包含一个或多个函数模板的重载集的时候属于不推导语境
-
解决方案
- 把传入函数换成传入函数指针即可。或者是强制类型转换一下。
int(*pf)(int) = testfunc;f(pf); // OKwrapperf(pf);// OK情况之五:位域
不太了解,不做介绍
关于函数形参中的省略号
它其实还是变长参数列表。只不过C和C++规则有点不一样。
因为变长形参对于重载决议而言具有最低的优先级,所以它们常被用作 SFINAE 中的万应后备(catch-all fallback)。
https://zh.cppreference.com/w/cpp/language/variadic_arguments
成员函数指针,成员指针和模板的搭配和坑点
我们在2.6提到了一部分。我们这里举个例子
class obj{ public: bool func(int, int){ std::cout <<"called" << endl; } bool func2(){ std::cout <<"called" << endl; } bool func3(int){ std::cout <<"called" << endl; }};
template<typename ret, typename... Args>struct myclass{ myclass() = default;
template<typename T> myclass(ret(T::*ptr)(Args...)){ //成员指针的表达方法。 std::puts(__PRETTY_FUNCTION__); };};
int main(){ myclass<bool, int, int> obj(&obj::func);}/*myclass<ret, Args>::myclass(ret (T::*)(Args ...)) [with T = obj; ret = bool; Args = {int, int}]*/- 我们可以清楚地看到,
ret和args形参包都被正确匹配了。T也被正确匹配了。 &obj::func只是提取成员函数的地址。obj是可以被匹配到T的。从字面上就能看出来。
看一下函数模板中的情况:
template<typename T, typename ret>void testextract1(ret (T::*pf)){ std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret, typename... Args>void testextract2(ret (T::*pf)){ std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret, typename... Args>void testextract22(ret T::*pf){ //同2 std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret, typename... Args>void testextract3(ret (T::*pf)(Args...)){ std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret, typename... Args>void testextract44(ret T::*pf(Args...)){ //错误 std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret, typename... Args>void testextract4(ret (T::*pf)()){ //特殊 std::puts(__PRETTY_FUNCTION__);}
int main(){ testextract1(&obj::func); testextract2(&obj::func); testextract3(&obj::func); testextract4(&obj::func);//错误 testextract4(&obj::func2);}void testextract1(ret T::*) [with T = obj; ret = bool(int, int)]void testextract2(ret T::*) [with T = obj; ret = bool(int, int); Args = {}]void testextract3(ret (T::*)(Args ...)) [with T = obj; ret = bool; Args = {int, int}]void testextract4(ret (T::*)()) [with T = obj; ret = bool; Args = {}]- 注意,返回值类型和函数指针类型不能分离。这俩是在一起的。所以不能不关心返回值类型。
- 前两个例子当中,成员函数指针的类型是
ret。而T只不过是绑定的对应对象的类型。为什么? - 因为c++语法需要通过
T::*外围是否有括号来判断是成员函数类型或是成员类型。 - 前两个,我们能看到
ret T::*之后没有括号。然后ret整个被推导为指向该类成员的完整类型。 - 后两个,我们能看到
ret(T::*)之后有括号。然后ret被推导为函数的返回值类型。也就是类型被正确的拆分了。 - 注意,
testextract44是错误的。ret T::*pf(Args...)暗示了pf是一个指向类T的数据成员的指针,并期望这个数据成员本身是一个函数类型。但是这是不允许的。因为C++不允许数据成员是函数。 - 注意,此处针对例子1、2、22所谓的返回值类型其实不准确。应该称之为成员类型。
- 前两个例子当中,成员函数指针的类型是
- 从第二个例子可以看出,在有可变参数的情况下,如果函数没有涉及到可变参数,则可变参数会变成空类型。因为允许为空。
- 从第三个例子可以看出,在有可变参数的情况下,如果涉及到可变参数,则可变参数可以正确推导。
- 从第四个例子可以看出,带有可变参数的情况下,如果参数位置是空括号,等同于参数是
void。所以testextract4(&obj::func);是错误的。因为其形参类型是int, int。所以testextract4(&obj::func2);是可以的。 - 所以在要求匹配成员函数指针的时候,根据需求不同,需要给出不同的函数签名。也就是我们是否关心参数类型。
template<typename ret, typename T>void require1(ret (T::*)){ //不关心函数参数的时候 std::puts(__PRETTY_FUNCTION__);}template<typename ret, typename T, typename... Args>void require2(ret (T::*)(Args...)){ //关心函数参数的时候 std::puts(__PRETTY_FUNCTION__);}int main(){ require1(&obj::func); require1(&obj::func2); require2(&obj::func); require2(&obj::func2);}理解上述的区别,以及成员指针和成员函数指针的区分方式
先说结论:
-
成员指针包含成员函数指针。也就是成员函数指针是成员指针的子集。
- 成员指针为形参的函数既可以接受成员函数也可以接受成员变量。同时成员函数的参数不受限制。
-
同时,以成员函数指针为形参的函数可以和以成员指针为形参的函数形成重载
- 成员函数指针为形参的函数比成员指针为形参的函数更为特化。
- 这也是区分成员函数指针和成员指针的一个方式。
我们在杂记2中提到过类成员变量指针和类成员指针的具体语法。他们俩最大的区别就是后面有没有括号。
为了方便理解,我们加上名字,然后换为更明显的语法。
ret(T::*pf)/ret T::*pf- 后面没有括号。然后
ret整个被推导为整个成员指针类型。注意。这个时候T::*pf本身带不带括号区别不大。因为此时都被认为是成员指针。(包含数据成员和函数成员)
- 后面没有括号。然后
ret(T::*pf)()- 后面有括号。然后
ret被推导为函数指针指向的函数的返回值类型
- 后面有括号。然后
如何理解?为什么?
- 第一种,我们只知道
pf是一个成员指针。ret是一个成员指针的类型,T是其类类型。如果我们传入一个成员函数指针,则ret就是成员指针类型。 - 第二种,我们知道
pf是一个成员函数指针,所以ret是一个函数的返回值类型,T是其类类型。它只能指向成员函数,不能指向成员变量。
template<typename T, typename ret>void testextractmember1(ret (T::*pf)){ std::puts(__PRETTY_FUNCTION__);}
template<typename T, typename ret>void testextractmember2(ret T::*pf){ std::puts(__PRETTY_FUNCTION__);}
testextractmember1(&obj::sb);testextractmember2(&obj::sb);testextractmember1(&obj::func3);testextractmember2(&obj::func3);
//void testextractmember1(ret T::*) [with T = obj; ret = int]//void testextractmember2(ret T::*) [with T = obj; ret = int]//void testextractmember1(ret T::*) [with T = obj; ret = bool(int)]//void testextractmember2(ret T::*) [with T = obj; ret = bool(int)]我们可以看到。在针对成员指针的测试中,无论是数据成员指针还是函数成员指针都可以被匹配。
格外注意:函数就算带参数,也可以直接被成员指针接受。
template<typename ret, typename T>void diff(ret(T::*pf)){ //成员指针 cout <<"called variable" << endl;}int main(){ diff(&obj::val); //called variable diff(&obj::func2); //called variable diff(&obj::func3);//called variable 注意带参数的也可以}- 这个测试证明了:成员指针为形参可以接受成员函数和成员变量。
template<typename ret, typename T>void diff(ret(T::*pf)()){ //成员函数指针 cout <<"called func" << endl;}
int main(){ diff(&obj::val); //报错 diff(&obj::func2); diff(&obj::func3);//报错}- 这个测试证明了:成员函数指针为形参只可以接受成员函数。并且要参数匹配。
template<typename ret, typename T>void diff(ret(T::*pf)){ cout <<"called variable" << endl;}template<typename ret, typename T>void diff(ret(T::*pf)()){ cout <<"called func" << endl;}int main(){ diff(&obj::val); //called variable diff(&obj::func2); //called func diff(&obj::func3); //called variable 格外注意这里匹配的问题
}-
这个测试证明了:以成员函数指针为形参的函数可以和以成员指针为形参的函数形成重载,且在一定程度上可以正确匹配对应类型。
- 成员函数指针为形参的函数比成员指针为形参的函数更为特化。
- 这也是区分成员函数指针和成员指针的一个方式。
-
但是:为什么
diff(&obj::func3);匹配到了成员指针而非成员函数指针?- 因为成员函数指针的版本,函数指针的形参不一致。所以这个版本无法匹配,但是成员指针的版本总可以匹配。
https://stackoverflow.com/questions/72926596/type-deduction-for-a-member-function-pointer
继承自可变参数包(多重继承),类模板参数推导和用户定义的推导指引
12.4节。
我们看一个C++17的代码
template<class... Ts>struct Foo : Ts... { //继承自可变参数包 using Ts::operator()...; //使用using引入所有继承的父类的operator()};template<class... Ts>Foo(Ts...) -> Foo<Ts...>; //用户定义的推导指引 C++20起可以移除这段// 因为CTAD从C++17引入,然后C++20放宽了限制。聚合类可以不需要用户定义推导指引。
int main() { Foo foo{ [](int v){std::cout << "int";}, [](double v){std::cout << "double";}, }; foo(1); foo(1.0);}-
首先,关于继承自可变参数包。
-
假设可变参数包
Ts...的实参是<T1, T2, T3> -
则这个
Foo相当于struct Foo: T1, T2, T3{};
-
-
然后关于使用
using引入所有继承的父类的operator()。这个没啥好解释的 -
最后关于用户定义的推导指引,意思是告诉编译器,依照传入
Foo的构造函数的参数的类型来推导Ts... -
整个这段代码的意思是,我们看到我们构造函数传入了两个
lambda表达式。由于继承自可变参数包,则这个Foo相当于继承自这两个lambda表达式的类型。我们也知道lambda类型相当于一个匿名类,含有operator(),所以我们使用using来引入所有继承的父类的operator()。最后我们可以直接调用。
https://zh.cppreference.com/w/cpp/language/class_template_argument_deduction
一些实际参考案例
根据任意可调用对象获取返回值类型/某一参数类型
下面这段代码的目的是针对任意可调用对象获取返回值类型。
template <typename T>struct GetRet { //主模板,如果内部含有operator()就取它的类型 private: using DT = std::decay_t<T>; public:
using type = typename GetRet<decltype(&DT::operator())>::type; //比较特殊,因为decltype(&DT::operator())是获取成员函数指针类型。在杂记4中提到过。然后递归调用 using type1 = decltype(declval<T>()()); //展开是这样declval<T>().operator()()
void pivot(){ std::puts(__PRETTY_FUNCTION__); std::cout << std::is_same_v<decltype(&DT::operator()), int(T::*)()>; // true 注意是成员函数指针类型 std::cout << std::endl; }};
// 函数类型的特化template <typename R, typename... Args>struct GetRet<R(Args...)> { using type = R; void pivot(){ std::puts(__PRETTY_FUNCTION__); }};
// 函数指针类型的特化template <typename R, typename... Args>struct GetRet<R(*)(Args...)> { using type = R; void pivot(){ std::puts(__PRETTY_FUNCTION__); }};
// 非静态成员函数指针类型的特化template <typename T, typename R, typename... Args>struct GetRet<R(T::*)(Args...)> { using type = R; void pivot(){ std::puts(__PRETTY_FUNCTION__); }};// const非静态成员函数指针类型的特化template <typename T, typename R, typename... Args>struct GetRet<R(T::*)(Args...) const> { using type = R; void pivot(){ std::puts(__PRETTY_FUNCTION__); }};
template <typename T>using GetRet_t = typename GetRet<T>::type;
// 测试用例int f() { //普通函数 return 0;}struct T1 { //非静态成员函数 int mem_func(){ cout <<"T1 mem_func" << endl; return 0; }};
struct T2 { int operator()(){ //operator() cout <<"T2 ()" << endl; return 0; }};
int main() { GetRet_t<decltype(f)> a; // 函数类型
GetRet_t<decltype(&f)> b; // 函数指针类型
GetRet_t<T2> c; // 函数对象类型 -- 仿函数
auto lamb = []()->int{return 0;}; // lambda类型 GetRet_t<decltype(lamb)> d;
GetRet_t<decltype(&T1::mem_func)> e; // 非静态成员函数类型
GetRet_t<std::function<int()>> g; //函数对象类型 -- std::function对象
std::cout << std::is_same_v<std::decay_t<decltype(a)>, int>; // true std::cout << std::is_same_v<std::decay_t<decltype(b)>, int>; // true std::cout << std::is_same_v<std::decay_t<decltype(c)>, int>; // true std::cout << std::is_same_v<std::decay_t<decltype(d)>, int>; // true std::cout << std::is_same_v<std::decay_t<decltype(e)>, int>; // true std::cout << std::is_same_v<std::decay_t<decltype(g)>, int>; // true std::cout << std::is_same_v<decltype(declval<T2>()()), int>; // true std::cout << std::endl;
GetRet<decltype(f)> x1; GetRet<decltype(&f)> x2; GetRet<T2> x3; GetRet<decltype(lamb)> x4; GetRet<decltype(&T1::mem_func)> x5; GetRet<std::function<int()>> x6; x1.pivot(); x2.pivot(); x3.pivot(); x4.pivot(); x5.pivot(); x6.pivot();/*void GetRet<R(Args ...)>::pivot() [with R = int; Args = {}]void GetRet<R (*)(Args ...)>::pivot() [with R = int; Args = {}]void GetRet<T>::pivot() [with T = T2]void GetRet<T>::pivot() [with T = main()::<lambda()>]void GetRet<R (T::*)(Args ...)>::pivot() [with T = T1; R = int; Args = {}]void GetRet<T>::pivot() [with T = std::function<int()>]*/}上面的例子中,我们可以清楚的复习几个要点
-
函数指针类型和函数类型不是一个东西
-
成员函数和模板搭配的语法
-
还有
decltype获取成员函数指针类型的语法。- 尤其要注意,在主模板中,我们可以使用
type或type1。而且要注意type里面的decltype(&DT::operator())会获取到成员函数指针类型int(T::*)(),所以是递归调用,然后我们通过它会匹配到成员函数指针类型的特化中,成功获取到int。这也是为什么依旧要保留成员函数指针类型的特化。
- 尤其要注意,在主模板中,我们可以使用
-
我们上面弄了一堆特化,非常麻烦。不如直接使用
type1,也就是比较直观语义的declval创建对象然后调用operator()-
declval可以调用任意可调用对象,所以我们不需要区分函数类型和函数指针类型了。也就是不需要函数类型特化和函数指针类型特化的两个模板了。 -
这时候结果就会变成:
-
void GetRet<T>::pivot() [with T = int()]void GetRet<T>::pivot() [with T = int (*)()]void GetRet<T>::pivot() [with T = T2]void GetRet<T>::pivot() [with T = test()::<lambda()>]void GetRet<R (T::*)(Args ...)>::pivot() [with T = T1; R = int; Args = {}]void GetRet<T>::pivot() [with T = std::function<int()>]
-
关于获取某一特定参数的类型,就需要使用上面的type了,也就是&DT::operator()的方法,然后手动进行参数匹配,详细见这里