
修改顺序, 指令重排,缓存一致性,内存屏障和内存模型
修改顺序
对一个原子变量的所有修改操作总是存在一定的先后顺序, 且所有线程都认可这个顺序, 即使这些修改操作是在不同的线程中执行的. 这个所有线程一致同意的顺序就称为修改顺序 (modification order). 这意味着
- 两个修改操作不可能同时进行, 一定存在一个先后顺序. 这很容易理解, 因为这是原子操作必须保证的, 否则就有数据竞争的问题.
- 即使每次运行的修改顺序可能都不同, 但所有线程看到的修改顺序总是一致的. 如果线程 a 看到原子变量 x 由 1 变成 2, 那么线程 b 就不可能看到 x 由 2 变成 1.
无论使用哪种内存顺序, 原子变量的操作总能满足修改顺序一致性, 即使是最松散的 memory_order_relaxed. 我们来看一个例子
std::atomic<int> a{0};
void thread1() { for (int i = 0; i < 10; i += 2) a.store(i, std::memory_order_relaxed);}
void thread2() { for (int i = 1; i < 10; i += 2) a.store(i, std::memory_order_relaxed);}
void thread3(vector<int> *v) { for (int i = 0; i < 10; ++i) v->push_back(a.load(std::memory_order_relaxed));}
void thread4(vector<int> *v) { for (int i = 0; i < 10; ++i) v->push_back(a.load(std::memory_order_relaxed));}
int main() { vector<int> v3, v4; std::thread t1(thread1), t2(thread2), t3(thread3, &v3), t4(thread4, &v4); t1.join(), t2.join(), t3.join(), t4.join();
for (int i : v3) cout << i << " "; cout << endl; for (int i : v4) cout << i << " "; cout << endl; return 0;}上面的代码创建了 4 个线程. thread1 和 thread2 分别将偶数和奇数依次写入原子变量 a, thread3 和 thread4 则读取它们. 最后输出 thread3 和 thread4 每次读取到的值. 程序运行的结果可能是这样的
1 8 7 7 7 9 9 9 9 90 2 8 8 8 7 9 9 9 9-------------------1 2 5 6 9 9 9 8 8 81 3 2 5 9 8 8 8 8 8虽然每次运行的修改顺序不同, 各个线程也不太可能看到每次修改的结果, 但是它们看到的修改顺序是一致的. 例如 thread3 看到的顺序是 8 7 9, 那么thread4看到的顺序也是8 7 9. thread3看到的顺序是1 5 9 8 那么 thread4看到的顺序一样是1 5 9 8
指令重排
Happens-Before 关系
A、B 是两个在多核 CPU 上执行的操作。如果 A happens-before B,那么 A 所产生的内存变化会在 B 操作执行之前被看到(visible)。
简而言之, 如果操作 a “happens-before” 操作 b, 则操作 a 的结果对于操作 b 可见. happens-before 的关系可以建立在用一个线程的两个操作之间, 也可以建立在不同的线程的两个操作之间.
不管我们使用什么编程语言,在同一个线程下的顺序语句总是遵循 happens-before 原则的。
就像下面代码所示:
int a, b;
void foo() { a = 42; b = a;
assert(b == 42);}在单线程的情况下,断言是永远不会为假的。(不然这还怎么写程序…)
但这并不代表 b 在内存中后于 a 被修改。就像下面这段伪代码所示的:
mov %eax, 42mov (b), %eaxmov (a), %eax虽然这并不能说明编译器就是这么处理的,但足以说明程序语义上的 happens-before 不能代表操作是真的 happened before 了。
Happens-before 的第一种场景: sequenced before(单线程)
单线程的情况很容易理解. 函数的语句按顺序依次执行, 前面的语句先执行, 后面的后执行. 正式地说, 前面的语句总是 “sequenced-before” 后面的语句. 显然, 根据定义, sequenced-before 具有传递性:
- 如果操作
a“sequenced-before” 操作k, 且操作k“sequenced-before” 操作b, 则操作a“sequenced-before” 操作b.
Sequenced-before 可以直接构成 happens-before 的关系. 如果操作 a “sequenced-before” 操作 b, 则操作 a “happens-before” 操作 b. 这是最基本的场景:
a = 42; // (1)cout << a << endl; // (2)语句 (1) 在语句 (2) 的前面, 因此语句 (1) “sequenced-before” 语句 (2), 也就是 (1) “happens-before” 语句 (2). 所以 (2) 可以打印出 (1) 赋值的结果且没有任何问题
Happens-before 的第二种场景: synchronizes-with 和 inter-thread happens-before(多线程)
一般来说, 如果在多个线程间没有正确的同步操作, 就无法保证两个操作之间有 happens-before 的关系. 如果我们通过一些手段, 让不同线程的两个操作同步, 我们称这两个操作之间有 synchronizes-with 的关系. 稍后我们会详细讨论如何组合使用 6 种内存顺序, 让两个操作达成 synchronizes-with 的关系.
如果线程 1 中的操作 a “synchronizes-with” 线程 2 中的操作 b, 则操作 a “inter-thread happens-before” 操作b. 此外 synchronizes-with 还可以 “后接” 一个 sequenced-before 关系组合成 inter-thread happens-before 的关系:
- 如果操作 a “synchronizes-with” 操作 k, 且操作 k “sequenced-before” 操作 b, 则操作 a “inter-thread happens-before” 操作 b.
Inter-thread happens-before 关系则可以 “前接” 一个 sequenced-before 关系以延伸它的范围; 而且 inter-thread happens-before 关系具有传递性:
- 如果操作 a “sequenced-before” 操作 k, 且操作 k “inter-thread happens-before” 操作 b, 则操作 a “inter-thread happens-before” 操作 b.
- 如果操作 a “inter-thread happens-before” 操作 k, 且操作 k “inter-thread happens-before” 操作 b, 则操作 a “inter-thread happens-before” 操作 b.
正如它的名字暗示的, 如果操作 a “inter-thread happens-before” 操作 b, 则操作 a “happens-before” 操作 b. 下图展示了这几个概念之间的关系:
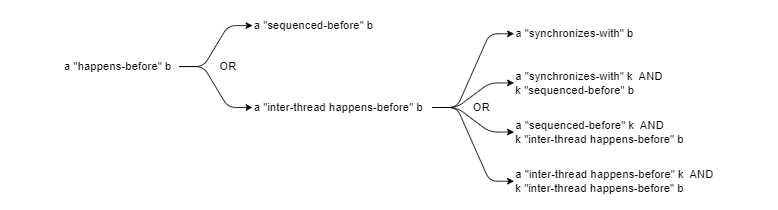
注意, 虽然 sequenced-before 和 inter-thread happens-before 都有传递性, 但是 happens-before 没有传递性.
例子1:
int data;std::atomic_bool flag { false };
// Execute in thread Avoid producer() { data = 42; // (1) flag.store(true); // (2)}
// Execute in thread Bvoid consume() { while (!flag.load()); // (3) assert(data == 42); // (4)}让两个函数分别在两个线程中运行,(4) 所示的断言将有一定几率 为假,这是为什么呢?虽然我们使用原子量 flag 作为“同步信号”,而且同一个线程中 happens-before 原则也一定会被遵循,但我们并不能保证 (4) 执行时 (1) 的修改一定会被 B 线程看到, 可能是2-3-4-1这个顺序。这是由于现代处理器对于程序可能会采取指令重排来提高运行效率,CPU 的读写 Cache 也可能并没有写回内存。
所以,企图在多线程环境中通过某原子量来做非原子量的 Synchronization 并不是可靠的(当没有 Memory Order 的约束时候)。
当然,上面的代码其实基本上不会为假,因为 C++ 默认使用 memory_order_seq_cst顺序约束。而且 x86 架构中也做不到松弛(memory_order_relaxed)内存模型。也就是说,这种过于松弛的模型理论上存在,但其实不会发生。因为如果允许这个级别的松弛那么代码没法写了。
例子2, 假设下面的代码中 unlock() 操作 “synchronizes-with” lock() 操作:
void thread1() { a += 1 // (1) unlock(); // (2)}
void thread2() { lock(); // (3) cout << a << endl; // (4)}假设直到 thread1 执行到 (2) 之前, thread2 都会阻塞在 (3) 处的 lock() 中. 那么可以推导出:
- 根据语句顺序, 有 (1) “sequenced-before” (2) 且 (3) “sequenced-before” (4);
- 因为 (2) “synchronizes-with” (3) 且 (3) “sequenced-before” (4), 所以 (2) “inter-thread happens-before” (4);
- 因为 (1) “sequenced-before” (2) 且 (2) “inter-thread happens-before” (4), 所以 (1) “inter-thread happens-before” (4); 所以 (1) “happens-before” (4).
因此 (4) 可以读到 (1) 对变量 a 的修改
在上面的例子中,我们主要讲述的是指令重排。但是内存屏障不仅仅是为了防止指令重排,也会解决缓存一致性问题。在最后我们会详细探讨这其中的关系。
缓存一致性
我们都知道二维数组横向遍历比纵向遍历要快。为什么?
- 我们知道有L1 L2 L3三级cache。然后才是内存。CPU需要把内存里的数据读到cache中。但是CPU为了最大化利用cache line的能力,一般会读取一个固定大小的数据区块。一般来说 L3 Cache 比 L1 Cache 和 L2 Cache 大很多,这是因为 L1 Cache 和 L2 Cache 都是每个 CPU 核心独有的,而 L3 Cache 是多个 CPU 核心共享的。
这也就是为什么连续内存操作会比较快,也是为什么内存对齐十分重要。因为如果起点在奇数位就会有二次操作。
CPU cache到内存的映射有三种:
- 直接映射
- 直接映射通俗易懂。就是内存地址映射到的cache line是固定的。比较好找。但是问题在于这个数量非常少。如果多个数据抢占同一个cache line,就会发生cache频繁的换入换出。
- 全相连映射
- 全相连映射的意思是任意一个内存地址可以映射到任意一个cache line。也就是见缝插针。问题在于在寻找一个内存地址是否已被映射的时候,需要遍历每一个cacheline
- 组相连映射
- 组相连映射也就是组间采用直接映射,组内采用全相连映射。
CPU cache读取过程
假设我们的L1 Cache Line是64字节:
比如,有一个 int array[100] 的数组,当载入 array[0] 时,由于这个数组元素的大小在内存只占 4 字节,不足 64 字节,CPU 就会顺序加载数组元素到 array[15],意味着 array[0]~array[15] 数组元素都会被缓存在 CPU Cache 中了,因此当下次访问这些数组元素时,会直接从 CPU Cache 读取,而不用再从内存中读取,大大提高了 CPU 读取数据的性能。
事实上,CPU 读取数据的时候,无论数据是否存放到 Cache 中,CPU 都是先访问 Cache,只有当 Cache 中找不到数据时,才会去访问内存,并把内存中的数据读入到 Cache 中,CPU 再从 CPU Cache 读取数据。
我们刚提到过直接映射会把内存的固定地址映射到固定的cache line。一般来说是通过取模运算来确定的。所以会存在多个内存区块映射到同一个cache line位置上。这时候就要区分他们了。为了区别不同的内存块,在对应的 CPU Line 中我们还会存储一个组标记(Tag)。这个组标记会记录当前 CPU Line 中存储的数据对应的内存块,我们可以用这个组标记来区分不同的内存块。
除了组标记信息外,CPU Line 还有两个信息:
- 一个是,从内存加载过来的实际存放数据(Data)。
- 另一个是,有效位(Valid bit),它是用来标记对应的 CPU Line 中的数据是否是有效的,如果有效位是 0,无论 CPU Line 中是否有数据,CPU 都会直接访问内存,重新加载数据。
CPU 在从 CPU Cache 读取数据的时候,并不是读取 CPU Line 中的整个数据块,而是读取 CPU 所需要的一个数据片段,这样的数据统称为一个字(*Word*)。那怎么在对应的 CPU Line 中数据块中找到所需的字呢?答案是,需要一个偏移量(Offset)。
因此,一个内存的访问地址,包括组标记、CPU Line 索引、偏移量这三种信息,于是 CPU 就能通过这些信息,在 CPU Cache 中找到缓存的数据。而对于 CPU Cache 里的数据结构,则是由索引 + 有效位 + 组标记 + 数据块组成。
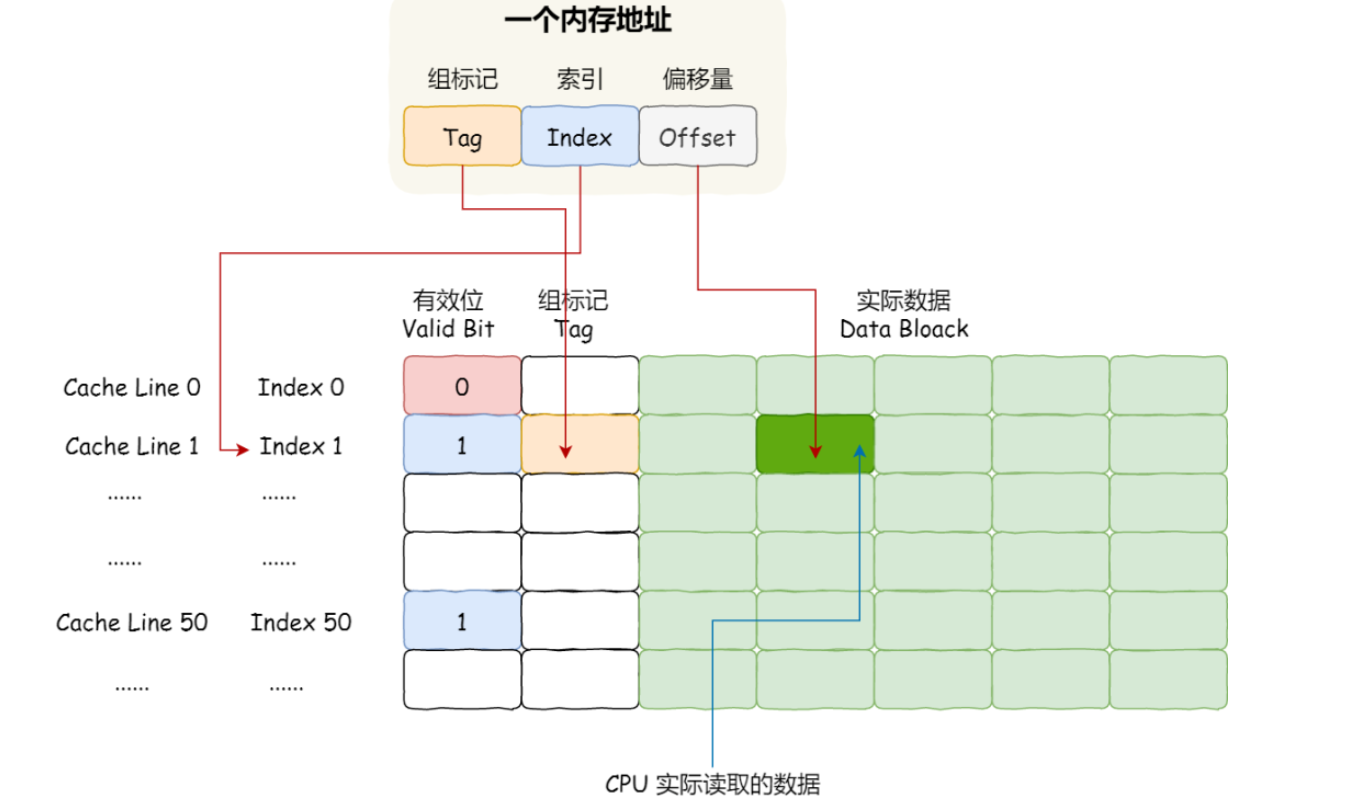
如果内存中的数据已经在 CPU Cahe 中了,那 CPU 访问一个内存地址的时候,会经历这 4 个步骤:
- 根据内存地址中索引信息,计算在 CPU Cahe 中的索引,也就是找出对应的 CPU Line 的地址;
- 找到对应 CPU Line 后,判断 CPU Line 中的有效位,确认 CPU Line 中数据是否是有效的,如果是无效的,CPU 就会直接访问内存,并重新加载数据,如果数据有效,则往下执行;
- 对比内存地址中组标记和 CPU Line 中的组标记,确认 CPU Line 中的数据是我们要访问的内存数据,如果不是的话,CPU 就会直接访问内存,并重新加载数据,如果是的话,则往下执行;
- 根据内存地址中偏移量信息,从 CPU Line 的数据块中,读取对应的字。
问题在于,我们并不是只读数据。我们还会写入。那么如果数据写入 Cache 之后,内存与 Cache 相对应的数据将会不同,这种情况下 Cache 和内存数据都不一致了,于是我们肯定是要把 Cache 中的数据同步到内存里的。
问题来了,那在什么时机才把 Cache 中的数据写回到内存呢?为了应对这个问题,下面介绍两种针对写入数据的方法:
-
写直达(Write Through)
-
保持内存与 Cache 一致性最简单的方式是,把数据同时写入内存和 Cache 中,这种方法称为写直达(*Write Through*)。
-
在这个方法里,写入前会先判断数据是否已经在 CPU Cache 里面了:
- 如果数据已经在 Cache 里面,先将数据更新到 Cache 里面,再写入到内存里面;
- 如果数据没有在 Cache 里面,就直接把数据更新到内存里面。
写直达法很直观,也很简单,但是问题明显,无论数据在不在 Cache 里面,每次写操作都会写回到内存,这样写操作将会花费大量的时间,无疑性能会受到很大的影响。
-
-
写回(Write Back)
- 既然写直达由于每次写操作都会把数据写回到内存,而导致影响性能,于是为了要减少数据写回内存的频率,就出现了写回(*Write Back*)的方法。
- 在写回机制中,当发生写操作时,新的数据仅仅被写入 Cache Block 里,只有当修改过的 Cache Block「被替换」时才需要写到内存中,减少了数据写回内存的频率,这样便可以提高系统的性能。
- 如果当发生写操作时,数据已经在 CPU Cache 里的话,则把数据更新到 CPU Cache 里,同时标记 CPU Cache 里的这个 Cache Block 为脏(Dirty)的,这个脏的标记代表这个时候,我们 CPU Cache 里面的这个 Cache Block 的数据和内存是不一致的,这种情况是不用把数据写到内存里的;
- 如果当发生写操作时,数据所对应的 Cache Block 里存放的是「别的内存地址的数据」的话,就要检查这个 Cache Block 里的数据有没有被标记为脏的,如果是脏的话,我们就要把这个 Cache Block 里的数据写回到内存,然后再把当前要写入的数据,写入到这个 Cache Block 里,同时也把它标记为脏的;如果 Cache Block 里面的数据没有被标记为脏,则就直接将数据写入到这个 Cache Block 里,然后再把这个 Cache Block 标记为脏的就好了。
可以发现写回这个方法,在把数据写入到 Cache 的时候,只有在缓存不命中,同时数据对应的 Cache 中的 Cache Block 为脏标记的情况下,才会将数据写到内存中,而在缓存命中的情况下,则在写入后 Cache 后,只需把该数据对应的 Cache Block 标记为脏即可,而不用写到内存里。
这样的好处是,如果我们大量的操作都能够命中缓存,那么大部分时间里 CPU 都不需要读写内存,自然性能相比写直达会高很多。
现在有一个问题。我们东西确实是写入L1/L2 cache了。但是L1/L2 cache是每个核心独有的。也就是说,有可能在一个核心修改完数据后,修改的数据还在自己的缓存里。另一个核心从自己的缓存里读就会读到没有修改过的值。
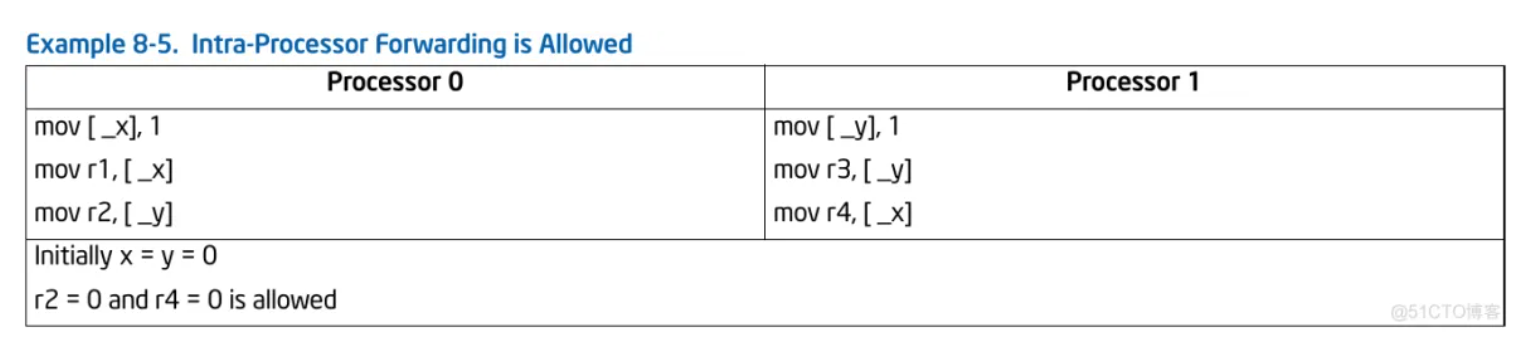
- 这里的意思是有可能r2 = 0 且 r4 = 0。为什么?
- 我们可能会回答指令重排。但是X86是不允许写-写重排的。所以导致这个情况的就是我们本节的缓存一致性。
- 但是具体原因是什么呢?我们先看看MESI协议。
那么,要解决这一问题,就需要一种机制,来同步两个不同核心里面的缓存数据。要实现的这个机制的话,要保证做到下面这 2 点:
- 第一点,某个 CPU 核心里的 Cache 数据更新时,必须要传播到其他核心的 Cache,这个称为写传播(*Wreite Propagation*);
- 第二点,某个 CPU 核心里对数据的操作顺序,必须在其他核心看起来顺序是一样的,这个称为事务的串形化(*Transaction Serialization*)。
第一点写传播很容易就理解,当某个核心在 Cache 更新了数据,就需要同步到其他核心的 Cache 里。而对于第二点事务事的串形化,我们举个例子来理解它。:
- 假设我们有一个含有 4 个核心的 CPU,这 4 个核心都操作共同的变量
i(初始值为 0 )。A 号核心先把i值变为100,而此时同一时间,B 号核心先把i值变为200,这里两个修改,都会「传播」到 C 和 D 号核心。
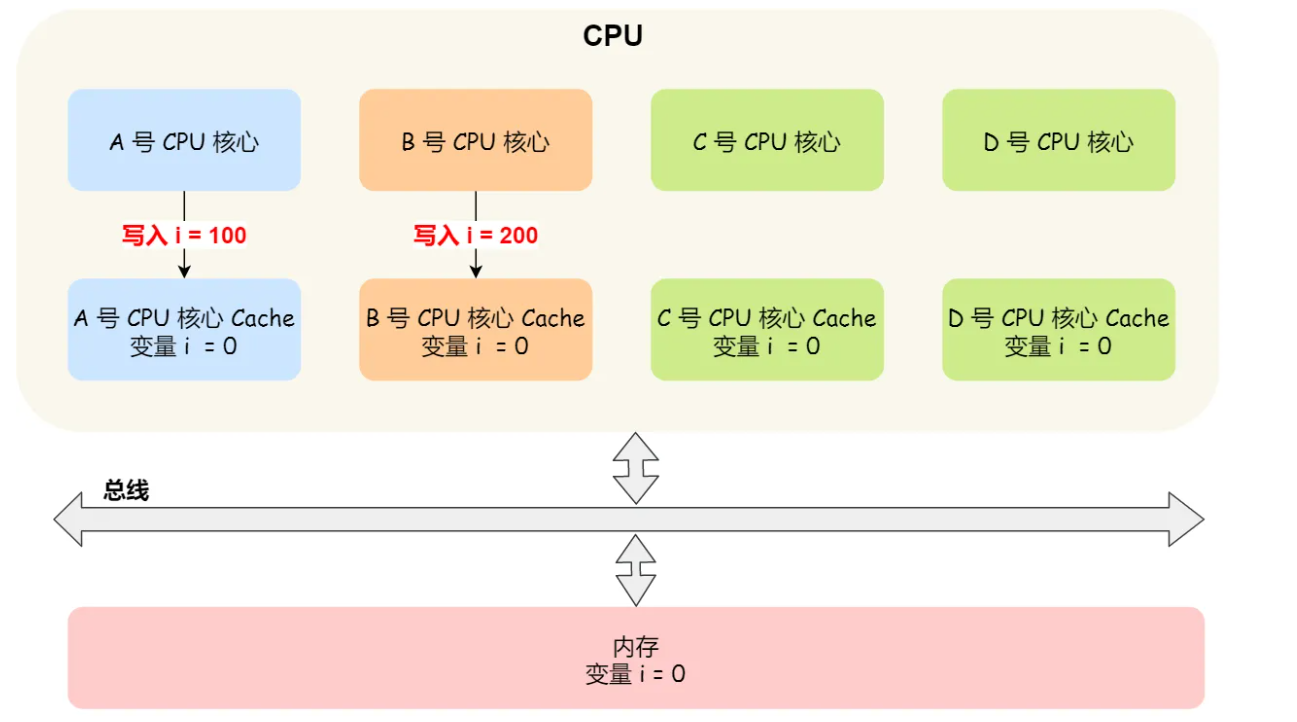
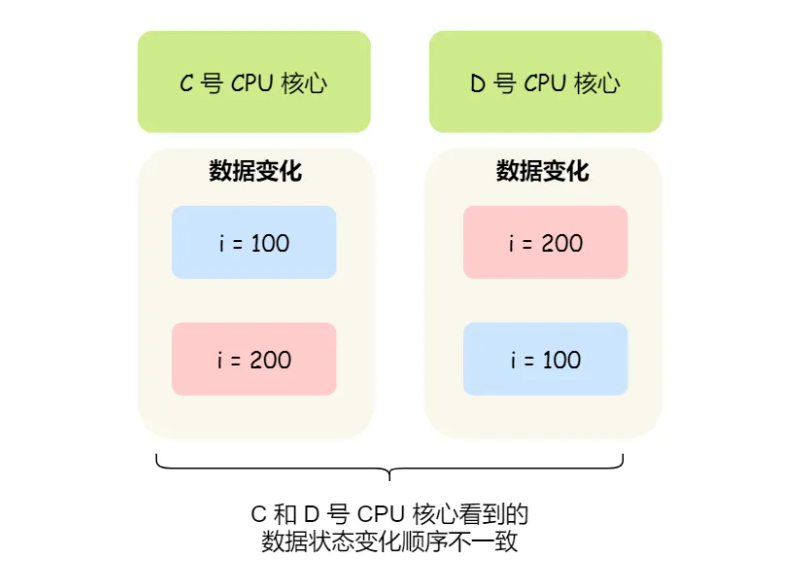
那么问题就来了,C 号核心先收到了 A 号核心更新数据的事件,再收到 B 号核心更新数据的事件,因此 C 号核心看到的变量 i 是先变成 100,后变成 200。
而如果 D 号核心收到的事件是反过来的,则 D 号核心看到的是变量i先变成 200,再变成 100,虽然是做到了写传播,但是各个 Cache 里面的数据还是不一致的。
所以,我们要保证 C 号核心和 D 号核心都能看到相同顺序的数据变化,比如变量 i 都是先变成 100,再变成 200,这样的过程就是事务的串形化。
要实现事务串形化,要做到 2 点:
- CPU 核心对于 Cache 中数据的操作,需要同步给其他 CPU 核心;
- 要引入「锁」的概念,如果两个 CPU 核心里有相同数据的 Cache,那么对于这个 Cache 数据的更新,只有拿到了「锁」,才能进行对应的数据更新。
MESI 协议
MESI 协议其实是 4 个状态单词的开头字母缩写,分别是:
- Modified,已修改
- Exclusive,独占
- Shared,共享
- Invalidated,已失效
这四个状态来标记 Cache Line 四个不同的状态。
- 「已修改」状态就是我们前面提到的脏标记,代表该 Cache Block 上的数据已经被更新过,但是还没有写到内存里。
- 「已失效」状态,表示的是这个 Cache Block 里的数据已经失效了,不可以读取该状态的数据。
- 「独占」和「共享」状态都代表 Cache Block 里的数据是干净的,也就是说,这个时候 Cache Block 里的数据和内存里面的数据是一致性的。
- 「独占」和「共享」的差别在于,独占状态的时候,数据只存储在一个 CPU 核心的 Cache 里,而其他 CPU 核心的 Cache 没有该数据。这个时候,如果要向独占的 Cache 写数据,就可以直接自由地写入,而不需要通知其他 CPU 核心,因为只有你这有这个数据,就不存在缓存一致性的问题了,于是就可以随便操作该数据。
- 另外,在「独占」状态下的数据,如果有其他核心从内存读取了相同的数据到各自的 Cache ,那么这个时候,独占状态下的数据就会变成共享状态。
- 那么,「共享」状态代表着相同的数据在多个 CPU 核心的 Cache 里都有,所以当我们要更新 Cache 里面的数据的时候,不能直接修改,而是要先向所有的其他 CPU 核心广播一个请求,要求先把其他核心的 Cache 中对应的 Cache Line 标记为「无效」状态,然后再更新当前 Cache 里面的数据。
我们举个具体的例子来看看这四个状态的转换:
- 当 A 号 CPU 核心从内存读取变量 i 的值,数据被缓存在 A 号 CPU 核心自己的 Cache 里面,此时其他 CPU 核心的 Cache 没有缓存该数据,于是标记 Cache Line 状态为「独占」,此时其 Cache 中的数据与内存是一致的;
- 然后 B 号 CPU 核心也从内存读取了变量 i 的值,此时会发送消息给其他 CPU 核心,由于 A 号 CPU 核心已经缓存了该数据,所以会把数据返回给 B 号 CPU 核心。在这个时候, A 和 B 核心缓存了相同的数据,Cache Line 的状态就会变成「共享」,并且其 Cache 中的数据与内存也是一致的;
- 当 A 号 CPU 核心要修改 Cache 中 i 变量的值,发现数据对应的 Cache Line 的状态是共享状态,则要向所有的其他 CPU 核心广播一个请求,要求先把其他核心的 Cache 中对应的 Cache Line 标记为「无效」状态,然后 A 号 CPU 核心才更新 Cache 里面的数据,同时标记 Cache Line 为「已修改」状态,此时 Cache 中的数据就与内存不一致了。
- 如果 A 号 CPU 核心「继续」修改 Cache 中 i 变量的值,由于此时的 Cache Line 是「已修改」状态,因此不需要给其他 CPU 核心发送消息,直接更新数据即可。
- 如果 A 号 CPU 核心的 Cache 里的 i 变量对应的 Cache Line 要被「替换」,发现 Cache Line 状态是「已修改」状态,就会在替换前先把数据同步到内存。
说完了MESI协议,回到我们Example 8.5的那张图。具体缓存一致性在哪儿出问题了?
假设在cache line中状态为共享,在某个核更新数据时候会向总线发送已失效消息以获取数据的所有权,其他消息得到此消息后更新相应cache line状态为已失效,并回复Invalidate Acknowledge消息。显然我们可以看到这个过程非常的繁琐,如果每个操作生效前都需要这么多操作那也太低效了,所以引入了Invaildate queue和Store Buffer,为的就是异步执行指令,提高以上过程的效率。
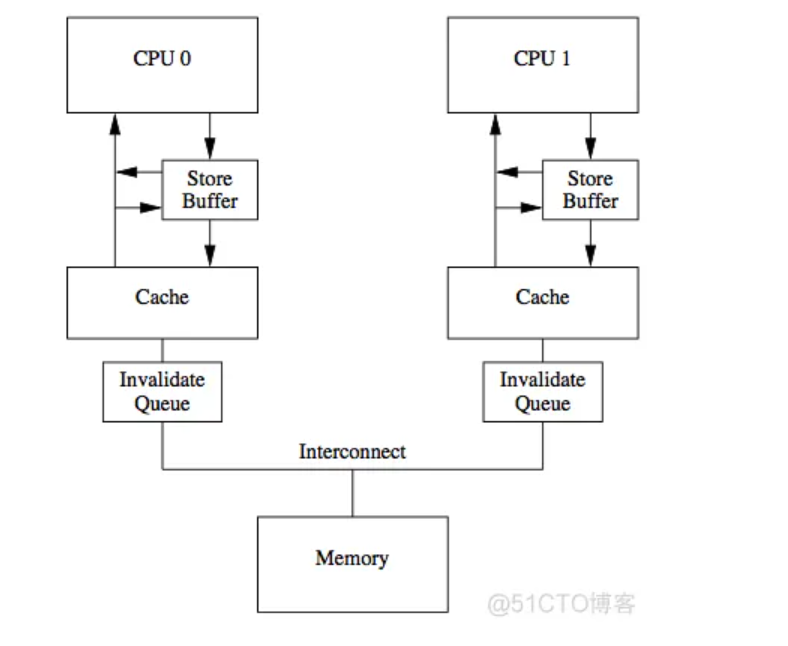
因为写入到Invaildate queue和Store Buffer的数据并不会被立即执行。在执行写操作的核会把数据写入store buffer,后面异步的刷新到cache line,当然也会广播失效消息。而当另一个执行读操作的核收到这个失效消息时,会把消息写入自身的Invalidate Queue中,随后异步将cache line设为失效状态。写操作的核在读取的时候会扫描store buffer,而这个执行读操作的核在读取数据的时候并不会扫描Invaildate queue,这意味着读操作可能会在一段时间内读到老旧数据。
首先process 0和process 1把1放入到地址_x和_y的内存上,但是此时可能这些数据还存在自己的store buffer中,也就是对方都还没意识到数据已经发生修改,然后执行操作r2和r4的操作,此时就发生脏读,导致 r2 = 0 且 r4 = 0这种奇怪的事情发生。
- 也就是在processor 1把
y的值更改为1的时候,并没有直接写入内存。此时在processor 0眼里y还是0。所以r2就是0
内存屏障
经过上面的总结,我们可以得出结论。内存屏障存在的意义是在一定程度上避免缓存一致性所带来的问题和指令重排。
在广义角度上,Intel有三种内存模型:
SFENCE,LFENCE和MFENCE指令提供了一种性能高效的方式,可确保在产生弱排序结果的例程和使用该数据的例程之间load和store内存排序。 这些指令的功能如下:
- SFENCE:序列化(动词,理解为串行化) 程序指令流中,在SFENCE指令之前发生的所有 store(写)操作,但不影响 load(读)操作。
- LFENCE:序列化 程序指令流中,在LFENCE指令之前发生的所有 load(读)操作,但不影响 store(写)操作。
- MFENCE:序列化 程序指令流中,在MFENCE指令之前发生的所有 store 和 load 操作。
当然,还有一些其他操作含有内存屏障的作用
- 总线上的内存映射设备和其他I / O设备通常对其I / O缓冲区的写入顺序敏感。可以使用I / O指令(IN和OUT指令)对此类访问施加强的写入顺序,如下所示。在执行I / O指令之前,处理器将等待程序中所有先前的指令完成,并等待所有缓冲的写入操作耗尽到内存。只有指令提取和页表遍历可以传递I / O指令。直到处理器确定I / O指令已完成,后续指令的执行才开始。
- 多处理器系统中的同步机制可能取决于强大的内存排序模型。在这里,程序可以使用诸如
XCHG指令或LOCK前缀之类的锁定指令,以确保原子地执行对存储器的读-修改-写操作。锁定操作通常类似于I / O操作,因为它们等待所有先前的指令完成并且等待所有缓冲的写操作排入内存。- 程序同步也可以通过序列化指令执行(请参见第8.3节)。这些指令通常用于关键过程或任务边界,以在跳到新的代码段或上下文切换之前强制完成所有先前的指令。像I / O和锁定指令一样,处理器在执行序列化指令之前要等到所有先前的指令都已完成并且所有缓冲的写操作都已排入内存为止。
请注意,与CPUID指令相比,SFENCE,LFENCE和MFENCE指令提供了一种更有效的控制内存顺序的方法。
从上面,我们可以看出:内存屏障,带Lock或XCHG前缀的指令,I/O操作都会把数据载入内存,自然就不存在前面我们提到的脏读问题了。
我们一直以来提到的指令重排指的是运行时排序。编译器也会导致指令重排。这里更多的讨论见这里
内存模型(内存序)
我们前面提到了程序运行时的指令重排,内存模型其实规定的就是这些指令的重排哪些排列顺序是正确的,也就是指明在特定要求下,哪些是可以出现的,哪些是不可以出现的。
事实上对于内存模型的描述我们可以从两个方面来看,一个是硬件角度的内存模型,也就是厂商给我们提供了怎样的一种一致性保证;还有一种是软件级别的内存模型,其实说直白一点就是一些高级语言给程序员提供的一致性保证,显然此时我们可以不必费尽心机去考虑代码如何适配不同的机器。
比如X86的强模型和ARM的弱模型,如果仅仅依靠硬件提供的内存屏障这个代码将非常难写, 因为不同硬件本身的提供的内存模型是不一样的,甚至有时操作也不相同。但是如果基于软件级别的内存模型,比如使用C++的内存模型(手段为内存序),那么编译器就会帮我们自动去适配不同的机器,因为这是语言保证的。
英特尔酷睿2双核,英特尔凌动,英特尔酷睿双核,奔腾4和P6家族处理器还使用处理器排序的内存排序模型,该模型可以进一步定义为“使用存储缓冲区转发进行写入排序”。 该模型的特征如下。 在用于定义为WB的内存区域的单处理器系统中,内存排序模型遵循以下原则(请注意,单处理器和多处理器系统的内存排序原则是从在以下环境中执行软件的角度编写的。其中术语“处理器”是指逻辑处理器。例如,支持多核和/或Intel超线程技术的物理处理器被视为多处理器系统。)
读操作之间无法排序
写操作不能和旧的读操作之间排序
写操作与写操作之间除了以下情况以外不能重新排序:
带有non-temporal move指令的流存储(写入)(MOVNTI, MOVNTQ, MOVNTDQ, MOVNTPS, 和 MOVNTPD)
串操作
执行CLFLUSH指令不能重新排序对存储器的写操作。 可以通过执行CLFLUSHOPT指令的执行来重新排序写操作,该指令将刷新除正在写入的高速缓存行以外的其他高速缓存行。 CLFLUSH指令的执行不会相互重新排序。 访问不同缓存行的CLFLUSHOPT的执行可能会相互重新排序。 CLFLUSHOPT的执行可以与访问不同缓存行的CLFLUSH的执行重新排序。
读取可能会与不同地址的较旧写入重新排序,但对不同地址的较旧写入则不会重新排序。(store load重排)
读写操作不能与IO操作,带LOCK的指令,序列化指令重排序。(上面曾提到过这个问题)
读操作不能越过前面的LFENCE和MFENCE操作
写操作和CLFLUSH和CLFLUSHOPT的执行不能越过前面的LFENCE,SFENCE和MFENCE指令。
LFENCE不能越过前面的读操作
SFENCE不能越过前面的写操作
MFENCE不能越过前面的读写操作以及CLFLUSH和CLFLUSHOPT的执行。
https://zhuanlan.zhihu.com/p/269221065?utm_id=0
https://blog.51cto.com/u_15703183/5464436
C++中的内存序----三(四)种模型和六种枚举值
std::memory_order指定内存访问,包括常规的非原子内存访问,如何围绕原子操作排序。在没有任何制约的多处理器系统上,多个线程同时读或写数个变量时,一个线程能观测到变量值更改的顺序不同于另一个线程写它们的顺序。其实,更改的顺序甚至能在多个读取线程间相异。一些类似的效果还能在单处理器系统上出现,因为内存模型允许编译器变换。
注意,其实内存序并不能简单描述成为禁止某某操作排到某某操作后面。因为就算单纯禁止重排,也有可能发生我们提过的缓存一致性问题。所以说,应该用可见性这个词。可见性这个词包含了描述重排和缓存一致性的情况。所以说,我们说某某操作现在是可见的,表明了确实我们保证操作正确。也就是不仅正确处理了重排,也正确处理了缓存一致性问题。
顺序一致(sequentially consistent ordering)
memory_order_seq_cst
C++使用这个做为操作原子变量的默认值。可以直接看文档。
-
Load/store/RMW操作都可以使用该枚举值,用于
load operation(原子读操作)的时候有acquire operation的特性,用于store operation(原子写操作)的时候有release operation的特性, 用于read-modify-write operation(RMW)的时候有acq_rel operation的特性,且所有操作都相当于一个双向屏障,前后语句都不能跨越该操作进行重排。并且所有线程的语句都以全局的内存修改顺序为参照。 -
看起来,这个和
memory_order_acq_rel差不多啊?并不是。这种内存序列会对拥有此标签的内存操作建立一个单独全序。memory_order_seq_cst比memory_order_acq_rel更强,memory_order_acq_rel的顺序保障,是要基于同一个原子变量的,也就是说,在这个原子变量之前的读写,不能重排到这个原子变量之后,同时这个原子变量之后的读写,也不能重排到这个原子变量之前。但是,如果两个线程基于memory_order_acq_rel使用了两个不同的原子变量x1, x2,那在x1之前的读写,重排到x2之后,是完全可能的,在x1之后的读写,重排到x2之前,也是被允许的。然而,如果两个原子变量x1,x2,是基于memory_order_seq_cst在操作,那么即使是x1之前的读写,也不能被重排到x2之后,x1之后的读写,也不能重排到x2之前,也就说,如果都用memory_order_seq_cst,那么程序代码顺序(Program Order)就将会是你在多个线程上都实际观察到的顺序(Observed Order) -
简而言之: 在这个模型下, 所有线程看到的所有操作都有一个一致的顺序, 即使这些操作可能针对不同的变量, 运行在不同的线程. 2.1 节中我们介绍了修改顺序 (modification order), 即单一变量的修改顺序在所有线程看来都是一致的. Sequencial consistent 则将这种一致性扩展到了所有变量. 例如
std::atomic<bool> x{false}, y{false};
void thread1() { x.store(true, std::memory_order_seq_cst); // (1)}
void thread2() { y.store(true, std::memory_order_seq_cst); // (2)}thread1 和 thread2 分别修改原子变量 x 和 y. 运行过程中, 有可能先执行 (1) 再执行 (2), 也有可能先执行 (2) 后执行 (1). 但无论如何, 所有线程中看到的顺序都是一致的. 因此如果我们这样测试这段代码:
std::atomic<int> z{0};
void read_x_then_y() { while (!x.load(std::memory_order_seq_cst)); // (3) if (y.load(std::memory_order_seq_cst)) ++z; // (4)}
void read_y_then_x() { while (!y.load(std::memory_order_seq_cst)); // (5) if (x.load(std::memory_order_seq_cst)) ++z; // (6)}
int main() { std::thread a(thread1), b(thread2), c(read_x_then_y), d(read_y_then_x); a.join(), b.join(), c.join(), d.join(); assert(z.load() != 0); // (7)}(7) 处的断言永远不会失败. 因为 x 和 y 的修改顺序是全局一致的, 如果先执行 (1) 后执行 (2), 则 read_y_then_x 中循环 (5) 退出时, 能保证 y 为 true, 此时 x 也必然为 true, 因此 (6) 会被执行; 同理, 如果先执行 (2) 后执行 (1), 则循环 (3) 退出时 y 也必然为 true, 因此 (4) 会被执行. 无论如何, z 最终都不会等于 0.
所有线程会以相同的顺序观察到这两个操作的执行顺序. 所以如果某个线程看到thread1先执行, 那么其余所有线程都会看到thread1先执行. 然而,这并不意味着线程1和线程2的操作之间有任何特定的顺序。具体来说,x.store(true) 和 y.store(true) 的顺序在不同的线程之间是有序的,但在同一线程中没有保证它们的相对顺序。
Sequencial consistent 可以实现 synchronizes-with 的关系. 如果一个 memory_order_seq_cst 的 load 操作在某个原子变量上读到了一个 memory_order_seq_cst 的 store 操作在这个原子变量中写入的值, 则 store 操作 “synchronizes-with” load 操作. 在上面的例子中, 有 (1) “synchronizes-with” (3) 和 (2) “synchronizes-with” (5).
顺序一致模型有一个最大的问题:它的性能差。我们很多时候并不需要对整体的原子操作进行排序。一般都是局部有序。注意到锁和内存屏障的区别。锁一般来说都是局部的,也就是针对某一个区域加锁解锁。但是不同的锁之间往往是没有顺序的。也就是说,锁更像acquire--release模型,而不是seq_cst模型。
获取发布 (release-acquire/consume ordering)
memory_order_consume
-
类似于
memory_order_acquire,也是用于load操作,但更为宽松。针对于该load操作,不允许load之后的有关联(依赖)的操作重排到load之前。 -
memory_order_consume适用于load operation(原子读操作),对于采用此内存序的load operation,我们可以称为consume operation(consume原子读操作),设有一个原子变量M上的consume operation(consume原子读操作),对周围内存序的影响是:-
当前线程中该
consume operation(consume原子读操作)后的依赖该consume operation(consume原子读操作)读取的值的写入或读取操作不能被重排到该consume operation(consume原子读操作)前,其他线程中所有对M的release operation(原子写操作)及其之前的对数据依赖变量的写入都对当前线程从该consume operation(consume原子读操作)开始往后的操作可见 -
相比较于下面讲的
memory_order_acquire,memory_order_consume只是阻止了之后有依赖关系的重排。绝大部分平台上,这个内存序只会影响到编译器优化,依赖于dependency chain。但实际上很多编译器都没有正确地实现consume,导致等同于acquire。 -
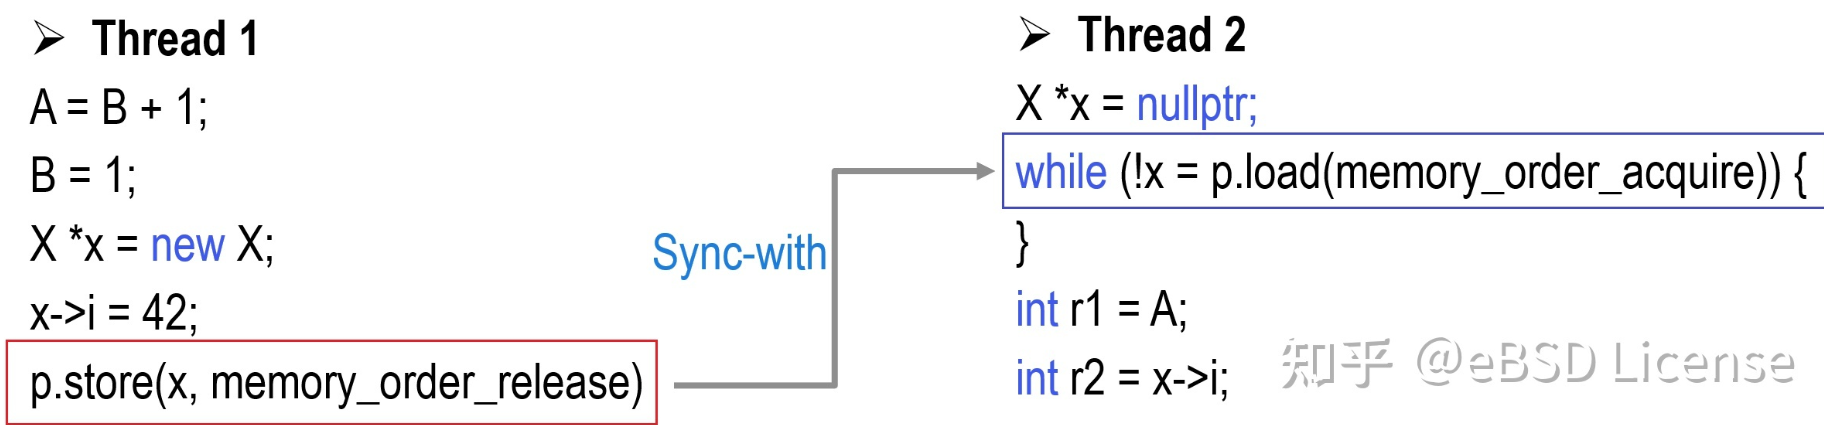
见下图,如果我们把
memory_order_acquire换成了memory_order_consume,那么将只有int r2 = x->i是有效的,因为其读取的值依赖原子变量p,但int r1 = A并不能保证读到线程1写入到A的值,因为A值并不依赖p。
-
memory_order_acquire ---- 理解为 acquire lock
-
针对于该
load操作,不允许load之后的操作重排到load之前。 -
说人话就是:单向加载内存屏障,表示线程中的读写指令不能重排到此读屏障指令之前,另一个执行写原子变量的线程里写操作之前的变量,可以被此线程 读取。
- 理解为
lock()。也就是lock之后的代码不能放到lock之前。理解为我们acquire其他线程publish的操作。
- 理解为
-
memory_order_acquire适用于load operation(原子读操作),对于采用此内存序的load operation(原子读操作),我们可以称为acquire operation,设有一个原子变量M上的acquire operation(原子读操作),对周围内存序的影响是:- 当前线程中该
acquire operation(原子读操作)后的任何内存读写操作都不能被重排到该acquire operation(原子读操作)前。 - 结合下面的
memory_order_release我们能推导出从而会有其他线程中所有对M的release operation(原子写操作)及其之前的写入都对当前线程从该acquire operation(原子读操作)开始往后的操作可见。
- 当前线程中该
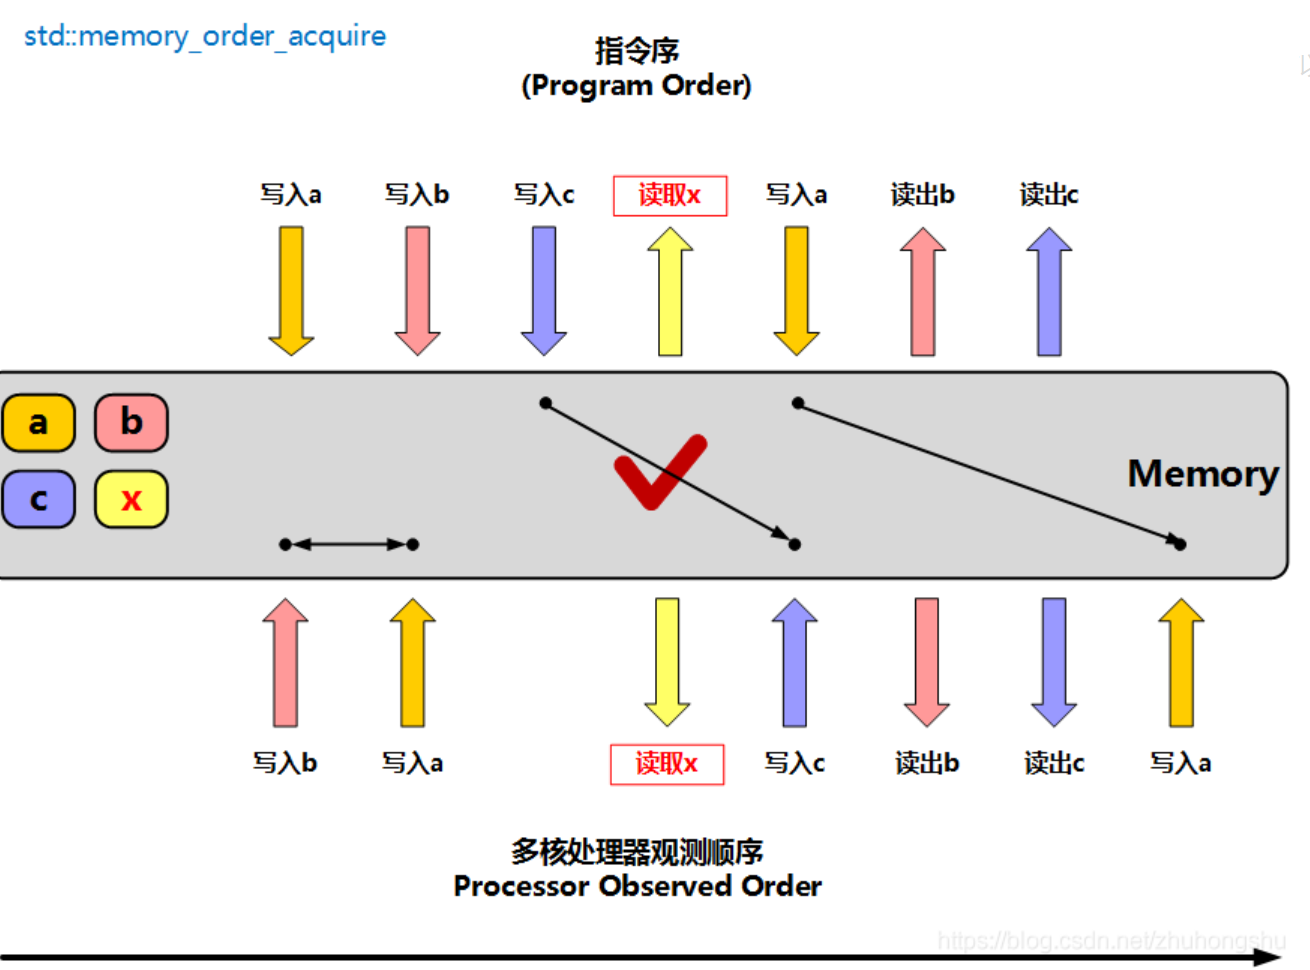
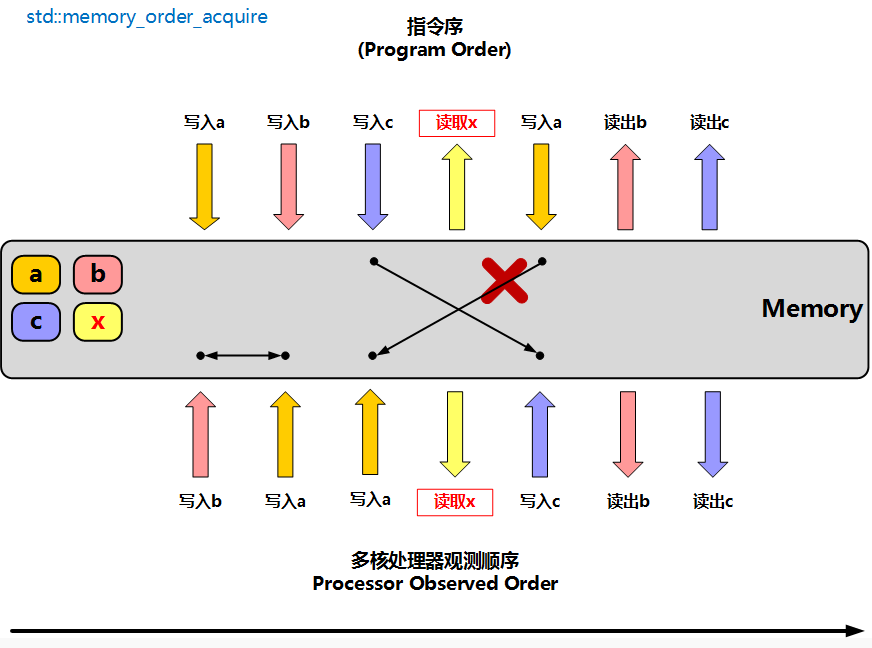
此时在一个线程上执行时,读取x的内存屏障操作之前的指令允许重排到x之后,但是读取x之后的指令不会被重排到x前面。
实际上memory_order_release用于写入、memory_order_acquire用于读取,他们是成对使用:线程A使用memory_order_release写原子变量x,线程B使用memory_order_acquire读原子变量x。线程A写x之前的操作,都可以被线程B在读x之后看到
memory_order_release ---- 理解为 release unlock
- 针对于该
store操作,不允许store之前的操作重排到store之后。 - 说人话就是:单向释放内存屏障,表示线程中的读写指令不能重排到此写原子变量指令之后。另一个执行读原子变量的线程,可以正确读取指令之前的变量
- 理解为
unlock()。也就是unlock前面的代码不能放到unlock后面。理解为我们把我们对内存的更改 release掉。也就是publish给其他线程 memory_order_release适用于store operation(原子写操作),对于采用此内存序的写入操作,我们可以称为release operation,设有一个原子变量M上的release operation(写入操作),对周围内存序的影响是:-
该
release operation(写入操作)前的内存读写都不能重排到该release operation(写入操作)之后。(该store操作,不允许store之前的操作重排到store之后。)结合memory_order_acquire的左右从而有:- 当前线程截止到该
release operation(原子写操作)的所有内存写入都对另外线程对M的acquire operation(原子读操作)以及之后的内存操作可见,这就是release acquire语义。 - 当前线程截止到该operation的所有M所依赖的内存写入都对另外线程对M的
consume operation以及之后的内存操作可见,这就是release consume语义。
- 当前线程截止到该
-
- 理解为
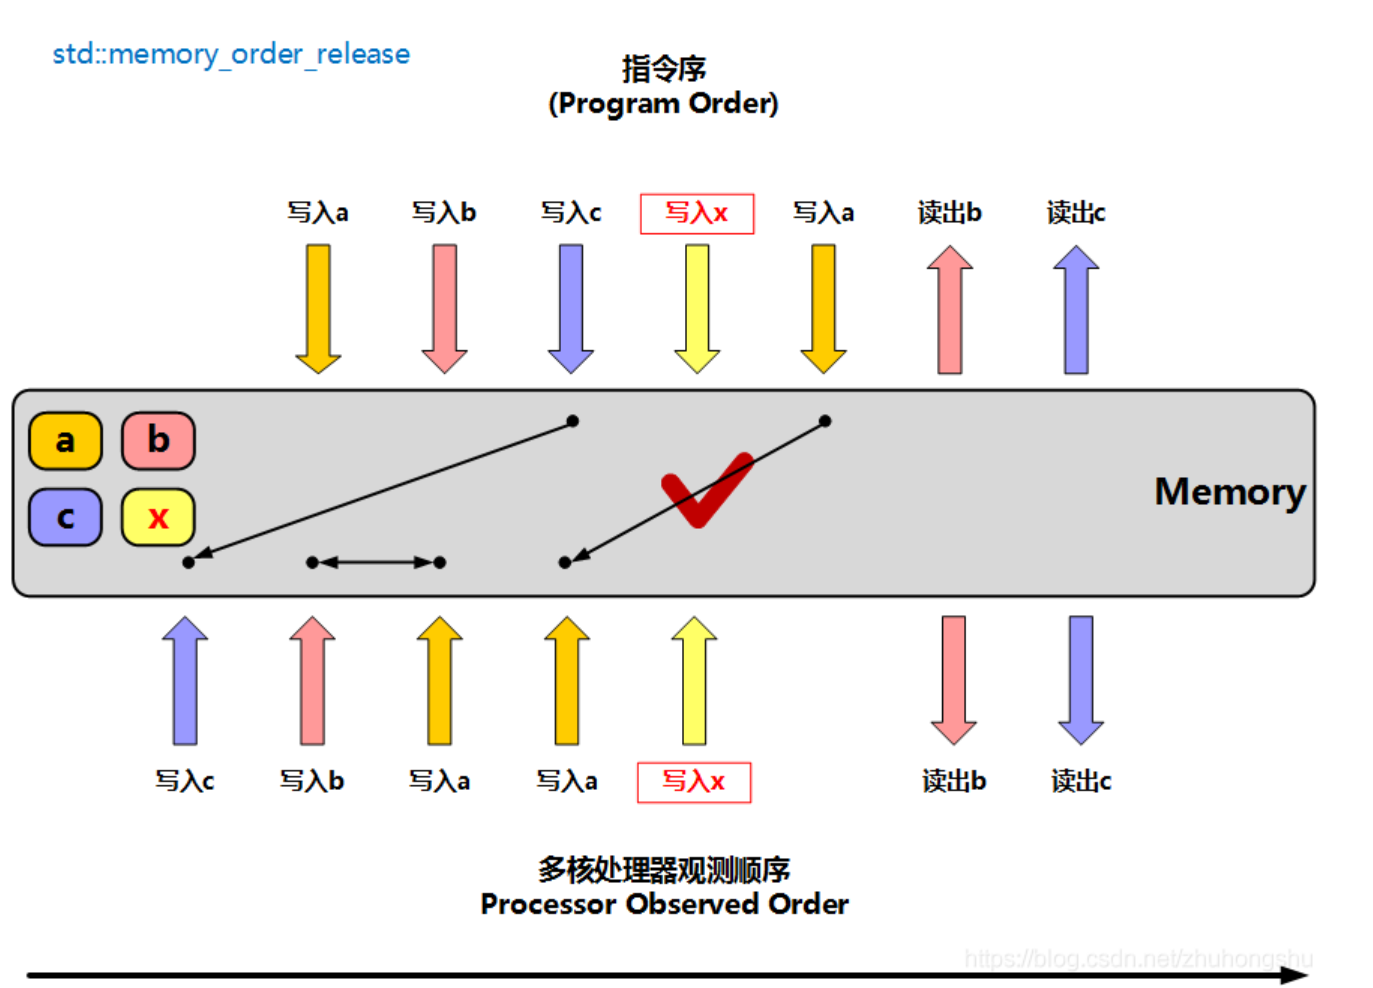
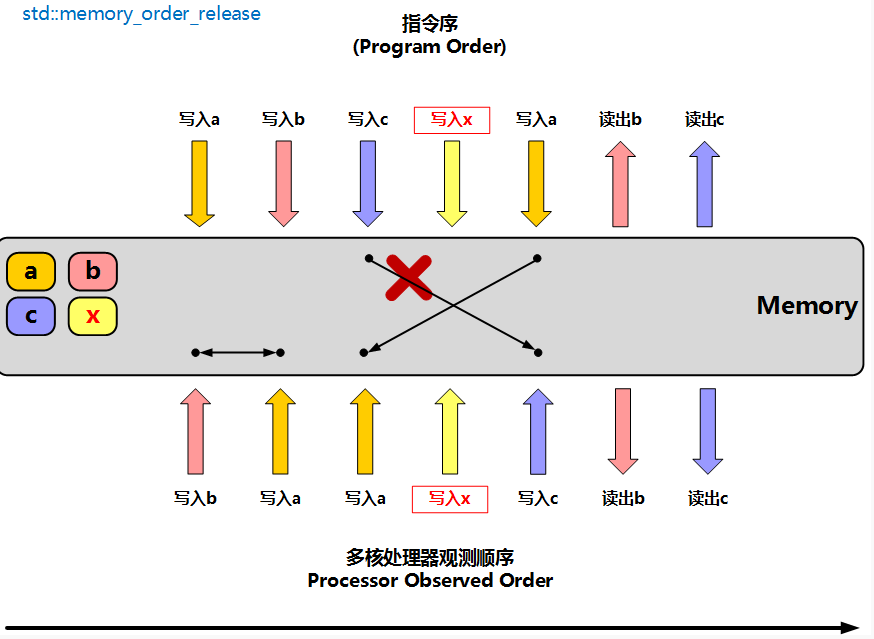
此时在一个线程上执行时,写入x的内存屏障操作之后的指令允许重排到x之前,但是写入x之前的指令不会被重排到x后面。 不过写入x指令前后的那些指令的顺序是允许重排的。所以使用memory_order_release屏障后,可以保障另一个线程在执行了读取x操作之后,读取a、b、c的值是正确的,因为a、b、c的写入操作一定不会被重排到x操作之后
memory_order_acq_rel
- 双向的”加载-释放”内存屏障。
- 多用于CAS操作。比如
compare_exchange_weak/strong,fetch_add/sub/...等 - 用于RMW(read-modify-write)原子操作,RMW操作前后的语句都不允许跨越该操作而重排。该操作相当于兼具load(acquire)和store(release),可以看作由这两个操作组成,但是整体上是原子的。
memory_order_acq_rel适用于read-modify-write operation(RMW操作),对于采用此内存序的read-modify-write operation,我们可以称为acq_rel operation,既属于acquire operation也是release operation. 设有一个原子变量M上的acq_rel operation:自然的,因为同时具有两种属性,所以该acq_rel operation之前的内存读写都不能重排到该acq_rel operation之后,该acq_rel operation之后的内存读写都不能重排到该acq_rel operation之前. 其他线程中所有对M的release operation(写入操作)及其之前的写入都对当前线程从该acq_rel operation开始的操作可见,并且截止到该acq_rel operation的所有内存写入都对另外线程对M的acquire operation(原子读操作)以及之后的内存操作可见。- 注意,针对内存屏障,多线程之间必须要使用的是同一个原子变量。因为是使用这一个原子变量的值进行同步的。这里和顺序一致模型有区别
release-acquire 可以实现 synchronizes-with 的关系. 如果一个 acquire 操作在同一个原子变量上读取到了一个 release 操作写入的值, 则这个 release 操作 “synchronizes-with” 这个 acquire 操作. 我们来看一个例子:
std::atomic<bool> x{false}, y{false};
void thread1() { x.store(true, std::memory_order_relaxed); // (1) y.store(true, std::memory_order_release); // (2)}
void thread2() { while (!y.load(std::memory_order_acquire)); // (3) assert(x.load(std::memory_order_relaxed)); // (4)}在上面的例子中, 语句 (2) 使用 memory_order_release 在 y 中写入 true, 语句 (3) 中使用 memory_order_acquire 从 y 中读取值. 循环 (3) 退出时, 它已经读取到了 y 的值为 true, 也就是读取到了操作 (2) 中写入的值. 因此有 (2) “synchronizes-with” (3). 所以我们可以推导出:
- 因为 (2) “synchronizes-with” (3) 且 (3) “sequenced-before” (4), 所以 (2) “inter-thread happens-before” (4);
- 因为 (1) “sequenced-before” (2) 且 (2) “inter-thread happens-before” (4), 所以 (1) “inter-thread happens-before” (4);
所以 (1) “happens-before” (4). 因此 (4) 能读取到 (1) 中写入的值, 断言永远不会失败. 即使 (1) 和 (4) 用的是 memory_order_relaxed.
我们提到 sequencial consistent 模型可以实现 synchronizes-with 关系. 事实上, 内存顺序为 memory_order_seq_cst 的 load 操作和 store 操作可以分别视为 acquire 操作和 release 操作. 因此对于两个指定了 memory_order_seq_cst 的 store 操作和 load 操作, 如果后者读到了前者写入的值, 则前者 “synchronizes-with” 后者.
为了实现 synchronizes-with 关系, acquire 操作和 release 操作应该成对出现. 如果 memory_order_acquire 的 load 读到了 memory_order_relaxed 的 store 写入的值, 或者 memory_order_relaxed 的 load 读到了 memory_order_release 的 store 写入的值, 都不能实现 synchronizes-with 的关系.
虽然 sequencial consistent 顺序一致模型能够像 release-acquire 一样实现同步, 但是反过来 release-acquire 模型不能像 sequencial consistent 一样提供全局顺序一致性. 如果将顺序一致一节例子中的 memory_order_seq_cst 换成 memory_order_acquire 和 memory_order_release
void thread1() { x.store(true, std::memory_order_release); // (1)}
void thread2() { y.store(true, std::memory_order_release); // (2)}
void read_x_then_y() { while (!x.load(std::memory_order_acquire)); // (3) if (y.load(std::memory_order_acquire)) ++z; // (4)}
void read_y_then_x() { while (!y.load(std::memory_order_acquire)); // (5) if (x.load(std::memory_order_acquire)) ++z; // (6)}则最终不能保证 z 不为 0. 在同一次运行中, read_x_then_y 有可能看到先 (1) 后 (2), 而 read_y_then_x 有可能看到先 (2) 后 (1). 这样有可能 (4) 和 (6) 的 load 的结果都为 false, 导致最后 z 仍然为 0.
release-acquire 的开销比 sequencial consistent 小. 在 x86 架构下, memory_order_acquire 和 memory_order_release 的操作不会产生任何其他的指令, 只会影响编译器的优化: 任何指令都不能重排到 acquire 操作的前面, 且不能重排到 release 操作的后面; 否则会违反 release-acquire 的语义. 因此很多需要实现 synchronizes-with 关系的场景都会使用 release-acquire
宽松(relaxed ordering )
memory_order_relaxed
memory_order_relaxed 可以用于 store, load 和 read-modify-write 操作
- 这种模型下, 只能保证操作的原子性和修改顺序 (modification order) 一致性, 无法实现 synchronizes-with 的关系. 对于其它读写操作没有任何同步和重排的限制,仅要求保证读写的原子性和内存一致性。除此之外,不提供任何跨线程的同步。
- 一般应用于计数器场景
// Thread 1:r1 = y.load(std::memory_order_relaxed); // Ax.store(r1, std::memory_order_relaxed); // B// Thread 2:r2 = x.load(std::memory_order_relaxed); // Cy.store(42, std::memory_order_relaxed); // D执行完上面的程序,可能出现r1 == r2 == 42。理解这一点并不难,因为编译器允许调整 C 和 D 的执行顺序。如果程序的执行顺序是 D -> A -> B -> C,那么就会出现r1 == r2 == 42。
std::atomic<bool> x{false}, y{false};
void thread1() { x.store(true, std::memory_order_relaxed); // (1) y.store(true, std::memory_order_relaxed); // (2)}thread1 对不同的变量执行 store 操作. 那么在某些线程看来, 有可能是 x 先变为 true, y 后变为 true; 另一些线程看来, 又有可能是 y 先变为 true, x 后变为 true. 如果这样测试这段代码:
void thread2() { while (!y.load(std::memory_order_relaxed)); // (3) assert(x.load()); // (4)}(4) 处的断言就有可能失败. 因为 (2) 与 (3) 之间没有 synchronizes-with 的关系, 所以就不能保证 (1) “happens-before” (4). 因此 (4) 就有可能读到 false.
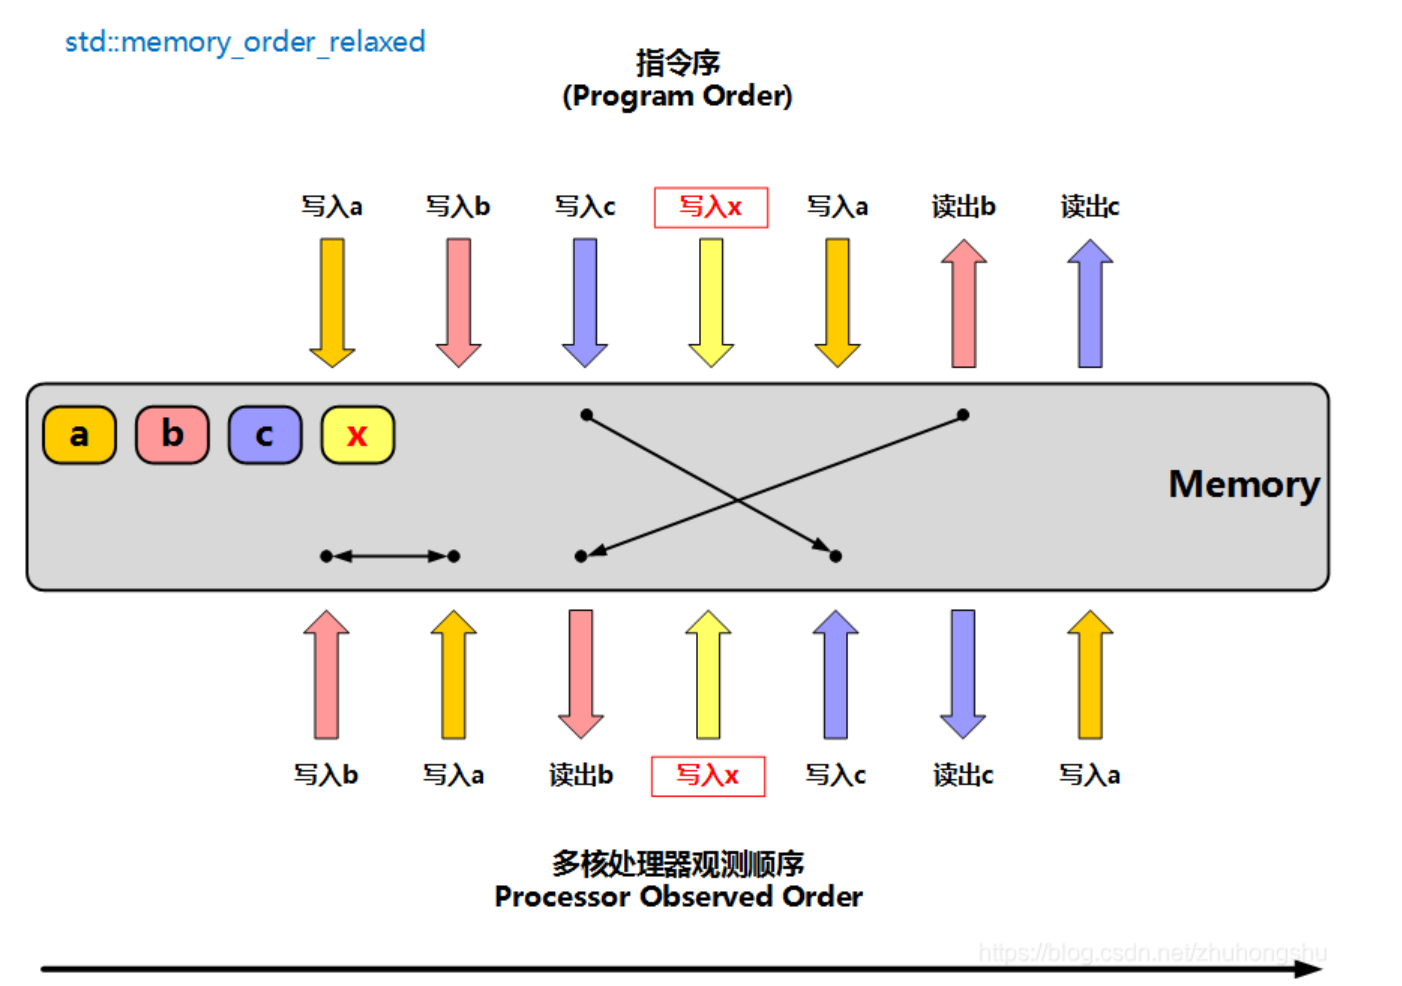
- 图中x代表atomic类型变量。此时在一个线程上执行时,在这个线程认为不影响最终结果的前提下,实际执行时指令可能完全是乱的。写入a、写入b的操作实际执行时可能是调换了;写入c的操作可能实际在写入x之后执行;读出b的操作实际在写入x之前执行
Relaxed 顺序模型的开销很小. 在 x86 架构下, memory_order_relaxed 的操作不会产生任何其他的指令, 只会影响编译器优化, 确保操作是原子的. Relaxed 模型可以用在一些不需要线程同步的场景, 但是使用时要小心. 例如 std::shared_ptr 增加引用计数时用的就是 memory_order_relaxed, 因为不需要同步; 但是减小应用计数不能用它, 因为需要与析构操作同步
小的总结
| 操作 | 有效的Memory order枚举值 | 备注 |
|---|---|---|
| Load | memory_order_relaxed, memory_order_consume, memory_order_acquire, memory_order_seq_cst | 其它枚举值不合法, MS STL的实现是将其当作memory_order_seq_cst处理 |
| Store | memory_order_relaxed, memory_order_release, memory_order_seq_cst | 同上 |
| read-modify-write | memory_order_relaxed, memory_order_consume, memory_order_acquire, memory_order_release, memory_order_acq_rel, memory_order_seq_cst |
memory_order_relaxed: 最宽松的内存顺序, 只保证操作的原子性和修改顺序 (modification order).memory_order_acquire,memory_order_release和memory_order_acq_rel: 实现 acquire 操作和 release 操作, 如果 acquire 操作读到了 release 操作写入的值, 或其 release sequence 写入的值, 则构成 synchronizes-with 关系, 进而可以推导出 happens-before 的关系.memory_order_consume: 实现 consume 操作, 能实现数据依赖相关的同步关系. 如果 consume 操作读到了 release 操作写入的值, 或其 release sequence 写入的值, 则构成 dependency-ordered before 的关系, 对于有数据依赖的操作可以进而推导出 happens-before 的关系.memory_order_seq_cst: 加强版的 acquire-release 模型, 除了可以实现 synchronizes-with 关系, 还保证全局顺序一致.
参考资料:https://zhuanlan.zhihu.com/p/382372072?utm_id=0
memory_order_acquire和memory_order_release 如何搭配使用
往往memory_order_acquire和memory_order_release是配合着一起使用的:
- 线程1使用
memory_order_release写入原子变量x - 线程2使用
memory_order_acquire读出原子变量x
所有在线程1上,在写入x之前的写入操作,都将在线程2上,在读出x之后,被看到。使用单向“加载”+单向“释放”协议的场景往往是:
- 线程1,写入一些实际数据,接着通过将原子变量x设置为某个值
A(通过使用memory_order_release写入原子变量x)来“发布”这些数据。 - 线程2,通过读取并判断x已被设置为
A(通过使用memory_order_acquire来读取原子变量x),进而读取线程1实际“发布”的那些数据
必须操作的是同一个原子变量。
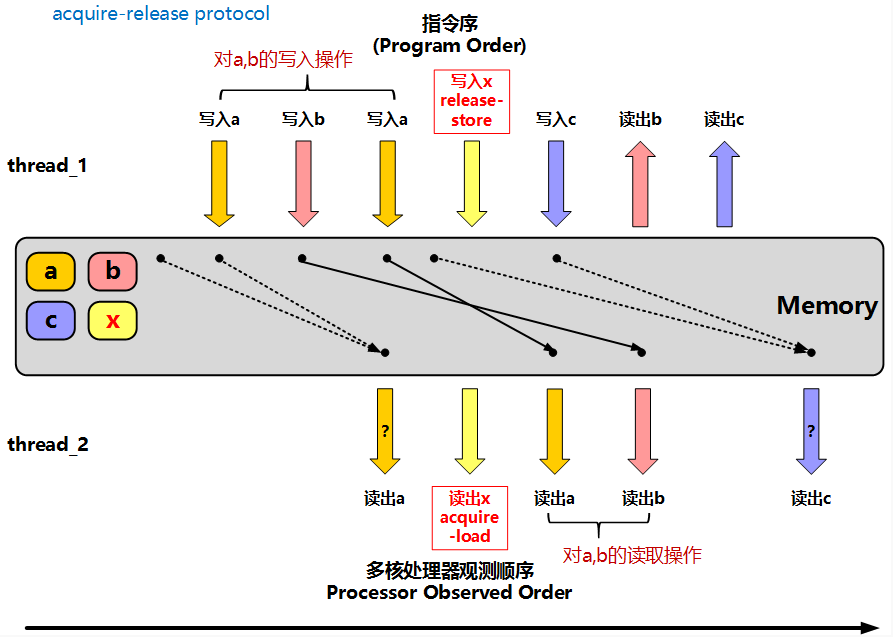
如上图所示,thread_1在release写入x(值:A)之前,写入了待发布的a,b的数据,而thread_2,将在acquire读出x且为A之后,将读到thread_1发布的a,b的数据。同时,我们可以注意到,在thread_2上,在acquire读出x之前,如果对a进行读操作,我们是无法确认读到的a一定会thread_1在之前最后写入的a,这里的顺序是不会被保证的,重排是被允许的。同时,在之后,读取c,读到的是否为thread_1最后写入的c,也是不确定的,因为,在x写入之后,thread_1上又出现了一次写入,而如果在此之前,还有一次写入, 这两次写入之间,是不存在限制,可能会被重排的。
thread_1上有了release_store,对于a,b的写入就一定会在x的改变之前,在thread_2上,就不会出现类似读出c,的不确定性。thread_2上有了acquire_load,右侧的读出a,就不会被重排读到左侧,而左侧读出a的不确定性,也不存在。thread_1卡住的是:对于数据a,b的写入不能排到x的写入之后,thread_2卡住的,是对于数据a,b的读取,不能排到读取x之前,这样,就保证了数据a,b,与”信号量”x,之间,在thread_1, thread_2上的同步关系。
Release sequences 释放序列
到目前为止我们看到的, 无论是 sequencial consistent 还是 release-acquire, 要想实现 synchronizes-with 的关系, acquire 操作必须在同一个原子变量上读到 release 操作的写入的值. 如果 acquire 操作没有读到 release 操作写入的值, 那么它俩之间通常没有 synchronizes-with 的关系. 例如
std::atomic<int> x{0}, y{0};
void thread1() { x.store(1, std::memory_order_relaxed); // (1) y.store(1, std::memory_order_release); // (2)}
void thread2() { y.store(2, std::memory_order_release); // (3)}
void thread3() { while (!y.load(std::memory_order_acquire)); // (4) assert(x.load(std::memory_order_relaxed) == 1); // (5)}上面的例子中, 只要 y 的值非 0 循环 (4) 就会退出. 当它退出时, 有可能读到 (2) 写入的值, 也有可能读到 (3) 写入的值. 如果是后者, 则只能保证 (3) “synchronizes-with” (4), 不能保证与 (2) 与 (4) 之间有同步关系. 因此 (5) 处的断言就有可能失败.
但并不是只有在 acquire 操作读取到 release 操作写入的值时才能构成 synchronizes-with 关系. 为了说这种情况, 我们需要引入 release sequence 这个概念.
针对一个原子变量 M 的 release 操作 A 完成后, 接下来 M 上可能还会有一连串的其他操作. 如果这一连串操作是由
- 同一线程上的写操作, 或者
- 任意线程上的 read-modify-write 操作
这两种构成的, 则称这一连串的操作为以 release 操作 A 为首的 release sequence. 这里的写操作和 read-modify-write 操作可以使用任意内存顺序.
如果一个 acquire 操作在同一个原子变量上读到了一个 release 操作写入的值, 或者读到了以这个 release 操作为首的 release sequence 写入的值, 那么这个 release 操作 “synchronizes-with” 这个 acquire 操作. 我们来看个例子
std::vector<int> data;std::atomic<int> flag{0};
void thread1() { data.push_back(42); // (1) flag.store(1, std::memory_order_release); // (2)}
void thread2() { int expected = 1; while (!flag.compare_exchange_strong(expected, 2, std::memory_order_relaxed)) // (3) 注意此处使用了宽松 expected = 1;}
void thread3() { while (flag.load(std::memory_order_acquire) < 2); // (4) assert(data.at(0) == 42); // (5)}上面的例子中, (3) 处的 compare_exchange_strong 是一种 RMW 操作, 它判断原子变量的值是否与期望的值 (第一个参数) 相等, 如果相等则将原子变量设置成目标值 (第二个参数) 并返回 true, 否则将第一个参数 (引用传递) 设置成原子变量当前值并返回 false. 操作 (3) 会一直循环检查, 当 flag 当值为 1 时, 将其替换成 2. 所以 (3) 属于 (2) 的 release sequence. 而循环 (4) 退出时, 它已经读到了 (3) 写入的值, 也就是 release 操作 (2) 为首的 release sequence 写入的值. 所以有 (2) “synchronizes-with” (4). 因此 (1) “happens-before” (5), (5) 处的断言不会失败.
注意 (3) 处的 compare_exchange_strong 的内存顺序是 memory_order_relaxed, 所以 (2) 与 (3) 并不构成 synchronizes-with 的关系. 也就是说, 当循环 (3) 退出时, 并不能保证 thread2 能读到 data.at(0) 为 42. 但是 (3) 属于 (2) 的 release sequence, 当 (4) 以 memory_order_acquire 的内存顺序读到 (2) 的 release sequence 写入的值时, 可以与 (2) 构成 synchronizes-with 的关系
注意, 这种只是一种概念. 依赖于代码的正确性. 同时, 我们说 “当循环 (3) 退出时, 并不能保证 thread2 能读到 data.at(0) 为 42”的原因是 这个插入操作由于缓存一致性的原因, 并不保证被刷新到thread2的cache内. 尽管从逻辑上讲, 当flag从1变为2的时候, 写入操作已经发生了, 但是这个时候这个写入并不一定保证对thread2可见. 当然了, 假设这个原子变量和写入数据在一个cache line中, 这个操作可能对thread2是可见的
如何理解内存序和锁之间的联系?
多线程编程,临界区是一个很重要的概念。我们对此再做进一步的认识。
对于临界区区内的语句,显而易见,我们不能将其移出临界区,如下图所示,编译器和CPU都不会做这种移出临界区的优化:
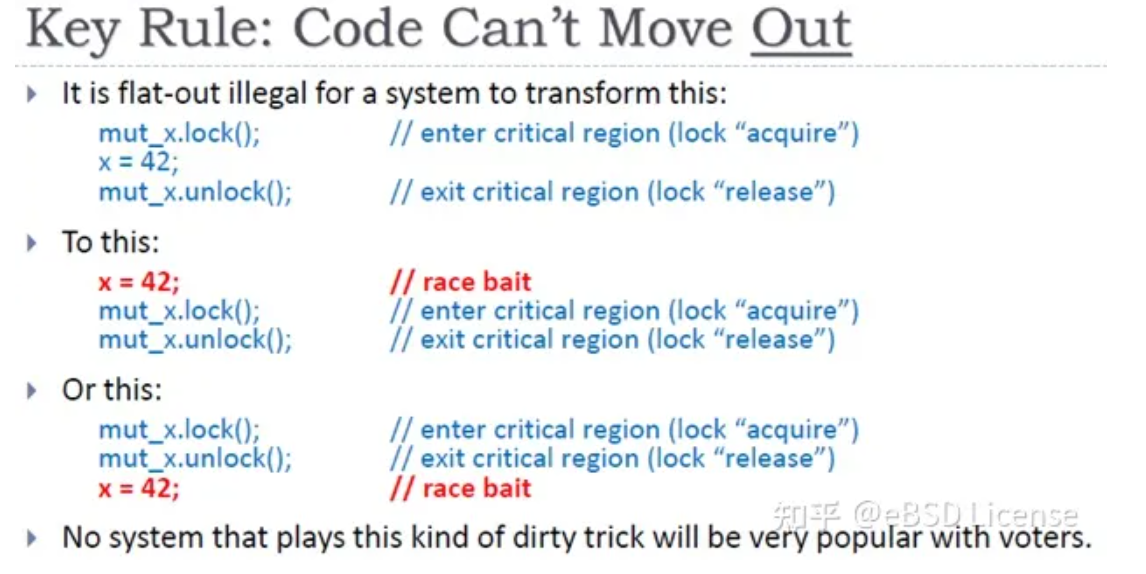
但我们可以将临界区区外的代码移进来,如下图所示
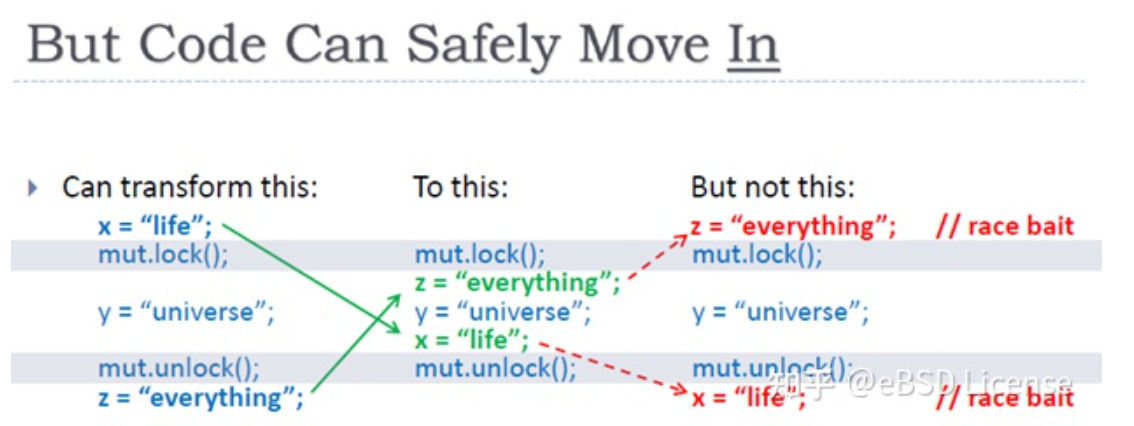
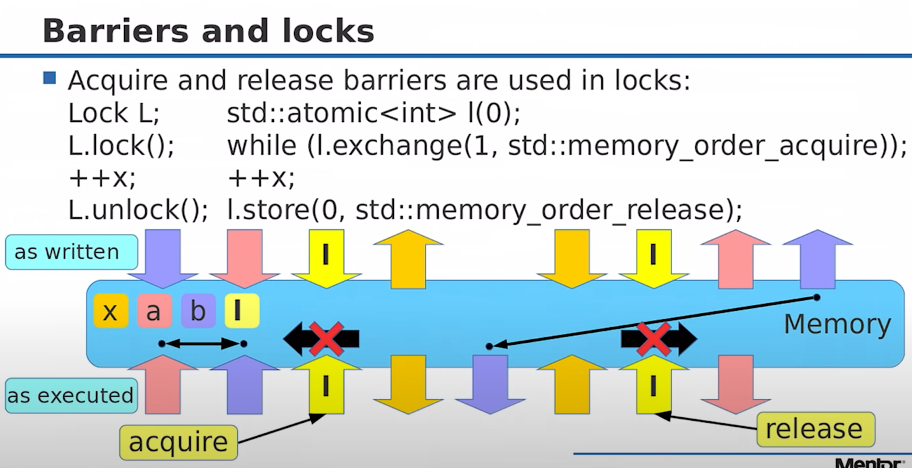
从上面两张图我们可以看出,lock和unlock可以看作两个单方向的屏障,lock对应的屏障,只允许代码往下方向移动,而`unlock则只允许上方向移动。
所以我们是不是发现:memory_order_acquire类似lock,memory_order_release类似unlock,这两个都是单方向的屏障(One-way Barriers: acquire barrier, release barrier)。
所以借助内存屏障+原子变量,在比互斥锁更底层的层面,我们也能实现线程间同步。比如下图的例子:
p原子变量,当线程2看到p为非空时,后续的r1 = A语句可以看到线程1对A的写操作结果。这是因为线程1对p的store操作Synchronizes-with线程2对p的load操作,这样加之Happens-before关系,我们实现了线程间同步。值得一提的是,线程1中,A=B+1Happens-before B = 1,但B = 1可能先执行,但线程1对A的写操作的结果,依旧能正确地被线程2中int r1 = A语句读取。
换句话说,我们利用了memory_order_release,使得针对A和B的写入一定会发生在写入原子变量p之前。我们利用了memory_order_acquire使得针对A和x的读取一定发生在读取原子变量p之前。
有人也许会问,用非原子变量难道不能实现Synchronizes-with关系?首先,非原子变量,显然不能被多个线程同时读写,再者,其无法提供内存屏障,不要忘了前文重排的例子,试想,若线程1中A和B的写入操作被重排到了p.store的后面,且即使替换p.store的非原子变量操作在多线程下可以正确执行,但此时int r1 = A能读取到正确的值吗?
这里所谓的指定内存序,指的是对执行语句所在的线程内部的限制,也就是只影响一个cpu核心,但是这些对单线程内部的限制组合起来就能实现多线程之间数据同步的效果,
同步的传递性和acquire搭配release的小例子
atomic<int> data[5];atomic<bool> sync1(false), sync2(false);
void thread_1_func(){ data[0].store(1, memory_order_relaxed); data[1].store(2, memory_order_relaxed); data[2].store(3, memory_order_relaxed); data[3].store(4, memory_order_relaxed); data[4].store(5, memory_order_relaxed); sync1.store(true, memory_order_release); //注释1}
void thread_2_func(){ while(!sync1.load(memory_order_acquire)); //注释2 sync2.store(true, memory_order_release); //注释3}
void thread_3_func(){ while(!sync2.load(memory_order_acquire)); //注释4 assert(data[0].load(memory_order_relaxed) == 1); assert(data[1].load(memory_order_relaxed) == 2); assert(data[2].load(memory_order_relaxed) == 3); assert(data[3].load(memory_order_relaxed) == 4); assert(data[4].load(memory_order_relaxed) == 5); cout << "all success" << endl;}
int main(){ thread th1(thread_1_func); thread th2(thread_2_func); thread th3(thread_3_func);
th1.join(); th2.join(); th3.join(); return 0;}- 在
func1当中,我们的数据存储使用了relaxed,所以可能是乱序,但是无关紧要。我们的核心目的是保证thread3能看到thread1中存储的全部数据。所以: - 在
func1中,我们针对sync1的写入使用了release。也就是说,在把sync1修改为true的这个操作之前,可以保证前面的操作全部完成,不会重排到这个操作之后,同时也保证缓存一致性,也就是之前的操作全部对其他线程可见。 - 在
func2中,我们针对sync1的读取使用了acquire操作。也就是说,在读取到sync1是true之前,任何操作不能被重排到该操作之前。也就保证了针对sync2的修改一定发生在发现sync1是true之后。 - 随后在
func2中,我们针对sync3的写入使用了release。原因同上。 - 在
func3中,针对sync3的读取使用了acquire,原因同上。 - 最后在
assert中,乱序可能发生,但是无所谓。
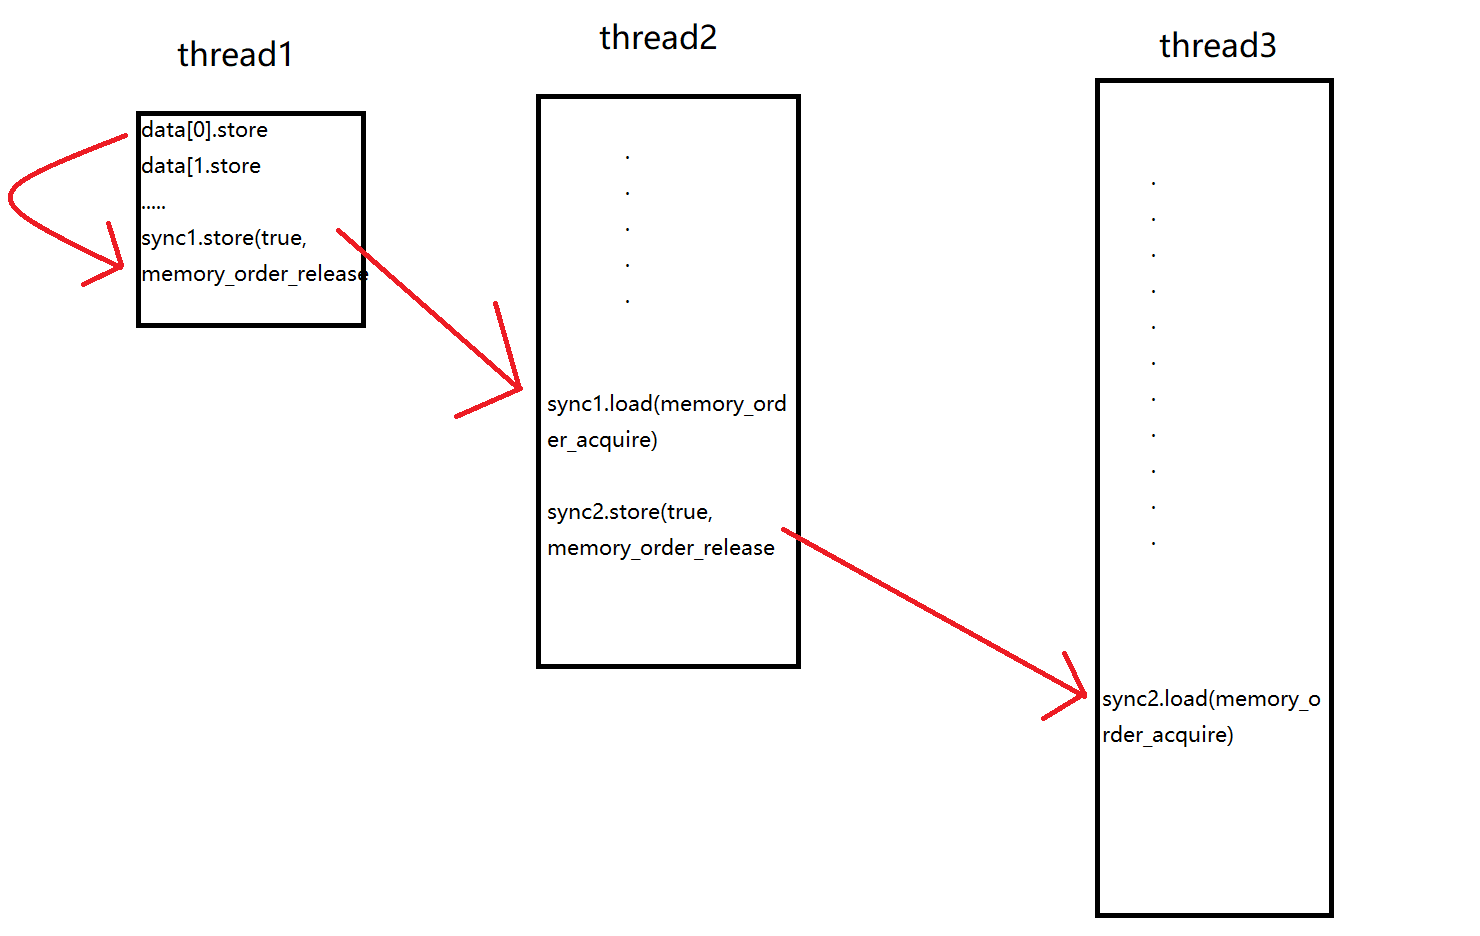
acquire和release的语义可以形象理解为:如果我不释放(release),你的请求(acquire)必须等待,直到我释放为止。
atomic_thread_fence分类和效果
在C++ 11及之后的标准里,除了利用原子操作指定内存序,还定义了单独使用memory fence(std::atomic_thread_fence)的方式,fence可以和原子操作组合进行同步,也可以fence之间进行同步,fence不光可以不依赖原子操作进行同步,而且相比较于同样memory order的原子操作,具有更强的内存同步效果
和atomic变量类似,atomic_thread_fence也可以指定六种内存序,指定不同内存序的fence可以分为以下几类:
(1) std::atomic_thread_fence(memory_order_relaxed),没有任何效果。
(2) std::atomic_thread_fence(memory_order_acquire) 和 std::atomic_thread_fence(memory_order_consume) 属于acquire fence。
(3)std::atomic_thread_fence(memory_order_release)属于release fence。
(4)std::atomic_thread_fence(memory_order_acq_rel)既是acquire fence 也是release fence,为了方便这里称为full fence。
(5)std::atomic_thread_fence(memory_order_seq_cst)额外保证有单独全序的full fence。
也就是说,如果不考虑单独全序,那么有release fence、acquire fence 和full fence三种。下面就根据以前介绍过的四种重排来介绍下这三种fence的效果。
不同类型的Fence对于乱序的保护是不一样的。我们可以将读和写的交错分成下面四种情况:
- Load-Load:读接着读
- Load-Store:先读后写
- Store-Load:先写后读
- Store-Store:写接着写
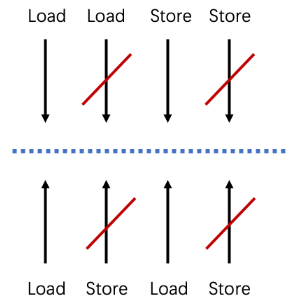
release fence
Release fence可以防止fence前的内存操作重排到fence后的任意store(写入)之后,即阻止load-store重排和store-store重排。(阻止了所有在它之前的读写操作和在它之后的写操作乱序)
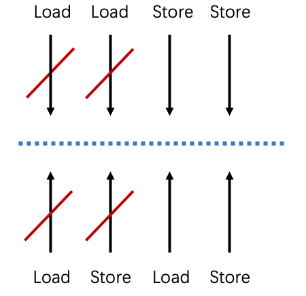
acquire fence
acquire fence可以防止fence后的内存操作重排到fence前的任意load(读取)之前,即阻止load-load重排和load-store重排。(阻止了所有在它之前的读操作与在它之后的读写操作乱序。)
full fence
- 因为
full fence是release fence和acquire fence的组合,所以也就是防止load-load、load-store、store-store重排
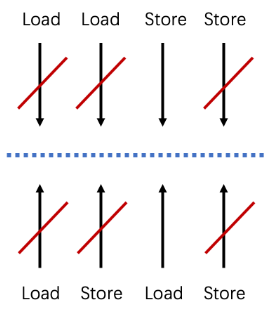
C++标准中,三种fence不禁止store-load(先写后读)的重排。
即便是std::atomic_thread_fence(memory_order_seq_cst)也一样,只是需要额外保证单独全序,但是在实际的实现上为了实现这个全序编译器大都是采用了硬件层面的能够阻止storeload重排的full barrier指令
参考资料:
https://paul.pub/cpp-memory-model/
https://blog.csdn.net/wxj1992/article/details/103917093
https://luyuhuang.tech/2022/06/25/cpp-memory-order.html
https://zhuanlan.zhihu.com/p/682286231
来自百度的介绍内存访问,分配,MESI,内存序优化的简短文章
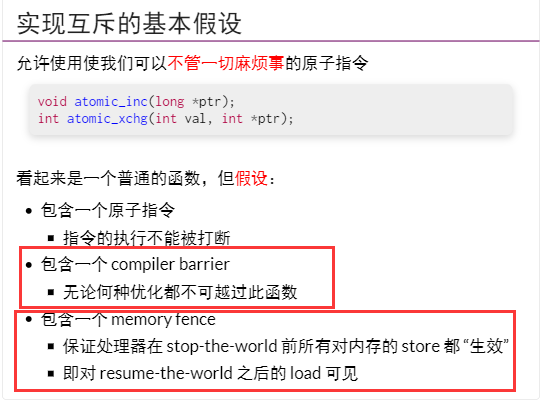
memory barrier 和 memory fence的细微区别
chatGPT的回答:
在C++11标准中,memory fence和memory barrier是等价的概念,它们都用于确保多线程环境下的内存可见性和顺序性。
在C++11之前,memory fence通常是指硬件级别的操作,而memory barrier则是指编译器级别的操作,但是这种区分在C++11之后已经不再重要。
在C++11中,memory fence和memory barrier都有两种类型:acquire和release。acquire fence/barrier用于确保之前的读操作在当前之后的操作之前执行,release fence/barrier用于确保之后的写操作在当前之前的操作之后执行。
区别在于,memory fence是一种完全的内存屏障,它会禁止编译器和CPU对内存操作的任何优化,强制所有线程按照特定的顺序执行内存操作。而memory barrier只是一种编译器屏障,它只能保证编译器不会对内存操作进行优化,但不能保证CPU不进行优化,因此在某些平台上可能不够稳定。所以memory barrier又称为 compiler barrier
此外,memory fence和memory barrier的使用需要根据具体的情况来确定。通常,只有在需要非常精细的内存控制时才需要使用memory fence和memory barrier,因为它们会影响程序的性能。在一般情况下,可以通过使用std::atomic类型来实现线程安全的操作,它会自动处理内存屏障和同步操作。
NULL和nullptr区别
其实NULL根据命名全大写可以看出来,它是一个常量,既然是常量,就需要进行宏定义。
- C语言的标准头文件是这样定义的
#define NULL ((void*)0) - 而到了C++中,则变成了
#define NULL 0
从定义中可以看出,C++中,NULL其实就是0,但是也可以用作空指针,只是用作空指针可能是为了兼容C,迫于无奈。
但是当NULL既可以表示0又可以表示空指针的时候,发生函数重载的时候就会有二义性
void test(void *p){ cout<<"p is pointer "<<p<<endl; }void test(int num){ cout<<"num is int "<<num<<endl;}int main(void){ test(NULL); //NULL是int还是指针? return 0;}很明显,NULL存在二义性,它既是整数,也是一个指针,函数test()无法根据参数的数据类型判断应该调用哪一个实现。 这时使用nullptr的优越性就体现出来了,因为它可以很好地把空指针这一层意思给剥离出来。nullptr就是C++11为了解决这个痛点而推出的东西。